inflearn logo
知識共有
inflearn logo

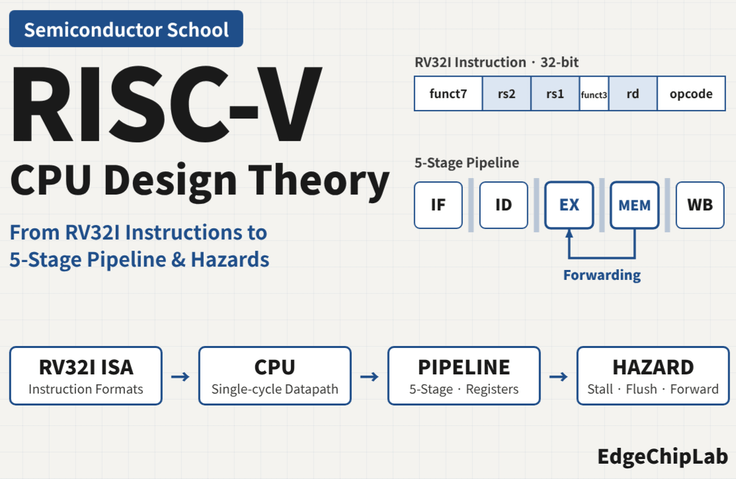
RISC-V CPU設計理論を完全解説 | RV32I命令から5段パイプライン、Hazardまで

RISC-V RV32I命令セットから5段パイプラインCPUの内部構造まで体系的に学習します。データパス、制御信号、パイプラインレジスタの動作原理と、フォワーディング、ストール、フラッシュなどのハザード処理メカニズムをサイクル単位で分析し、Verilog RTL設計とFPGA実装の理論的基盤を築きます。

1名 が受講中です。

難易度 中級以上

受講期間 無制限

Architecture
Architecture
cpu
cpu
riscv
riscv
system-design
system-design
risk-analysis
risk-analysis
Architecture
Architecture
cpu
cpu
riscv
riscv
system-design
system-design
risk-analysis
risk-analysis

受講後に得られること

  • RV32I命令形式と5段パイプラインCPUのデータパスおよび制御構造の設計原理

  • パイプラインレジスタを介したデータ転送と、フォワーディング、ストール、フラッシュによるハザード処理メカニズム

  • サイクルごとの命令実行分析によるCPUマイクロアーキテクチャの動作原理

RISC-V CPU設計理論を完成

RV32I命令から5段パイプライン、Hazardまで

CPUは命令をどのように実行するのでしょうか?

RISC-V命令を知っているからといって、CPU内部の動作まで理解しているとは限りません。

ADD命令を1つ実行するとき、CPUはどこからデータを読み取り、どの回路で演算し、結果をどこに保存するのでしょうか?

複数の命令が同時に実行されるパイプラインCPUでは、先行命令の演算結果がまだレジスタに保存されていないのに、次の命令がその値を必要とする場合、どうなるでしょうか?

この講義は、こうした疑問から始まります。

RISC-V RV32Iの命令構造からCPU Datapath、5-Stage Pipeline、Forwarding、Stall、Flushまで、CPUハードウェアの動作原理を段階的に解説する無料の理論講義です。

単に命令の種類を暗記したり、CPUの各ブロックの名称を紹介したりするのではなく、実際のCPU設計で使われるDatapathとControlの構造を中心に、命令が実行される過程を理解することを目的としています。


このような内容を学びます

SECTION 1. RISC-V RV32I命令構造とCPU実行原理

CPU設計の出発点であるISA(Instruction Set Architecture)を理解します。

RISC-VおよびRV32Iの基本概念、レジスタ構造、命令形式とエンコーディングを確認し、命令がCPUハードウェアにどのような動作を要求するのかを説明します。

  • RISC-V ISAとマイクロアーキテクチャの違い

  • RV32Iレジスタと命令形式

  • R型、I型、S型、B型、U型、J型

  • オペコードと即値のエンコーディング

  • 算術演算、ロード/ストア、分岐およびジャンプ

  • レジスタファイル、ALU、データパスと制御ユニット

  • Single-cycle CPUの基本的な実行原理

SECTION 2. RV32I 5段パイプラインCPUとデータパスの設計

命令を逐次処理する基本構造から、複数の命令を重ねて実行するパイプラインアーキテクチャへと拡張します。

実際の5段パイプラインCPUのデータパスを基準に、各ステージの役割とパイプラインレジスタを介したデータおよび制御信号の伝達過程を見ていきます。

  • シングルサイクルCPUとパイプラインCPUの違い

  • IF(命令フェッチ)

  • ID(Instruction Decode)

  • EX(実行)

  • MEM(メモリアクセス)

  • WB(Write-back)

  • IF/ID、ID/EX、EX/MEM、MEM/WBパイプラインレジスタ

  • ALUデータパスとライトバック経路

  • Control Signalの生成と伝達

SECTION 3. Pipeline Hazardと命令実行の分析

パイプラインCPUでは複数の命令が同時に進行するため、データ依存性や分岐処理の問題が発生します。

この講義では、これらの問題を解決するForwarding、Stall、Bubble、Flushの原理を説明し、実際のサンプルプログラムをサイクルごとに実行しながら、ハードウェアの動作を分析します。

  • データハザードとRAW(Read After Write)依存関係

  • フォワーディングユニットとForwardA/ForwardB

  • EX/MEMおよびMEM/WBフォワーディング

  • フォワーディングの優先順位

  • レジスタファイルのライトスルー

  • ロードユースハザードとストール

  • パイプラインバブル

  • 分岐、ジャンプおよびパイプラインフラッシュ

  • サイクルごとの命令実行分析

  • 複数の命令が重なって実行される統合事例


この講義の特徴

1. ISAからパイプラインまでを一つの流れとして学びます。

命令形式をまず理解し、その命令を実行するCPU Datapathを確認したうえで、複数の命令が同時に実行される際に発生する問題とその解決方法まで、一連の流れとして学びます。

2. 実際のCPUハードウェア構造を中心に説明します。

抽象的なコンピュータアーキテクチャの概念にとどまらず、Register File、ALU、Multiplexer、Pipeline Register、Forwarding Unit、Hazard Detection Unitなどの役割と相互のつながりを分析します。

3. Forwarding、Stall、Flushの違いを明確に区別します。

Forwardingは演算結果を直接渡す方法、Stallは命令の進行を一時的に停止する方法、Flushは誤った実行経路上の命令を無効化する方法です。

各機能がいつ必要で、どのように動作するのかを例とともに説明します。

4. サイクルごとの実行記録でパイプラインの動作を確認します。

命令が IF、ID、EX、MEM、WB を通過する過程を、Cycle 単位で分析します。

特に、データ依存性のある命令、Load-use Stall、Branch Flushなどが、実際のPipelineの進行にどのような影響を与えるかを見ていきます。

5. 実際のCPU設計演習へとつながります。

この講義は、CPUの構造と動作原理を理解するための理論講座です。

その後、Pythonベースの命令実行、Verilog RTL設計、Testbenchシミュレーション、FPGA実装へと学習を広げることができます。


この講義を受講すると、何ができるようになりますか?

講義を修了すると、次のような能力を身につけることができます。

  • RV32I命令の構造と実行原理を説明できます。

  • CPU Datapathでデータが移動する経路を分析できます。

  • 5段階パイプラインの各ステージとパイプラインレジスタの役割を区別できます。

  • Forwarding Unitがどの値を選択すべきか判断できます。

  • Load-use HazardでStallが必要な理由を説明できる。

  • BranchとJumpによるPipeline Flushの動作を理解できます。

  • 複数の命令の実行をサイクル単位で追跡できます。

  • VerilogベースのCPU設計演習を学ぶための、アーキテクチャの基礎を身につけることができます。


こんな方におすすめです

  • RISC-VとCPUアーキテクチャを基礎から体系的に学びたい大学生

  • デジタル論理回路を学び、CPU設計へと発展させたい学習者

  • コンピュータアーキテクチャの理論を実際の回路動作と結び付けて理解したい方

  • Verilog HDLを用いたCPU RTL設計に取り組もうとしている方

  • FPGAベースのRISC-V CPUの実装に関心のあるエンジニア

  • パイプラインハザードとフォワーディング、ストール、フラッシュの動作を正確に理解したい方

デジタル論理回路と、基本的なレジスタ、ALU、マルチプレクサの概念を知っていれば、よりスムーズに学習できます。


講義の構成および学習資料

本講義は全3セクション、全3本の動画で構成されています。

  • セクション 1: RISC-Vの基礎とCPUの実装 — Book 1

  • Section 2: RV32I 5-Stage Pipeline CPU Design — Book 2, Part 1

  • Section 3:RV32I 5段パイプラインCPU設計 — Book 2、Part 2

講義は技術図面と実行例を中心に進められ、理論の理解に重点を置いています。

本講義にはVerilog RTLの記述およびFPGAボードへの実装演習は含まれていません。これらの内容は後続の実習課程で扱います。


次のステップ:実際にRISC-V CPUを設計してみましょう

CPUの動作原理を理解したら、次のステップは自分で実装することです。

Semiconductor SchoolのInflearn実習講座は、以下のように構成されています。

① FPGA実装のためのRISC-V CPU設計 — Pythonで学ぶRV32I命令の構造と実行原理

Pythonを活用して、RV32I命令の構造と実行過程を学ぶコースです。

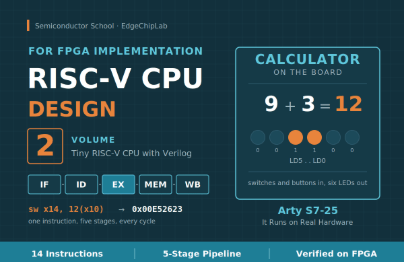
② FPGA実装のためのRISC-V CPU設計 — 5段パイプラインTinyRV32Iを自作する

Verilog HDLで5段パイプラインCPUを設計し、シミュレーションからFPGA実装へと発展させるコースです。

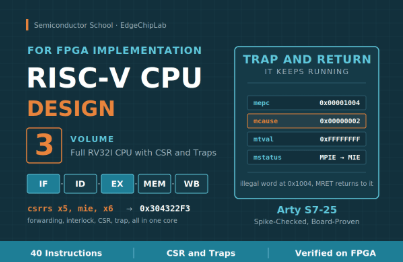
③ FPGA実装に向けたRISC-V CPU設計 — RV32Iの40命令に対応したフルCPUを自作

RV32Iの全40命令をサポートするCPUを設計・検証する応用コースです。

その後、「AMBA AXI4バス設計とFPGA実装 — RTLからシステム統合まで」の講義を通じて、CPU設計からバスインターフェースやシステム統合へと学習範囲を広げることができます。

RISC-V ISA → CPUアーキテクチャ → RTL設計 → シミュレーション → FPGA実装 → システム統合


知識共有者の紹介

Roger Kim | Semiconductor School

サムスン電子DS部門に約30年間勤務し、現在は崇実大学校の次世代半導体学科で、半導体およびデジタルハードウェア設計に関する教育を行っています。

RISC-V CPU、FPGA、AI NPU、AMBA AXI4バスおよびSoC設計などを中心に、ハードウェアの動作原理から実際の実装・検証までをつなぐ教育コンテンツを制作しています。

著書:RISC-V RV32I: From Fundamentals to FPGA Implementation(Amazon刊行)

Semiconductor School — アーキテクチャを学び、ハードウェアを作ろう。

こんな方に
おすすめです

学習対象は
誰でしょう?

  • RISC-VベースのCPU設計を初めて始める、コンピュータ工学専攻の大学生

  • デジタル論理回路とVerilog HDLを学習した後、FPGA CPUの実装に向けて準備している学習者

  • コンピュータアーキテクチャの理論を実際のハードウェア設計と結びつけようとする組み込みエンジニア

前提知識、
必要でしょうか?

  • デジタル論理回路の基礎知識(組み合わせ回路、順序回路、レジスタ)

  • コンピュータアーキテクチャの基本概念(命令、レジスタ、メモリ、ALU)

  • ハードウェア記述言語(HDL)またはCPU設計への関心と学習意欲

こんにちは
EdgeChipLabです。

キャリア認証

"AI時代、最も確実な対応は自分で直接AI半導体を作ることです。"

この講座は、理論中心の一般的な大学講義でも、特定のスペックに合わせることにとどまる契約学科の標準化されたカリキュラムでもありません。また、従来の断片化された実務セミナーのように、単なるEDAツールの使用経験やライブラリの活用にとどまるものでもありません。

サムスン電子DS部門のシステム半導体研究員としてキャリアをスタートし、設計自動化分野でサムスン技術賞銀賞(グループ会長賞)を受賞、英国・ドイツ法人のDirectorおよびシステムLSIマーケティング・営業グループ長を歴任した30年のキャリアを持つ現職の工学教授が自ら設計し、FPGAで検証した他に類を見ない実践型コースです。

[ 現役社員&エンジニアを目指す方のための核心的な差別化ポイント ]

  • 現役エンジニアの限界を克服:単にコードを修正したり既製IPを流用したりするレベルを超え、NPUとCPUをRTLで直接設計するアーキテクチャレベルの実務能力を身につけます。

  • Full-Flow実務体制の構築:AIアルゴリズムの分析からFPGA実装、Bit-Trueハードウェア連携検証、さらにCPU + NPU + RTOSベースのAI SoC拡張まで、バリューチェーン全体を完遂します。

  • 現場検証済み:大学の講義室で学ぶ理論を超え、実務の最前線における設計ノウハウを集約し、すぐに実務へ適用できる実証済みのプロセスを提供します。

AIアルゴリズム → RTL設計 → FPGA実装 → ビット・トゥルー検証 → AI SoC

学部生・大学院生はもちろん、次世代AI半導体/SoC設計者として飛躍したい現役実務者にも、他では得られない最高の実践ガイドを提供します。


理論を超えて実際のAIハードウェア実装へ

断片的な知識だけでは、システムレベルのAI半導体設計能力に到達するのは困難です。

受講生は完成したブラックボックスIPを使用するだけにとどまりません。AI NPUとRISC-V CPUを自ら設計し、メモリと周辺機器を統合したうえで、その上にRTOSをポーティングし、最終的に独自のAI SoCを構築できるシステム設計能力を段階的に身につけることを目標とします。

トランジスタとデジタル回路の基礎から始め、FPGA、CPU、NPUを経て、TransformerとLLMのアクセラレーションハードウェアまでつなげます。


研究成果を実際のFPGAハードウェアで検証します。

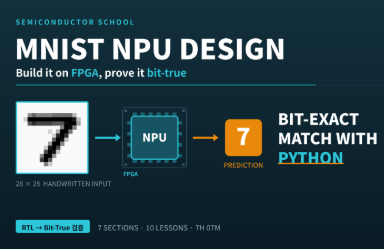
目で見るだけの講義ではありません。理論や単なるシミュレーションで終わらせず、自ら設計したAI半導体回路を実際のFPGAで動作させ、PythonモデルとRTLの結果が1ビットまで一致するBit-True検証を実施します。

講師のAI半導体・FPGA・RISC-V関連のKCI掲載論文4編を含む研究成果も教育コンテンツと結び付け、研究で検証した技術を実際の設計とFPGA実装へとつなげます。独自開発したRISC-V CPUをはじめ、画像学習用のPythonコードやVerilog RTLなど、実習に必要なソースコードを公開します。

手頃なArty S7-25 FPGAボードと無料のVivado設計ツールを中心に構成し、学習者が自ら設計・実装・検証する全過程を再現できるようにしました。また、Zybo Z7を含むDigilent社のFPGAボードでも使用できます。XDCピンマッピング(ボード)とクロック分周パラメータ(RTL)をボードに合わせて修正してください。「FPGAで作るMNIST NPU」講義はXDCピンマッピングのみ修正すればよく、OLEDとCameraを使用する講義ではクロック分周パラメータ(RTL)を修正します。

→講義の実習では、Arty S7の100 MHz入力クロックを基準に分周パラメータが設定されています。他のボードは入力クロックが異なるため(例:Zybo Z7は125 MHz)、目標周波数が同じになるように分周値を再計算していただく必要があります。 この部分を見落とすと画面や映像が正常に出力されませんが、コードのエラーと誤解しやすいため、ご確認ください。


断絶のないフルスタックロードマップ:基礎からmini LLMアクセラレーターまで

すべての講義は独立した断片ではなく、一つの巨大なシステムを完成させていく旅です。

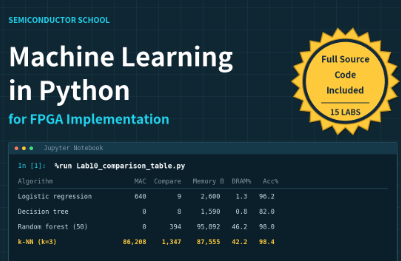
  • Step 1: AI理論および画像処理の基礎(Machine Learningを含む)

  • Step 2: AIアクセラレータ(NPU)の設計および検証(Machine Learningを含む)

  • Step 3: RISC-V CPU設計およびシステム統合

  • Step 4: 高度AI SoCの実装およびmini LLMアクセラレーションプラットフォームへの拡張(継続的なコンテンツ更新)


客観的な検証指標

本コースのすべての設計成果物は、グローバル標準および学界による厳格な検証を経ています。

  • RISC-Vアーキテクチャ検証:独自開発のRISC-V CPUが国際財団公式コンプライアンステスト(ACT)に合格し、ソースコードを公開(GitHub)

  • 学術的権威:単独著者による学術論文4本(KCI Aランクの著名学術誌IJIBC)

  • グローバルな評価:Amazonで技術書4冊を出版(ベストセラー1位を達成)


    出版書籍: Roger Kim: books, biography, latest update

  • 実動作検証完了:RV32I CPU、NPU、ビジョンシステム、GPS、Transformer、AURA-Edge SoCなどの主要IPがArty S7環境で完全動作


挑戦してください。実際にコードをボードに書き込み、結果を確認するこのプロセスを終える頃には、皆さんは以前とはまったく異なる視野を持つハードウェアエンジニアへとレベルアップしていることでしょう。

もっと見る

カリキュラム

全体

3件 ∙ (2時間 37分)

講座掲載日: 
最終更新日: 

受講レビュー

まだ十分な評価が集まっていない講座です。
ぜひ最初のレビューをお寄せください。

EdgeChipLabの他の講座

知識共有者の他の講座はこちら

似ている講座

同じ分野の他の講座を見てみましょう!

期間限定セール

¥19,250

30%

¥3,570