Vivado・PythonベースのFPGA・NPU・CPU設計環境構築
EdgeChipLab
無料
入門 / Python, FPGA, jupyter-notebook, vivado
New
New
この講座は、FPGAおよびNPU設計の実習に必要なAMD VivadoとPythonの開発環境を、ゼロから自分で構築する無料講座です。

入門
Python, FPGA, jupyter-notebook

AI半導体の中核となる並列演算構造であるSystolic ArrayをVerilogで直接実装し、Vivadoシミュレーションで検証する無料の実習講座です。3×3 Output-Stationary構造を例に、Processing Elementの設計からInput Skewing、Wavefront解析、Testbench検証までを段階的に学習し、FPGAボードなしでもAI NPUの基本的な演算原理を完全に理解できます。
1名 が受講中です。
難易度 初級
受講期間 無制限
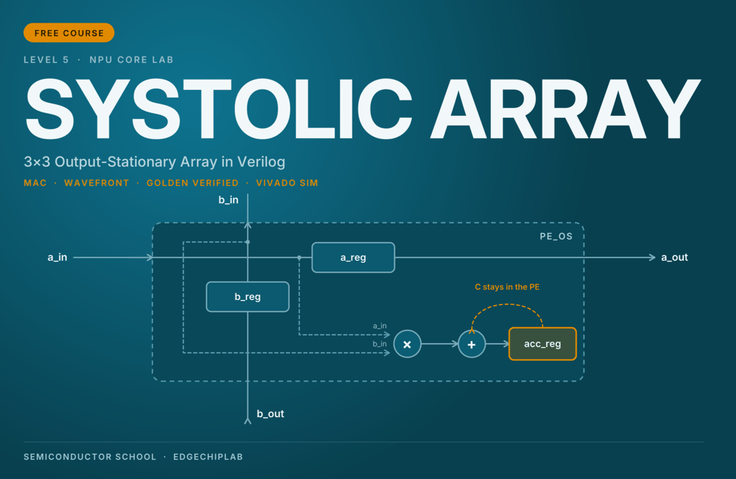
Systolic Arrayの並列演算原理とPE間のデータフロー分析
Verilog RTLを用いた3×3 PEアレイおよびMAC演算器の設計
VivadoシミュレーションとGolden Referenceに基づくハードウェア検証
AI半導体の並列演算構造を、Verilogで自ら実装し、検証してみましょう!
AI半導体の核心は、数多くの乗算と加算を高速かつ効率的に処理することです。
一般的な逐次演算方式とは異なり、AI NPUは複数の演算器を並列に配置してデータを同時に処理します。このような並列演算を実装する代表的なハードウェア構造がSystolic Array(シストリックアレイ)です。
本講座では、3×3 Systolic Arrayを実際のVerilog RTLで実装し、Vivadoシミュレーションを通じて動作を検証する過程を学びます。
単にコードを説明するだけでなく、データがProcessing Element(PE)間をどのように移動するのか、各PEがどのサイクルで演算するのか、最終結果が正確であるかを段階的に確認します。
FPGAボードなしでVivadoだけを使って学べる無料のAI NPU設計実習講座です。
3×3 Output-Stationary Systolic Arrayの実装
Systolic Arrayの基本構造と並列行列積演算の原理を学習します。
Output-Stationary構造では、入力データAと重みBがPE間を移動し、乗算結果は各PE内部のアキュムレータに格納されます。
Systolic ArrayとOutput-Stationary Dataflow
Processing Element(PE)とMAC演算構造
入力データのForwardingとローカルAccumulation
符号付き/符号なしデータ処理
Generate構文を用いた3×3 PE Arrayの構成
Input Skewing、WavefrontおよびTestbenchの実装
Systolic Arrayでは、データを単純に同時入力するのではなく、各PEに必要なデータが正確なタイミングで到着するように入力タイミングを調整します。
このようなInput SkewingとWavefrontの原理を理解し、Testbenchを通じてデータフローを観察します。
Input Skewingとデータ到着タイミング
対角線方向に進むWavefront
PEごとの演算開始時点とアクティブ区間
Testbenchを用いた入力データ注入
Golden Referenceを活用した自動検証構造
Golden Dataの検証、性能分析およびNPU拡張
Vivadoシミュレーションを実行し、3×3行列積の結果がExcelで計算したGolden Matrixと一致するか確認します。
9個のPEが7サイクルにわたって演算する過程を分析し、並列演算の特徴を理解します。
Vivado Behavioral Simulation
シミュレーションログと波形解析
Fill、Peak、Drain各段階におけるPEの動作
7サイクルのWavefrontとPE Utilization
Golden Matrixの比較およびtotal_errors = 0の確認
パラメトリックアレイ構造と拡張概念
Quad-CoreおよびCIFAR-10 NPU応用構造の紹介
1. AI NPUの中核演算構造を理解
Systolic Arrayが複数のPEを使用して行列積を並列処理する原理を理解できます。
2. 実際のVerilog RTL設計構造を学ぶ
PE、MAC、Forwarding Register、Generate文を活用して、並列演算ハードウェアを構成する方法を学びます。
3. サイクル単位のハードウェア動作分析能力
Input SkewingとWavefrontを理解し、シミュレーションログと波形を通じてPEごとの演算プロセスを追跡できます。
4. Golden Referenceに基づく検証方法の理解
RTLシミュレーション結果をExcel Golden Matrixと比較し、ハードウェア演算の正確性を検証する方法を学習します。
5. AI NPUの高度設計に向けた基礎能力
3×3 Systolic Arrayを出発点として、より大規模なPE ArrayとマルチコアNPUアーキテクチャへの拡張概念を理解できます。
Verilog-HDLの基礎を学習し、実際のハードウェア設計例を体験したい方
AI半導体とNPUの内部演算構造に興味がある大学生および初心者
FPGAを活用した並列演算およびデジタル回路設計に関心のある方
MAC、Processing Element、Systolic Arrayの動作原理を理解したい方
VivadoシミュレーションとTestbenchに基づく検証を学びたい方
今後、AI NPU、CNNアクセラレータ、およびFPGAベースのAIシステム設計に挑戦したい方
推奨される前提知識
デジタル論理回路の基本概念
Verilog-HDLのModule、Always、RegisterおよびGenerate構文
Clockベースの順序回路の動作原理
行列乗算の基本概念
実習環境
Xilinx Vivado(ビヘイビア・シミュレーション)
提供されるVerilog RTLおよびTestbenchソースコード
FPGAボード不要
本講座はシミュレーション中心の実習であり、FPGAボードへの実装とタイミング・クロージャは含まれません。
本講座は、EdgeChipLabの段階的なFPGA・AI半導体教育課程のうち、Systolic Arrayの実装を扱う実習コースです。
Verilog-HDLの文法に慣れていない方は、無料講座「デジタル半導体設計のためのVerilog-HDL入門」を先に受講することをおすすめします。
また、Systolic Arrayの並列演算の原理を十分に理解するには、前提理論講座である「NPU Systolic PE構造の理解」も併せて学習するとよいでしょう。
その後は、EdgeChipLabが提供するさまざまなFPGA設計およびAI NPU実習コースへと学習を広げることができます。
Verilogコードが実際の並列演算ハードウェアとして動作する過程を、今回の無料講座で直接確認してみてください。
半導体スクール | EdgeChipLab
学習対象は
誰でしょう?
Verilog-HDLの基礎を身につけ、実際のRTL設計例を体験したいハードウェア初心者
AI半導体とNPUの内部演算構造に関心がある電気電子工学専攻の大学生
FPGAベースの並列演算ハードウェア設計とCNNアクセラレータ開発を目指すエンジニア
前提知識、
必要でしょうか?
デジタル論理回路の基本概念とクロックベースの順序回路の動作原理
Verilog-HDLの基本文法およびモジュール設計経験
行列乗算の基礎概念とXilinx Vivadoシミュレータの使用環境
キャリア認証
現職の大学教授として、システム半導体業界で30年間培った経験とAI半導体の研究・教育ノウハウを盛り込みました。
サムスン電子DS部門のシステム半導体研究員を皮切りに、英国およびドイツ法人のDirector、システムLSIマーケティング・営業グループ長を経て、現在は半導体工学を教える教授が自ら設計し、FPGAで検証した実践型カリキュラムです。
単にFPGAの使い方を学ぶ教育ではありません。
AIアルゴリズムを理解し、→ NPUとCPUをRTLで自ら設計し、→ FPGAに実装し、→ 実際のハードウェアで検証し、→ 最終的にAI SoCまで拡張するプロセスを目指します。
AIアルゴリズム → RTL設計 → FPGA実装 → ビット真値検証 → AI SoC
断片的で散在した知識だけでは、システムレベルのAI半導体設計能力に到達するのは困難です。
受講生は完成したブラックボックスIPを使用するだけにとどまりません。AI NPUとRISC-V CPUを自ら設計し、メモリや周辺機器を統合し、最終的に自分だけのAI SoCを構築できるシステム設計能力を段階的に身につけることを目標とします。
トランジスタとデジタル回路の基礎から始め、FPGA、CPU、NPUを経てTransformerとLLMのアクセラレーションハードウェアまでつなげます。
目で見るだけの講義ではありません。理論や単なるシミュレーションで終わらせず、自ら設計したAI半導体回路を実際のFPGAで動作させ、PythonモデルとRTLの結果が1ビットまで一致するBit-True検証を実施します。
講師のAI半導体・FPGA・RISC-V関連のKCI収載論文4編を含む研究成果も教育コンテンツと関連付け、研究で検証した技術を実際の設計とFPGA実装へとつなげます。
独自開発したRISC-V CPUをはじめ、画像学習用のPythonコードやVerilog RTLなど、実習に必要なソースコードを公開します。
普及価格帯のArty S7-25 FPGAボードと無料のVivado設計ツールを中心に構成し、学習者が自ら設計・実装・検証する全工程を再現できるようにしました。
また、Zybo Z7を含むDigilent社のFPGAボードでも使用できます。XDCピンマッピング(ボード)とクロック分周パラメータ(RTL)をボードに合わせて修正してください。
'FPGA로 만드는 MNIST NPU'講義はXDCピンマッピングのみを修正すればよく、OLEDとCameraを使用する講義ではクロック分周パラメータ(RTL)を修正する必要があります。
→講義の実習は、Arty S7の100 MHz入力クロックを基準に分周パラメータが設定されています。ほかのボードは入力クロックが異なるため(例:Zybo Z7は125 MHz)、目標周波数が同じになるように分周値を再計算してください。この部分を見落とすと画面や映像が正常に出力されませんが、コードのエラーと誤解しやすいため、ご確認ください。
すべての講義は独立した断片ではなく、一つの巨大なシステムを完成させていく旅です。
Step 1: AI理論および画像処理の基礎(Machine Learningを含む)
Step 2: AIアクセラレータ(NPU)の設計および検証(Machine Learningを含む)
Step 3: RISC-V CPU設計およびシステム統合
Step 4: 高度AI SoCの実装およびmini LLMアクセラレーションプラットフォームへの拡張(継続的なコンテンツ更新)
本コースのすべての設計成果物は、グローバル標準および学界による厳格な検証を経ています。
RISC-Vアーキテクチャ検証:独自開発のRISC-V CPUが国際財団公式コンプライアンステスト(ACT)に合格し、ソースコードを公開(GitHub)
学術的権威:単独著者による学術論文4本(KCI Aランクの著名学術誌IJIBC)
グローバルな評価:Amazonで技術書4冊を出版(ベストセラー1位を達成)
実動作検証完了:RV32I CPU、NPU、ビジョンシステム、GPS、Transformer、AURA-Edge SoCなどの主要IPがArty S7環境で完全動作
挑戦してください。実際にコードをボードに書き込み、結果を確認するこのプロセスを終える頃には、皆さんは以前とはまったく異なる視野を持つハードウェアエンジニアへとレベルアップしていることでしょう。
YouTube:@EdgeChipLab
Homepage: Semiconductor School
GitHub(ソースコードおよびプロジェクト):github.com/estlit
全体
3件 ∙ (15分)
知識共有者の他の講座はこちら
同じ分野の他の講座を見てみましょう!
無料