「AI時代、最も確実な対応は、自分でAI半導体を作ることです。」
この課程は、理論中心の一般的な大学講義でも、特定の仕様に合わせるだけにとどまる契約学科の標準化されたカリキュラムでもありません。また、従来の断片的な実務セミナーのように、EDAツールの使用経験やライブラリの活用だけにとどまるものでもありません。
Samsung Electronics DS部門のシステム半導体研究員としてキャリアをスタートし、設計自動化分野でSamsung技術賞の銀賞(グループ会長賞)を受賞。英国・ドイツ法人のDirectorおよびSystem LSIのマーケティング・営業グループ長を歴任した30年のキャリアを持つ現役の工学教授が自ら設計し、FPGAで検証した、他に類を見ない実践型コースです。
【現職者 & エンジニア志望者のための主な差別化ポイント】
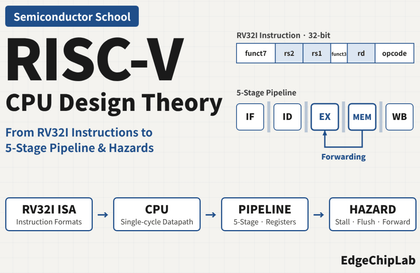
アーキテクチャ設計能力—既製IPの接続やコードの修正ではなく、RV32I five-stage Pipeline(IF・ID・EX・MEM・WB)を、Data Hazard Forwarding、Load-Use Stall、Branch処理まで含めてRTLで直接設計。5段階のPipelineを理解し、直接扱える点が設計能力を大きく差別化します。
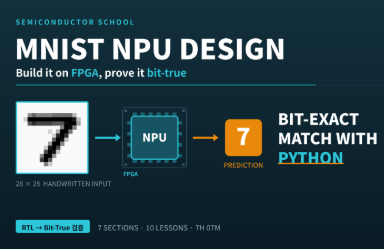
AlgorithmからRTLまで— MNIST CNNをPythonモデルからQuantizationを経てNPU RTLとして実装し、同じ入力に対するPythonの結果とハードウェアの結果がBit-Trueで一致するかを確認します。PythonとVerilogで結果が100%一致し、FPGAの実機動作結果を作り出すことが重要です。
CPU + NPU + RTOSを単一FPGAに統合 — 自ら設計したCPUが自ら設計したNPUを駆動し、その上でEdgeChipLabが独自に実装したFreeRTOSが動作する構成を、1つのデバイスに実装します。受講生は、公開されているすべてのRTLとコードリソースを使って、自分だけの半導体チップを作ることができます。
AI Algorithm → RTL Design → FPGA Implementation → Bit-True Verification → AI SoC
学部生・大学院生はもちろん、次世代AI半導体/SoC設計者への飛躍を目指す現役エンジニアにも、他に代えがたい最高の実践ガイドを提供します。
理論を超えて、実際のAIハードウェア実装へ
断片的な知識だけでは、システムレベルのAI半導体設計能力を身につけるのは困難です。
受講生は、完成されたブラックボックスIPを使うだけにとどまりません。AI NPUと5-stage Pipeline RISC-V CPUを自ら設計し、メモリと周辺機器を統合したうえで、その上にRTOSを移植し、最終的に独自のAI SoCを構築できるシステム設計能力を段階的に身につけることを目指します。
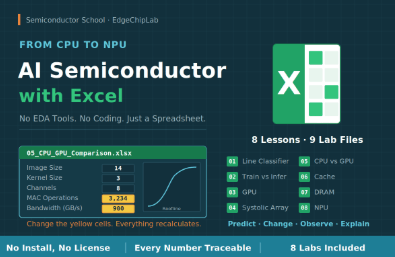
トランジスタとデジタル回路の基礎から始め、FPGA、CPU、NPUを経て、TransformerやLLMアクセラレーションハードウェアまでつなげます。
研究成果を実際のFPGAハードウェアで検証します。
目で見るだけの講義ではありません。理論や単なるシミュレーションで終わらせず、自ら設計したAI半導体回路を実際のFPGA上で動作させ、PythonモデルとRTLの結果が1ビットまで一致するBit-True検証を行います。
講師のAI半導体・FPGA・RISC-V関連のKCI掲載論文4本を含む研究成果も教育コンテンツと連携させ、研究で検証した技術を実際の設計やFPGA実装へとつなげます。独自開発のRISC-V CPUをはじめ、画像学習用のPythonコードやVerilog RTLなど、実習に必要なソースコードを公開します。
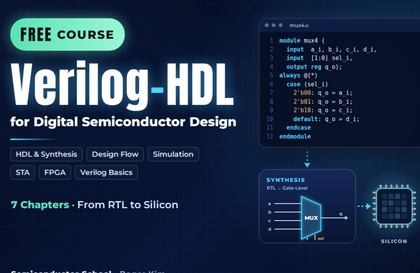
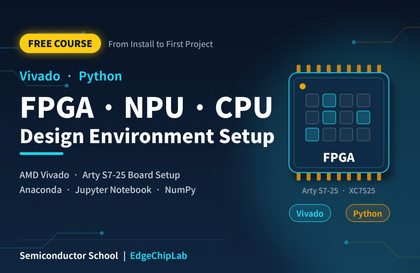
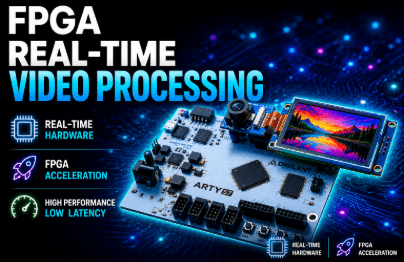
エントリー向けのArty S7-25 FPGAボードと無料のVivado設計ツールを中心に構成し、学習者が設計・実装・検証の全工程を自ら再現できるようにしました。また、Zybo Z7を含むDigilent社のFPGAボードでも使用できます。XDCのピンマッピング(ボード)とクロック分周パラメータ(RTL)を、使用するボードに合わせて変更してください。「FPGAで作るMNIST NPU」講義ではXDCのピンマッピングのみを変更し、OLEDとCameraを使用する講義ではクロック分周パラメータ(RTL)を変更します。
→講義の演習では、Arty S7の100 MHz入力クロックを基準に分周パラメータが設定されています。別のボードでは入力クロックが異なるため(例:Zybo Z7は125 MHz)、目標周波数が同じになるよう分周値を再計算してください。この点を見落とすと、画面や映像が正常に出力されませんが、コードのエラーと誤解しやすいため、ご確認ください。
途切れのないフルスタックロードマップ:基礎からmini LLMアクセラレーターまで
すべての講義は独立した断片ではなく、一つの巨大なシステムを完成させていく旅路です。
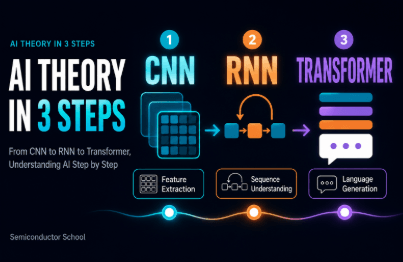
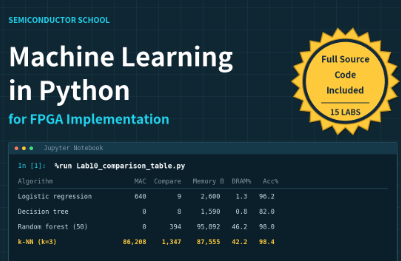
Step 1:AI理論および画像処理の基礎(Machine Learningを含む)
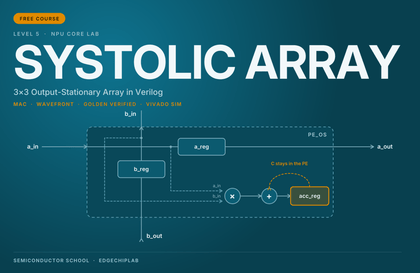
Step 2:AIアクセラレータ(NPU)の設計および検証(Machine Learningを含む)
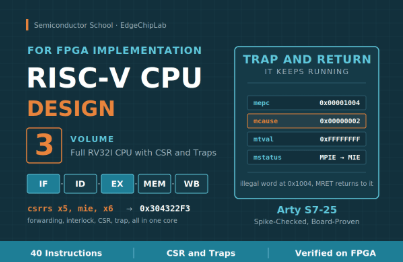
Step 3:5-stage Pipeline RISC-V CPU設計およびシステム統合
Step 4: 高度なAI SoCの実装とmini LLMアクセラレーションプラットフォームへの拡張(コンテンツを継続的に更新)
客観的な検証指標
本講座のすべての設計成果物は、グローバル標準および学界による厳格な検証を経ています。
5-stage Pipeline RISC-Vアーキテクチャの検証:独自開発のRISC-V CPUが国際財団の公式コンプライアンステスト(ACT)に合格し、ソースコードを公開(GitHub)
学術的権威:単独著者による学術論文4編(KCI Aランクの著名学術誌IJIBCに掲載)
グローバルな評価:Amazonで技術書を4冊出版(ベストセラー1位を達成)
出版書籍:Roger Kim: books, biography, latest update
実動作検証完了:RV32I CPU、NPU、ビジョンシステム、GPS、Transformer、AURA-Edge SoCなどのコアIPがArty S7環境で完全動作】【。
挑戦してください。実際にコードをボードに書き込み、結果を確認するこのプロセスが終わる頃には、皆さんは以前とはまったく異なる視点を持つハードウェアエンジニアへとレベルアップしているでしょう。