inflearn logo
知識共有
inflearn logo

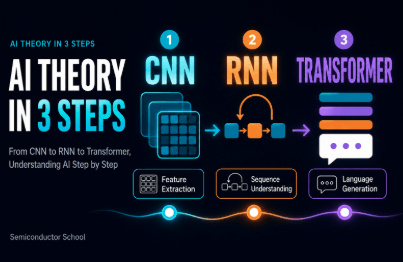
AI半導体設計のための必須理論 ― ニューロンからLLMまで

NPU・トランスフォーマーアクセラレータ・mini LLMのようなAI半導体を自ら設計するには、その内部で演算がなぜ行われるのかを理論的に理解する必要があります。この講義では、1つのニューロンからCNN・トランスフォーマー・LLMまで、ハードウェア設計に不可欠な理論のエッセンスだけを抜き出し、全3回に凝縮しました。数式の暗記ではなく「なぜそうなるのか」という直感を通じて、半導体業界で30年の経験を持つ現役教授が、ソフトウェア理論とハードウェア実装を一つにつなぎます。

難易度 入門

受講期間 無制限

Deep Learning(DL)
Deep Learning(DL)
Machine Learning(ML)
CNN
CNN
transformer
transformer
LLM
LLM
Deep Learning(DL)
Deep Learning(DL)
Machine Learning(ML)
CNN
CNN
transformer
transformer
LLM
LLM

受講後に得られること

  • ニューロン・ニューラルネットワーク・CNN・トランスフォーマー・LLMの動作原理を直感的に理解する能力

  • 学習・勾配降下法・量子化など、AIハードウェア設計に必要な核心的理論基盤

  • ChatGPT・GPT・BERTがどのように作られるのか、その原理レベルでの理解

  • AI理論が実際の半導体回路(NPU・アクセラレータ)へどのようにつながるのかを見る全体像

  • その後のAIアクセラレータ・NPU設計実習を理解しながら進められる理論的基盤

■ なぜこの講義が必要なのか

NPU、トランスフォーマーアクセラレーター、mini LLM――こうしたAI半導体を自ら設計するには、その内部でどのような演算がなぜ行われるのか、そしてその演算がチップ上で何を代償として支払うのかを理解していなければなりません。回路をただ追って描くだけでは、限界に突き当たります。

この講義では、その理論的基盤を本当に必要なエッセンスだけに絞り、3部に凝縮しました。1つのニューロンの掛け算から始まり、CNN、アテンション、トランスフォーマー、LLMまで――膨大なAI理論の中から'ハードウェア設計に実際に必要なもの'だけを選んで収録しています。

そのため、各部では半導体設計とのつながりを説明します。

第1部では、ニューラルネットワークの掛け算・足し算がチップ上ではそのまま電力になるという事実を通じて、

第2部は、アテンションの行列演算がシストリックアレイという専用アクセラレータを必要とするという事実から、

第3部は、電力のかなりの部分が演算ではなくデータ移動に使われているという事実で締めくくられます。

学術的な深さのための理論ではなく、AI半導体を自ら作るための理論です。


■ この講義が他と異なる理由

市販のAI理論講座は、ソフトウェアと数学の観点で止まっています。この講座は、最初から'ハードウェアとして実装するための理論'を目指しています。ニューロンの掛け算・足し算がチップ上でどのように電力消費につながるのか、なぜトランスフォーマーの行列演算が専用アクセラレーター(NPU)を必要とするのか、なぜ低消費電力AI半導体が未来なのか――AI理論を半導体設計者の視点から解き明かします。半導体業界で30年の経験を持つ現役教授が、ソフトウェア理論とハードウェア実装を一つにつなぎます。


■ この講義は出発点です

この講義は、これから続くハードウェア設計講義の理論的な出発点です。

· この講義(理論)→ NPU設計 → トランスフォーマーアクセラレータ → mini LLM SoC

ここで築いた理論があってこそ、以降の講義で 'なぜこの回路がこのように設計されるのか'を理解しながらついてくることができます。逆に、理論なしに回路だけを見ていると暗記になってしまい、応用できません。


■ 3部構成

· 第1部 ニューロンからCNNまで — 学習の原理(勾配降下法)、パーセプトロンとXORの壁、深層ニューラルネットワーク(DNN)、畳み込みニューラルネットワーク(CNN)

· 第2部 RNNからTransformerまで — シーケンシャルデータとRNN、単語埋め込み、アテンションメカニズム、トランスフォーマー

· 第3部 TransformerからLLMへ — 事前学習・転移学習、BERTとGPT、ChatGPTとRLHF、そして低消費電力半導体へ

3編は一つにつながる物語です。順番に学習していけば、ニューロンからLLMに至る全体像が完成します。


■ このような方におすすめします

·今後、NPU・AIアクセラレータ・AI SoCを自ら設計したい方(その理論を土台として)

· AIハードウェア設計の講義を受ける前に、背景理論を凝縮して身につけたい方

· AIを原理から理解したいものの、学術的な深さよりも「作るための核心」を求める方

・用語(CNN・アテンション・トランスフォーマー・LLM)は聞いたことがあるものの、動作原理をつかめていない方


■このような講座です

· ハードウェア設計に必要な理論だけを厳選 — 膨大なAI理論のエッセンス

· 数式の暗記ではなく直感を重視 — 'なぜそうなるのか'を図やたとえで

· 1つのニューロンからLLMまで、途切れることなくつながる一つの物語

· AI理論と半導体ハードウェアをつなぐ、めったにない視点

· 別途の実習・ボード・インストールなしで、動画だけで完走可能


■ 参考

· 本講義は理論編です。FPGAで実際にAIアクセラレータを制作する実習は、別の講義で扱います。本講義の理論が、それらの実習講義の土台となります。

· 本講義のすべての内容は講師が制作し、ナレーション(音声)はTTSで作成されています。

こんな方に
おすすめです

学習対象は
誰でしょう?

  • これからNPU・AIアクセラレータ・AI SoCを自ら設計したいが、理論的な基盤がない方

  • AIハードウェア設計の講義を受講する前に、基礎理論をエッセンスとしてしっかり固めておきたい】【。

  • CNN・アテンション・トランスフォーマー・LLMという用語は知っているけれど、動作原理がつかめない方

  • AIを原理から理解したいけれど、学問的な深さよりも'作るための核心'を求める方

前提知識、
必要でしょうか?

  • 特別な選手の知識がなくても理解できるよう、直感を重視して説明します

  • 高校レベルの数学(関数・グラフ)の知識があると、より理解しやすくなります

  • コーディング・実習は必要ありません(理論編)

こんにちは
EdgeChipLabです。

キャリア認証

AI半導体をFPGAで直接設計・実装します

現職の大学教授として、システム半導体業界で30年にわたり培った経験と、AI半導体の研究・教育ノウハウを凝縮しています。

サムスン電子DS部門のシステム半導体研究員としてキャリアをスタートし、設計自動化分野でサムスン技術賞銀賞(グループ会長賞)を受賞しました。その後、英国・ドイツ法人のDirector、システムLSIマーケティング・営業グループ長を経て、現在は半導体工学を教えています。このカリキュラムは、そうした経験をもとに自ら設計し、FPGAで検証した実践型のコースです。

単にFPGAの使い方を学ぶ教育ではありません。
AIアルゴリズムを理解し、→ NPUとCPUをRTLで自ら設計し、→ FPGAに実装し、→ 実際のハードウェアで検証し、→ 最終的にはAI SoCまで拡張するプロセスを目指します。

AIアルゴリズム → RTL設計 → FPGA実装 → ビット真値検証 → AI SoC


理論を超え、実際のAIハードウェア実装へ

断片的で散在した知識だけでは、システムレベルのAI半導体設計能力に到達するのは困難です。

受講生は完成したブラックボックスIPを使用するだけにとどまりません。AI NPUとRISC-V CPUを自ら設計し、メモリと周辺機器を統合するとともに、その上にRTOSを移植し、最終的には自分だけのAI SoCを構築できるシステム設計能力を段階的に身につけることを目標とします。

トランジスタとデジタル回路の基礎から始め、FPGA、CPU、NPUを経て、TransformerとLLMのアクセラレーションハードウェアまでつなげます。


研究成果を実際のFPGAハードウェアで検証します。

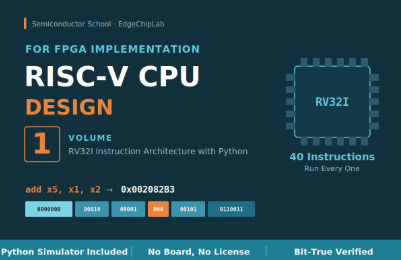
目で見るだけの講義ではありません。理論や単なるシミュレーションで終わらせず、自ら設計したAI半導体回路を実際のFPGAで動作させ、PythonモデルとRTLの結果が1ビットまで一致するBit-True検証を実施します。

講師のAI半導体・FPGA・RISC-V関連のKCI収載論文4編を含む研究成果も教育コンテンツと関連付け、研究で検証した技術を実際の設計とFPGA実装へとつなげます。

独自開発したRISC-V CPUをはじめ、画像学習用のPythonコードやVerilog RTLなど、実習に必要なソースコードを公開します。

普及価格帯のArty S7-25 FPGAボードと無料のVivado設計ツールを中心に構成し、学習者が自ら設計・実装・検証する全工程を再現できるようにしました。

また、Zybo Z7を含むDigilent社のFPGAボードでも使用できます。XDCピンマッピング(ボード)とクロック分周パラメータ(RTL)をボードに合わせて修正してください。

'FPGA로 만드는 MNIST NPU'講義はXDCピンマッピングのみを修正すればよく、OLEDとCameraを使用する講義ではクロック分周パラメータ(RTL)を修正する必要があります。

→講義の実習は、Arty S7の100 MHz入力クロックを基準に分周パラメータが設定されています。ほかのボードは入力クロックが異なるため(例:Zybo Z7は125 MHz)、目標周波数が同じになるように分周値を再計算してください。この部分を見落とすと画面や映像が正常に出力されませんが、コードのエラーと誤解しやすいため、ご確認ください。


断絶のないフルスタックロードマップ:基礎からmini LLMアクセラレーターまで

すべての講義は独立した断片ではなく、一つの巨大なシステムを完成させていく旅です。

  • Step 1: AI理論および画像処理の基礎(Machine Learningを含む)

  • Step 2: AIアクセラレータ(NPU)の設計および検証(Machine Learningを含む)

  • Step 3: RISC-V CPU設計およびシステム統合

  • Step 4: 高度AI SoCの実装およびmini LLMアクセラレーションプラットフォームへの拡張(継続的なコンテンツ更新)


客観的な検証指標

本コースのすべての設計成果物は、グローバル標準および学界による厳格な検証を経ています。

  • RISC-Vアーキテクチャ検証:独自開発のRISC-V CPUが国際財団公式コンプライアンステスト(ACT)に合格し、ソースコードを公開(GitHub)

  • 学術的権威:単独著者による学術論文4本(KCI Aランクの著名学術誌IJIBC)

  • グローバルな評価:Amazonで技術書4冊を出版(ベストセラー1位を達成)


    出版書籍: Roger Kim: books, biography, latest update

  • 実動作検証完了:RV32I CPU、NPU、ビジョンシステム、GPS、Transformer、AURA-Edge SoCなどの主要IPがArty S7環境で完全動作


挑戦してください。実際にコードをボードに書き込み、結果を確認するこのプロセスを終える頃には、皆さんは以前とはまったく異なる視野を持つハードウェアエンジニアへとレベルアップしていることでしょう。

もっと見る

カリキュラム

全体

3件 ∙ (1時間 40分)

講座掲載日: 
最終更新日: 

受講レビュー

全体

1件

4.0

1件の受講レビュー

  • mdrifatnahid님의 프로필 이미지
    mdrifatnahid

    受講レビュー 1

    ∙

    平均評価 4.0

    4

    100% 受講後に作成

    タイトルが「Semiconductor(半導体)」となっているものの、それについてはほとんど触れられていません。ただし、非常に基本的なAIの基礎を学び始めるには適しています。

    • estlit
      知識共有者

      お時間を割いてお書きくださり、また基礎編について温かいお言葉をいただき、ありがとうございます。その部分がお役に立てたようで嬉しく思います。 タイトルについて、参考になるかもしれませんので、この講座が目指していることを少しご説明させてください。 これは、ハードウェアシリーズの理論編です。後続の講座では、実際のFPGAボード上にRISC-V CPU、CNNアクセラレータ、NPU、そして最終的には小型LLM SoCを構築していきます。このシリーズでは、TransformerエンジンもすでにFPGA上で実装・検証されています。この巻が存在するのは、回路を図だけから設計するのは難しいからです。回路の内部でどのような処理が行われているのか、そしてなぜそれにそのコストがかかるのかを理解する必要があります。 そのため、ここで扱うAI理論は、そうした目的に合わせて選び、構成しています。いくつか例を挙げます。 **積和演算を電力の問題として捉えること。** Part 1では、ニューラルネットワークの本質は膨大な回数の乗算と加算の繰り返しであり、実際のチップ上では、その一つひとつの演算が電力を消費するという点で締めくくっています。この一つの観察が、後半の低消費電力に関する議論全体の土台になっています。 **畳み込みをハードウェアのパターンとして捉えること。** 畳み込みの講義では、小さなフィルタを画像上で滑らせながら、重なり合う領域を乗算して加算する仕組みを説明しています。このスライディングウィンドウ構造、つまり同じ重みを位置ごとに再利用する構造こそ、アクセラレータが活用するために設計されるアクセスパターンです。 **なぜTransformerに専用アクセラレータが必要なのか。** Part 2では、再帰を取り除くことで、すべての単語を並列に計算できるようになり、その並列性の本質が大規模な行列乗算であることを説明しています。そして、それがシリコン上でどのような形になるのかも示します。つまり、こうした積和演算を格子状に配置し、同時に実行する構造がシストリックアレイであり、NPUの中核構造となります。 **なぜデータ移動がエネルギー予算の大部分を占めるのか。** Part 3では、AIの消費電力の大きな割合は、演算そのものではなくデータの移動に費やされているという点を説明しています。これは、低消費電力AIチップが設計の中心に据える制約であり、シリーズの最後を、データ移動の最小化とモデルの軽量化という、同時に前進させなければならない二つの方向で締めくくる理由でもあります。 これらの各セクションは、講義の中で同じ一文をもって締めくくられます。**これはハードウェアへの橋渡しです。** 冒頭の方針を示すスライドでも、その点を直接述べています。この講座に登場する抽象的な概念はすべて、シリーズの後半でシリコン上の実際の処理へと変わっていきます。だからこそ、この理論は純粋に数学的な形ではなく、実装可能な形で構成されています。 また、いただいたコメントによって、読者の側から説明を見ることもできました。この巻がシリーズのどこに位置づけられるのかについての説明は、現在ページの下部に置かれていますが、受講を申し込む前に明確に伝わるよう、冒頭へ移したいと思います。 本当にありがとうございます。 EdgeChipLab

EdgeChipLabの他の講座

知識共有者の他の講座はこちら

似ている講座

同じ分野の他の講座を見てみましょう!

新規会員登録で25%OFF

¥943

25%

¥1,253