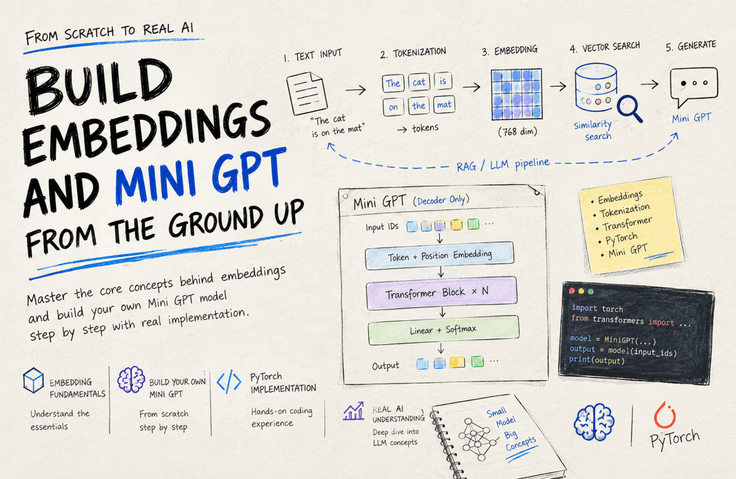
"Tôi đã sử dụng API embedding của OpenAI" và "Tôi đã tự triển khai một Transformer có 820.000 tham số mà không dùng framework" là hai câu khác nhau. Nếu muốn viết câu thứ hai, bạn phải mở ra xem bên trong, và khóa học này chính là quá trình đó.
Tôi viết trong CV như thế này.
01
Triển khai mô hình ngôn ngữ Transformer quy mô 820 nghìn tham số bằng TypeScript mà không dùng framework deep learning
Tự viết toàn bộ từ thiết kế cấu trúc self-attention đến huấn luyện và tạo câu, sau đó huấn luyện bằng các kịch bản của Shakespeare
02
Tự triển khai vi phân tự động và lan truyền ngược, tái hiện bằng tay các phép tính vốn được framework thực hiện thay
Tạo ra bộ phận tính toán cần sửa giá trị nào và sửa bao nhiêu, sau đó dùng nó để huấn luyện một mạng nơ-ron nhỏ và xác nhận rằng hàm mất mát giảm xuống
03
Huấn luyện Word2Vec skip-gram từ đầu và kiểm chứng việc hình thành các cụm ngữ nghĩa bằng độ tương đồng cosine
Không cung cấp bất kỳ quy tắc nào mà chỉ yêu cầu “hãy thử đoán từ xung quanh”, vậy mà kết quả phân biệt được mèo·chó là 0.697, còn mèo·thị trường chứng khoán là 0.432
04
Tự xây dựng tokenizer BPE và hoàn thiện pipeline đến bước embedding ở cấp độ câu
Từ các quy tắc chia văn bản dài thành những mảnh mà mô hình có thể xử lý, cho đến việc chuyển toàn bộ một câu thành các con số
05
So sánh mô hình tự xây dựng và mô hình công khai theo cùng một tiêu chí, đồng thời tổng hợp chênh lệch hiệu năng bằng số liệu
Bạn có thể giải thích điều gì khác nhau, khác nhau ở mức nào và sự khác biệt đó bắt nguồn từ đâu, kèm theo căn cứ rõ ràng
06
Chẩn đoán nguyên nhân khi kết quả embedding bất thường bằng cách phân tách theo lượng dữ liệu huấn luyện và số chiều
Bạn có thể phán đoán nên kiểm tra điều gì trước tiên với tư cách là người hiểu bên trong hệ thống, chứ không chỉ là người gọi API
Cả sáu dòng đều là những thứ bạn trực tiếp xây dựng và đo lường trong khóa học này. Ngay cả khi trong buổi phỏng vấn được hỏi "Vậy bên trong đang xảy ra chuyện gì?", bạn vẫn còn điều để trả lời.