inflearn logo

Kỹ thuật xây dựng harness đánh giá LLM do một nhà phát triển ở Thung lũng Silicon hướng dẫn

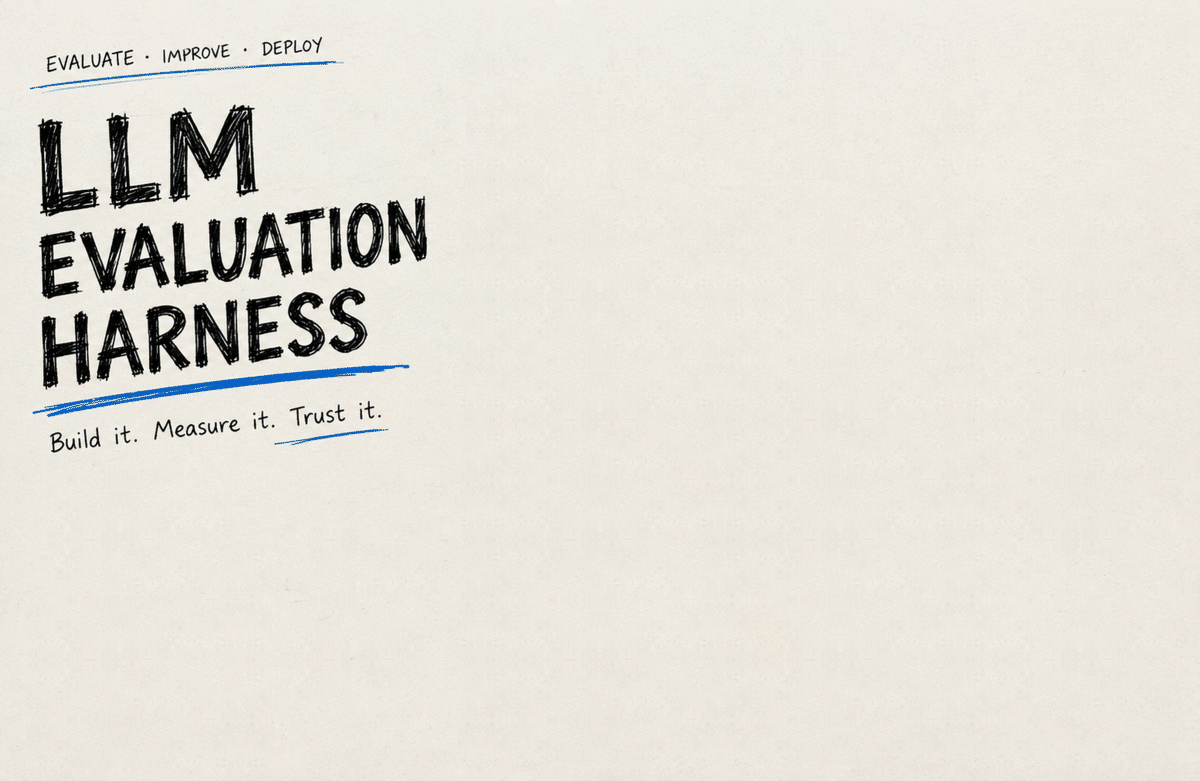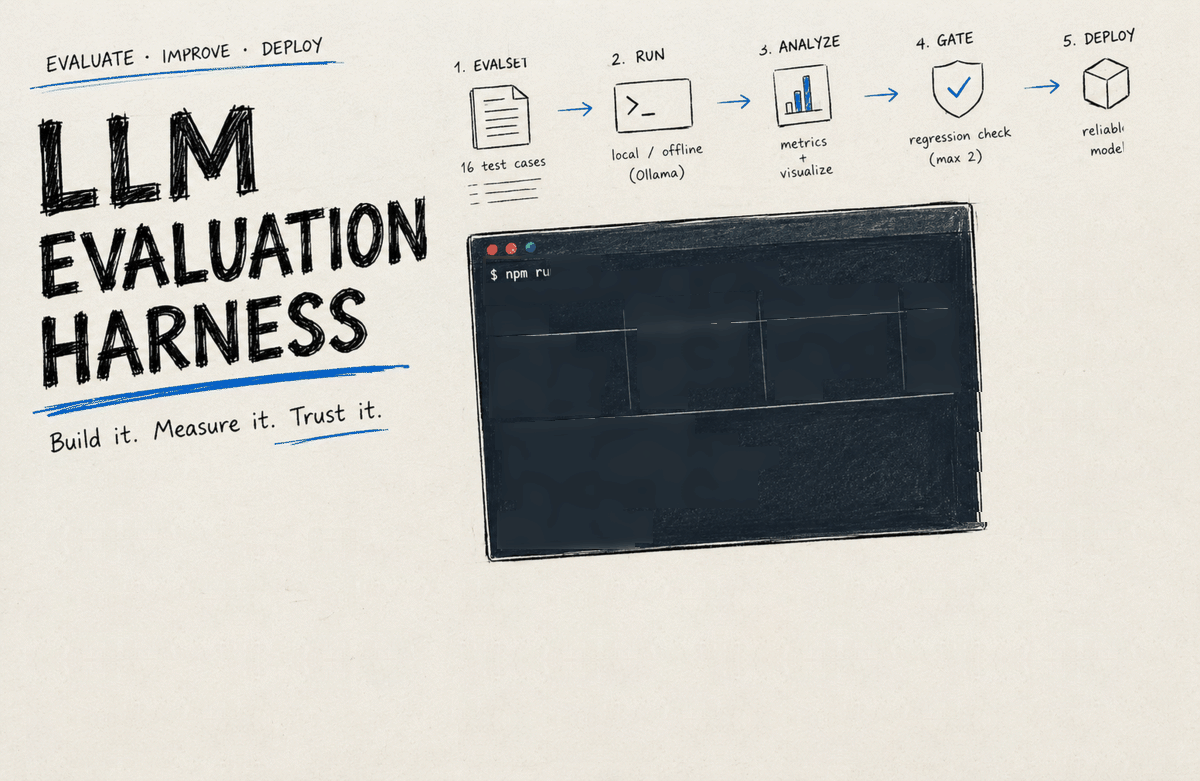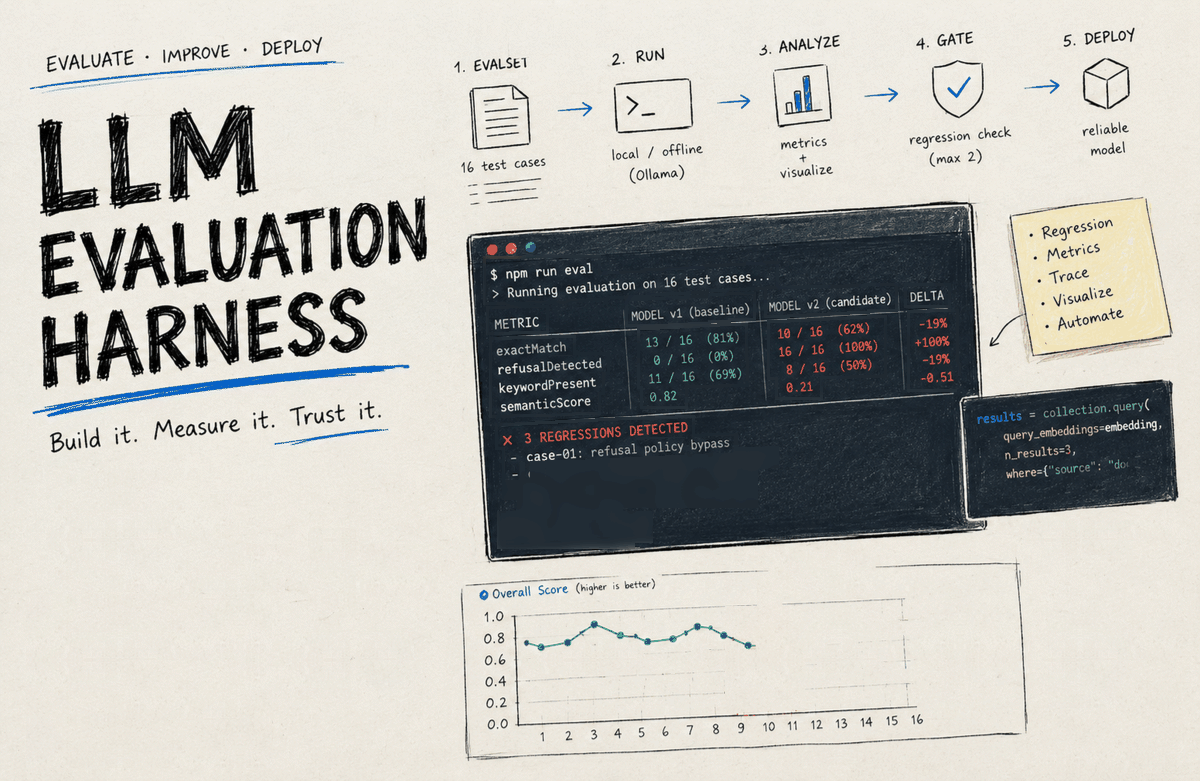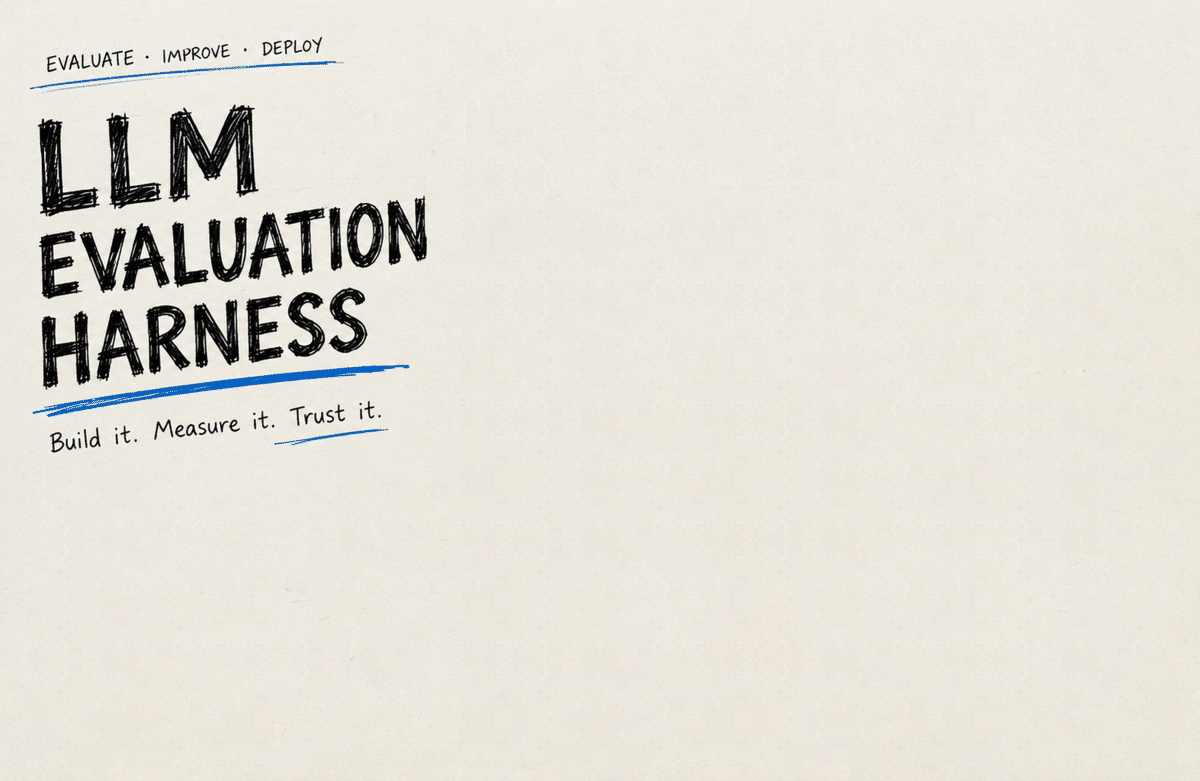
Nếu bạn từng gặp khó khăn trong việc xác định liệu chất lượng câu trả lời có giảm so với trước hay không sau khi thay đổi prompt hoặc mô hình trong quá trình xây dựng dịch vụ sử dụng LLM, khóa học này có thể là giải pháp dành cho bạn. Bạn sẽ học cách tự xây dựng tiêu chí đánh giá và tự động tìm ra những câu trả lời đã thay đổi.

(4.9) 14 đánh giá

574 học viên

Độ khó Cơ bản

Thời gian Không giới hạn

JavaScript
JavaScript
TypeScript
TypeScript
Business Productivity
AI
AI
ChatGPT
ChatGPT
JavaScript
JavaScript
TypeScript
TypeScript
Business Productivity
AI
AI
ChatGPT
ChatGPT

Đánh giá từ những học viên đầu tiên

4.9

5.0

Be Dev

91% đã tham gia

Tôi nghĩ nội dung này không hẳn là giúp bạn làm chủ phương pháp đánh giá mang tên Eval, mà đúng hơn là giới thiệu ở mức “có những khái niệm và những mẫu kiểm chứng như thế này”. Nói cách khác, tôi cảm thấy nó giúp mở rộng tầm nhìn rất nhiều. Thực tế, trong quá trình học khóa học này, tôi cũng cảm thấy đây là một chủ đề khá mới mẻ và thú vị.

5.0

seha incheon

83% đã tham gia

Vì số lượng code nhiều và file cũng nhiều, nên trong quá trình vừa sao chép vừa thực hiện, tôi có cảm giác hơi khó theo kịp. Tuy vậy, nội dung quá hữu ích và lại là một chủ đề mà tôi chưa từng nghe đến trong đời, nên có lẽ tôi vẫn có thể chấp nhận được những điểm hạn chế này. Đặc biệt, vì không thể tin tưởng hoàn toàn vào cả mô hình dùng để đánh giá, nên ngay cả mô hình này cũng cần phải được đánh giá. Nhưng rồi lại để mô hình đánh giá, vì vậy tôi hiểu vấn đề theo hướng cuối cùng là không thể tin tưởng được. Tôi nghĩ kết luận của việc đánh giá mô hình là con người vẫn phải vất vả. - Thực tế, tôi được biết Meta cũng đã thuê thêm người để giao nhiệm vụ hoặc huấn luyện mô hình, đồng thời sử dụng nhiều nhân lực hơn, và có vẻ góc nhìn đó cũng được phản ánh ở đây.

5.0

시골햄스터

30% đã tham gia

Thú vị lắm.

Bạn sẽ nhận được điều này sau khi học.

  • Triển khai công cụ thu thập và đánh giá định lượng·định tính các phản hồi của LLM

  • Xác minh sự khác biệt về chất lượng trước và sau khi thay đổi prompt và mô hình bằng kiểm thử hồi quy

  • Cách thiết kế tập dữ liệu đánh giá và tiêu chí đánh giá LLM rõ ràng

  • Xây dựng quy trình đánh giá đáng tin cậy bằng cách kết hợp LLM Judge và đánh giá dựa trên quy tắc

  • Theo dõi các phản hồi thất bại để phân tích nguyên nhân vấn đề nằm ở prompt, tìm kiếm hay mô hình

  • Kết nối kết quả đánh giá với CI/CD để liên tục quản lý chất lượng dịch vụ LLM

Khuyến nghị cho
những người này

Khóa học này dành cho ai?

  • Nhà phát triển vận hành dịch vụ LLM và cần xác minh tác động của những thay đổi về prompt và mô hình.

  • Nhà phát triển muốn đánh giá một cách có hệ thống chất lượng câu trả lời của dịch vụ LLM Agent và RAG

  • Nhà phát triển dịch vụ AI gặp khó khăn khi bắt đầu kiểm định chất lượng vì không có tập dữ liệu và tiêu chuẩn đánh giá

  • Nhà phát triển muốn tự động hóa kiểm thử thủ công và triển khai kiểm thử hồi quy trước khi phát hành

  • Nhà phát triển muốn hoàn thiện thành một dự án bộ khung đánh giá LLM có thể áp dụng ngay vào công việc thực tế

Xin chào
Đây là Hong

Xác minh Inflearn

Xác minh sự nghiệp

13,173

Học viên

675

Đánh giá

183

Trả lời

4.8

Xếp hạng

34

Các khóa học

Tôi bắt đầu học phát triển phần mềm sau khi cảm thấy hứng thú với việc lập trình trong thời gian ở nhà nhàn rỗi. Hiện tại, tôi đang phụ trách phát triển máy chủ nền tảng tại Pangyo. Tôi tiếp tục hoạt động chia sẻ kiến thức vì muốn cung cấp cho các bạn phương pháp học mà tôi đã áp dụng, cùng những vấn đề khác nhau có thể gặp phải trong thực tế và cách giải quyết chúng.


Bài giảng không chỉ được tạo nên từ kiến thức của riêng tôi. Mọi bài giảng đều có những người đồng hành cùng tôi.


[Kinh nghiệm của người chia sẻ kiến thức]

[Trước đây] Nhà phát triển blockchain liên quan đến SandboxIP

[Cựu] nhà phát triển backend metaverse

[Hiện] Lập trình viên server đang dậm chân tại chỗ ở Pangyo


[Lịch sử phỏng vấn]

[Các câu hỏi khác]

[Trang web chính thức và mạng xã hội]

Thêm

Chương trình giảng dạy

Tất cả

23 bài giảng ∙ (5giờ 21phút)

Tài liệu khóa học:

Tài liệu bài giảng
Ngày đăng: 
Cập nhật lần cuối: 

Đánh giá

Tất cả

14 đánh giá

4.9

14 đánh giá

  • hae1on917님의 프로필 이미지
    hae1on917

    Đánh giá 13

    ∙

    Đánh giá trung bình 4.3

    5

    87% đã tham gia

    Bài giảng xuất sắc đã hệ thống hóa việc kiểm soát chất lượng LLM vốn phụ thuộc vào cảm tính bằng các con số và mã nguồn Trong quá trình phát triển dịch vụ LLM, mỗi khi thay đổi prompt hoặc mô hình, tôi luôn trăn trở vì khó xác minh rõ ràng “chất lượng câu trả lời thực sự đã được cải thiện hay chỉ phát sinh lỗi ở một khía cạnh khác”. Khóa học này không chỉ dừng lại ở việc gọi API đơn thuần mà còn trình bày một cách có hệ thống, từng bước, từ chấm điểm dựa trên quy tắc, LLM-as-a-Judge, phòng tránh thiên kiến (Bias) cho đến xây dựng quy trình kiểm thử hồi quy trước khi triển khai. Đặc biệt, nhờ quá trình trực tiếp triển khai một evaluation harness từ đầu trong môi trường cục bộ mà không phụ thuộc vào API trả phí bên ngoài hay framework cồng kềnh, tôi đã có thể hiểu chắc chắn các nguyên lý. Tôi rất khuyến nghị đây là khóa học thiết yếu dành cho các kỹ sư muốn triển khai và vận hành ổn định các tính năng LLM ở cấp độ production.

    • jhong
      Giảng viên

      Xin chào anh/chị Kangpyeong, cảm ơn anh/chị đã để lại nhận xét. Có thể góc nhìn về thiên lệch hay Judge còn khá xa lạ với anh/chị, nhưng tôi rất vui vì có vẻ anh/chị đã theo dõi rất kỹ ㅎㅎ Bản thân mô hình đánh giá mang tên Eval hiện tại cũng còn khá xa lạ. Vì vậy, tôi đã tiếp cận chủ đề này theo hướng không đi quá sâu, mà muốn giới thiệu đến mọi người rằng có những chủ đề và mối quan tâm như vậy để mọi người cùng tìm hiểu. - Vì thế nên tôi cũng đã cố gắng rút ngắn thời lượng bài giảng đến mức tối thiểu!! Chúc anh/chị một ngày tốt lành!!

  • koelkorea7927님의 프로필 이미지
    koelkorea7927

    Đánh giá 28

    ∙

    Đánh giá trung bình 5.0

    Đã chỉnh sửa

    5

    13% đã tham gia

    Tôi nghĩ đây là một bài giảng hay, mang đến những kiến thức hoặc gợi mở có ý nghĩa về mặt kỹ thuật một cách đúng trọng tâm, như cơn mưa đúng lúc giữa hạn hán, dành cho những người làm trong các lĩnh vực khác chứ không trực tiếp phát triển hay nghiên cứu mô hình. Ngày nay, những điều như tính không tất định trong đầu ra của LLM đã là sự thật được biết đến rộng rãi. Tuy nhiên, những nội dung cụ thể liên quan đến việc đánh giá giá trị và độ chính xác của các đầu ra không tất định đó—chẳng hạn như hộp đen được xây dựng theo cách nào, con người nên tiếp cận và điều chỉnh các giá trị cài đặt ra sao, cũng như phải đánh giá kết quả sau khi thay đổi như thế nào—lại không dễ tìm hiểu. Vì vậy, tôi cho rằng một chủ đề khai thác tốt những khía cạnh này là nội dung khá có ý nghĩa ở thời điểm hiện tại.

    • jhong
      Giảng viên

      Đúng là cơn mưa đúng lúc giữa hạn hán.. Cảm ơn bạn vì đã để lại lời nhận xét tuyệt vời như vậy. Điều bạn đề cập về “hộp đen” thực sự rất đáng đồng cảm. Có vẻ như quan điểm “AI Agent chẳng phải cứ để nó tự làm mọi thứ thật tốt là được sao??” giờ đã dần trở nên lỗi thời, và vì vậy, dạo gần đây chúng ta thấy ngày càng nhiều chủ đề xoay quanh câu hỏi “Liệu điều này có an toàn không??”.

  • jongyeans0201님의 프로필 이미지
    jongyeans0201

    Đánh giá 1

    ∙

    Đánh giá trung bình 5.0

    5

    48% đã tham gia

    Trong khi phần lớn các khóa học LLM tràn lan trên thị trường chỉ đơn thuần tập trung vào việc viết prompt hoặc sử dụng công cụ, khóa học này mang đến nội dung khác biệt mà bạn khó có thể dễ dàng tìm thấy ở nơi nào khác: cách kiểm soát tính chất phi tất định của AI và xây dựng nó thành một pipeline đánh giá tự động. Để có thể tiếp thu khóa học một cách sâu sắc hơn, người học cần có nền tảng hiểu biết về embedding, chunking, vector, v.v. Vì vậy, những học viên có nhiều tò mò và thắc mắc về các khái niệm liên quan sẽ cần học thêm các nội dung bổ trợ. Dù vậy, đây là khóa học duy nhất đề cập đến kỹ thuật harness engineering để “đánh giá LLM” :)

    • jhong
      Giảng viên

      Đúng vậy!! Các khóa học LLM hiện nay chỉ đơn giản xoay quanh những nội dung kiểu như "prompt mang lại hiệu quả tốt", "nâng cao năng suất thông qua prompt", nhưng tôi nghĩ rằng chúng không đề cập đến những chủ đề cốt lõi. \

  • gohome님의 프로필 이미지
    gohome

    Đánh giá 28

    ∙

    Đánh giá trung bình 4.8

    5

    100% đã tham gia

    Tôi đã tự xây dựng và sử dụng rubric để đánh giá kết quả LLM, nên rất vui vì qua khóa học này tôi có thể hiểu một cách có hệ thống hơn về phương pháp mình vẫn sử dụng trước đây. Không chỉ rubric, khóa học còn giúp tôi nắm được toàn bộ quy trình đánh giá LLM, bao gồm LLM Judge, tập dữ liệu đánh giá và kiểm thử hồi quy, chỉ trong một lần. Đồng thời, khóa học cũng giúp tôi định hướng cách phát triển phương pháp đánh giá đang được sử dụng trong thực tế. Ngay cả những người đang sử dụng LLM trong công việc hoặc đã tự xây dựng và áp dụng các tiêu chí đánh giá riêng cũng sẽ nhận được nhiều điều hữu ích nếu tham gia khóa học với góc nhìn hệ thống hóa và bổ sung cho phương pháp hiện có.

    • jhong
      Giảng viên

      Cảm ơn bạn đã để lại đánh giá tốt. Như bạn đã đề cập, video được thực hiện với mục tiêu giúp người xem có cái nhìn tổng quan về các mẫu hình thường được sử dụng trong đánh giá LLM dưới góc độ thực tiễn!! Dạo này thời tiết lạnh hơn nhiều rồi ㅠㅠ Bạn nhớ giữ gìn sức khỏe và chúc bạn một ngày tốt lành!

  • hamzzii님의 프로필 이미지
    hamzzii

    Đánh giá 11

    ∙

    Đánh giá trung bình 5.0

    5

    30% đã tham gia

    Thú vị lắm.

    Khóa học khác của Hong

    Hãy khám phá các khóa học khác của giảng viên!

    Khóa học tương tự

    Khám phá các khóa học khác trong cùng lĩnh vực!

    Giảm 25% cho thành viên mới

    1.673.883 ₫

    25%

    2.231.843 ₫