RAG를 활용한 LLM Application 개발 (feat. LangChain)
실리콘밸리 GenAI 해커톤 우승자에게 배우는 RAG. 현업 노하우를 가득 담았습니다
실리콘밸리 GenAI 해커톤 우승자에게 배우는 RAG. 현업 노하우를 가득 담았습니다
Part I PDF를 페이지별 Document로 불러와 청킹하고, 임베딩으로 벡터화해 벡터 저장소에 색인하는 과정을 코드로 실습함. 질문을 벡터로 바꿔 유사도 검색(점수·벡터·MMR 포함)을 하고, 이를 Retriever(Runnable)로 감싸 RAG에 연결하는 구조를 익힘. 검색 품질 점검, 보안·거버넌스(프롬프트 인젝션 포함), 자주 하는 실수를 정리해 실무 적용 기준을 갖춤. Part II 의사결정나무의 한계를 극복한 랜덤포레스트 알고리즘을 R로 구현하고, 모델 결과를 정확히 해석하는 방법을 익힘. 붓꽃 데이터와 실제 바이오마커 데이터를 활용해 OOB 오차, 변수 중요도, 혼동행렬 등 핵심 지표를 읽고 설명하는 능력을 키움. 하이퍼파라미터 튜닝과 교차 검증, ROC 곡선 분석까지 실무에 바로 적용 가능한 전체 워크플로우를 완성함.
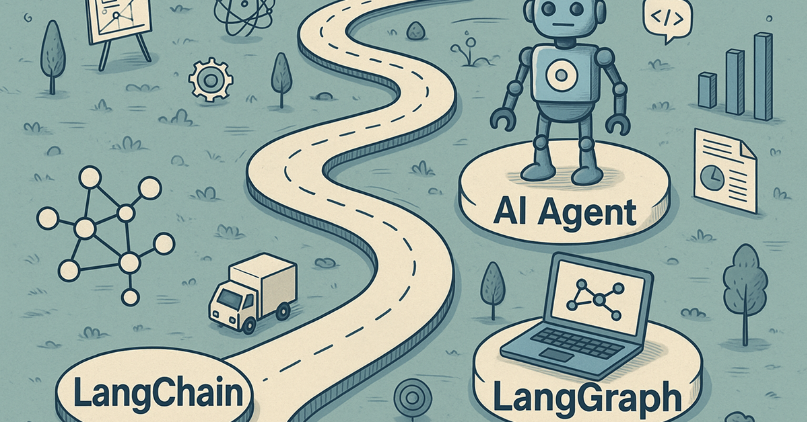
LangChain을 통한 운영수준의 AI Agent 챗봇 개발부터 LangGraph, LangSmith 를 통한 고도화작업을 통해 AI Agent개발의 핵심 기술 3가지를 정리합니다.
아무것도 몰라도 따라오다 보면 전문가가 될 수 있어요!
할인 마감 D-1
할인중
할인 마감 D-1
할인 마감 D-1
할인중
할인 마감 D-2
할인중
할인 마감 D-7
할인 마감 D-1
할인 마감 D-1