채널톡 아이콘

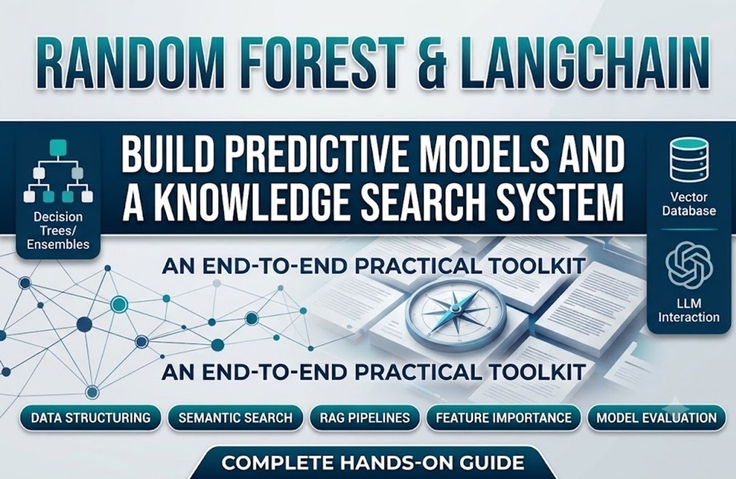
랜덤포레스트부터 LangChain 지식 검색 시스템까지: 데이터 분석과 LLM 실무 활용

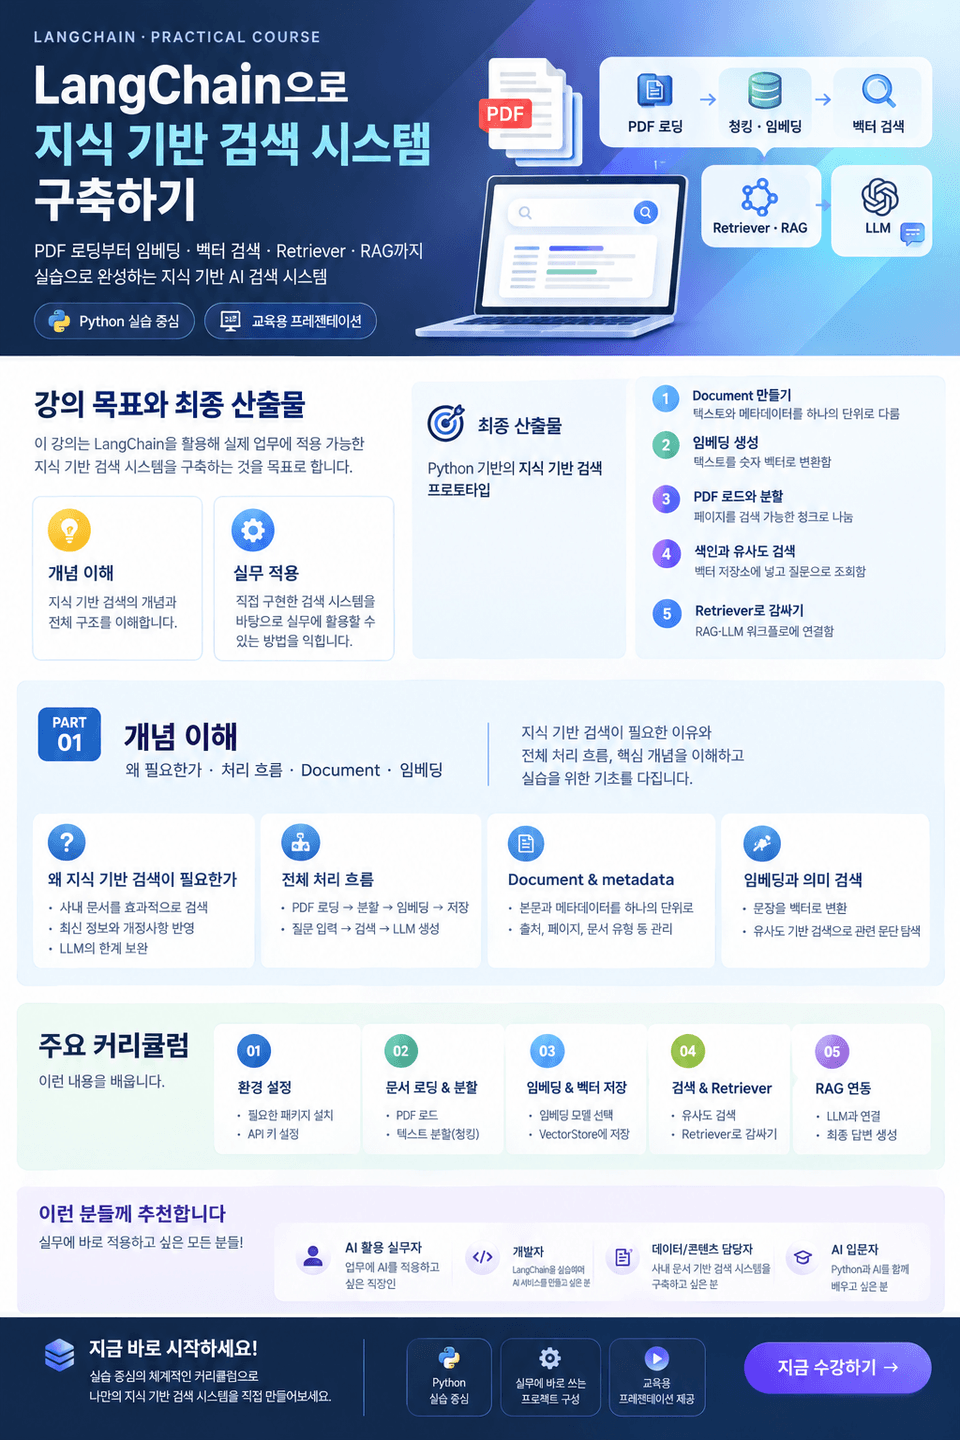
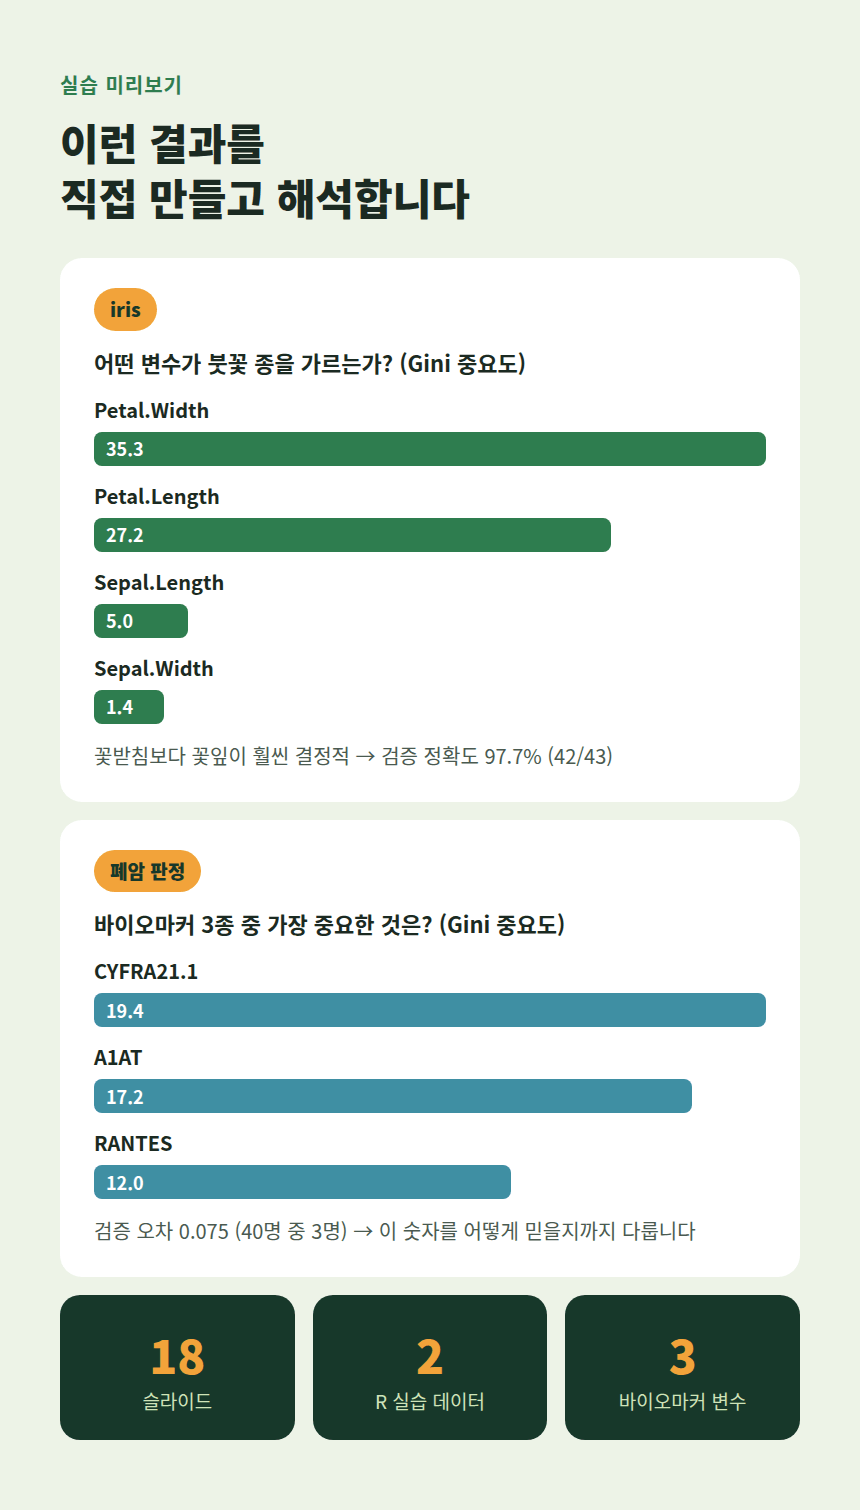
Part I PDF를 페이지별 Document로 불러와 청킹하고, 임베딩으로 벡터화해 벡터 저장소에 색인하는 과정을 코드로 실습함. 질문을 벡터로 바꿔 유사도 검색(점수·벡터·MMR 포함)을 하고, 이를 Retriever(Runnable)로 감싸 RAG에 연결하는 구조를 익힘. 검색 품질 점검, 보안·거버넌스(프롬프트 인젝션 포함), 자주 하는 실수를 정리해 실무 적용 기준을 갖춤. Part II 의사결정나무의 한계를 극복한 랜덤포레스트 알고리즘을 R로 구현하고, 모델 결과를 정확히 해석하는 방법을 익힘. 붓꽃 데이터와 실제 바이오마커 데이터를 활용해 OOB 오차, 변수 중요도, 혼동행렬 등 핵심 지표를 읽고 설명하는 능력을 키움. 하이퍼파라미터 튜닝과 교차 검증, ROC 곡선 분석까지 실무에 바로 적용 가능한 전체 워크플로우를 완성함.

1명 이 수강하고 있어요.

난이도 초급

수강기한 3개월

langchain
langchain
rag시스템구축
rag시스템구축
딥러닝머신러닝
딥러닝머신러닝
인공지능(ai)
인공지능(ai)
빅데이터분석
빅데이터분석
langchain
langchain
rag시스템구축
rag시스템구축
딥러닝머신러닝
딥러닝머신러닝
인공지능(ai)
인공지능(ai)
빅데이터분석
빅데이터분석

수강 후 이런걸 얻을 수 있어요

  • OOB 오차와 변수 중요도 지표를 해석하여 모델 신뢰성 평가 및 주요 변수 식별

  • ntree와 mtry 하이퍼파라미터 튜닝을 통한 모델 최적화 및 ROC 곡선 기반 성능 비교

  • 데이터 단위 처리: Document 객체를 활용해 텍스트와 메타데이터(출처, 페이지 등)를 구조화하는 방법

  • 긴 문서를 적절한 크기의 청크로 나누고, OpenAI 등 임베딩 모델을 통해 문장을 숫자 벡터로 변환

  • 벡터 검색과 Retriever: 벡터 저장소(Vector Store) 색인부터 Retriever를 통한 유사도/MMR 검색

  • LLM 워크플로(RAG)로 연결하는 전체 엔드투엔드(End-to-End) 아키텍처

  • 단순한 LLM의 기억에 의존하는 대신, 회사 규정이나 매뉴얼 등 실제 PDF 문서에서 질문과 가장 가까운 문단을 정확히 찾아내는 검색 프로토타입

  • 환각(Hallucination) 관리 및 출처 보존: 검색된 문단의 원문 내용뿐만 아니라 출처 파일명, 페이지 번호, 문자 위치(start_index) 등의 메타데이터를 함께 유지

Part I

  • LangChain, 연결하는 것보다 검색 결과를 활용하는 방법: PDF 로딩·임베딩·벡터 검색·RAG

  • LangChain으로 배우는 지식 기반 검색 시스템: 원리부터 Python 실습, 검색 결과 해석까지

  • 문서 속 근거를 찾는 AI 검색 시스템 (PDF부터 Retriever·RAG까지)

  • LangChain 검색 시스템 완성: Document · 청킹 · 임베딩 · 벡터 검색 · Retriever · RAG

Part II

  • 랜덤포레스트, 돌리는 것보다 결과를 읽는 방법: R로 끝내는 분류·변수 중요도·튜닝

  • R로 배우는 랜덤포레스트: 원리부터 폐암 판정 실습, 결과 해석까지

  • 숫자 뒤의 이야기를 읽는 랜덤포레스트 (iris부터 바이오마커까지)

  • 랜덤포레스트 완성: 원리 · R 실습 · OOB · 변수 중요도 · 튜닝

이런 분들께
추천드려요

학습 대상은
누구일까요?

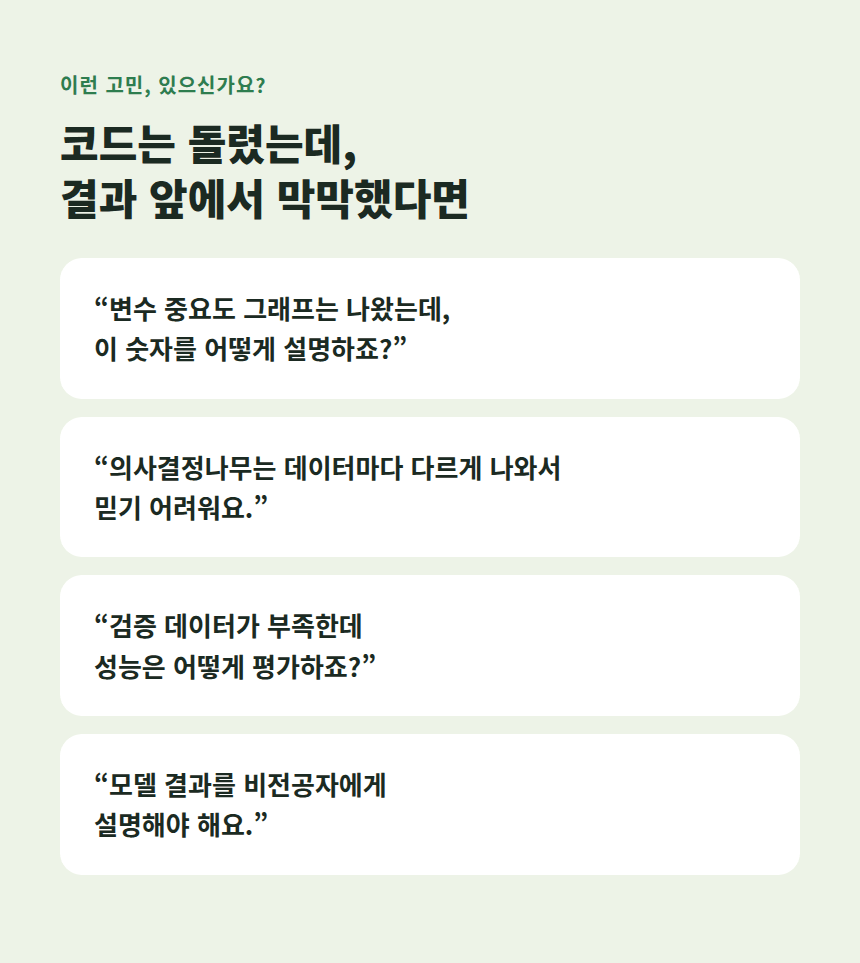
  • 머신러닝 코드는 실행했지만 출력 결과의 의미를 이해하지 못하는 데이터 분석 입문자

  • R을 활용한 분류 모델 구축과 해석 능력을 향상시키고 싶은 바이오통계 연구자

  • 랜덤포레스트의 이론과 실무 적용 방법을 체계적으로 학습하려는 데이터 사이언스 학습자

  • 회사 내부에 쌓여 있는 수많은 PDF 규정집이나 매뉴얼을 LLM과 연계

  • 단순히 API를 호출하는 것을 넘어, Document 객체 구조, 텍스트 청킹(RecursiveCharacterTextSplitter), 임베딩(Embedding) 원리, 벡터 저장소(Vector Store) 색인, 그리고 Retriever와 RAG로 이어지는 전체 아키텍처의 흐름을 확인하고 싶은부

선수 지식,
필요할까요?

  • R 프로그래밍 기본 문법과 데이터프레임 조작 경험

  • 의사결정나무(Decision Tree) 알고리즘의 기초 개념 이해

  • 분류 문제와 혼동행렬(Confusion Matrix)에 대한 기본 지식

  • 텍스트 문자열(String), 리스트(List), 딕셔너리(Dictionary) 등의 데이터를 다루는 기본적인 조작 방법

  • 명령 프롬프트(CMD), PowerShell 또는 터미널 환경에서 디렉토리 이동(cd) 및 기본 명령어 실행 경험

  • 가상환경을 생성하고, 패키지 관리 도구인 pip로 필요한 라이브러리를 설치해 본 경험

안녕하세요
한희선입니다.

커리어인증

데이터 분석 · AI 전문 강사

  • 기업 및 공공기관 대상 데이터 분석·통계 교육 다수 출강

  • 직업전문교육원 빅데이터·AI 과정 전임 강사

  • 데이터 분석, 통계, 사회조사 분야 실무 및 교육 전문가

  • SPSS, R, Python 기반 데이터 분석 및 통계 실습 강의

  • 사회조사분석사, 빅데이터 분석기사 자격증 대비 강의 운영

  • 저서 : 데이터과학자 시리즈 Step1~4, AI 분석을 위한 빅데이터 구축(정형 및 비정형 한글데이터), 사회조사분석사 2급 필기&실기(필답형), 데이터 분석도구R Fundamental

더보기
강의 게시일: 
마지막 업데이트일: 

수강평

아직 충분한 평가를 받지 못한 강의입니다.
모두에게 도움이 되는 수강평의 주인공이 되어주세요!

한희선님의 다른 강의

지식공유자님의 다른 강의를 만나보세요!

비슷한 강의

같은 분야의 다른 강의를 만나보세요!

얼리버드 할인 중

₩1,650

70%

₩5,500

평생교육이용권 지원 강의