Airflowマスタークラス
hyunjinkim

¥18,250
初級 / airflow, Data Engineering, Python
4.9
(81)
1,100+
データパイプラインを効率的に作成し管理するためのOrchestrationツールであるAirflowについて学ぶ講義です。初心者でも順を追って学べるAirflowマスタークラスへようこそ!

初級
airflow, Data Engineering, Python

TransformerベースのLLMアーキテクチャとGPU活用戦略を理解し、vLLMを活用した実際のサービングプロセスまで実践的に学びます。 AIシステムのパイプライン構築からモニタリング、マルチGPUの活用まで、実務の流れ全体を扱い、 複雑な数式を使わず、図解と実習を中心に直感的に理解できるよう構成された講義です。
受講生 524名
難易度 初級
受講期間 無制限
学習した受講者のレビュー
5.0
WonJune Lee
私はディープラーニング関連の職種ではありませんが、コンピュータビジョン(ルールベース)の分野で働いています。会社でLLMとビジョン系のディープラーニング技術が必要になり、関連するトピックを勉強しています。 まだ40%ほどしか受講していませんが、受講評を書かなければと思い投稿します。 ディープラーニング関連の講義もたくさん受けてきましたし、それなりに有名で評判の良い方の講義も受けてみましたが、この講義ほどスッキリとまとまった講義はありませんでした。 一番良いのは、講義資料のクオリティが素晴らしいことです。エクセルで行列計算を一つひとつ書き留めてくださっていますが、復習の際に本当に役立ちます。Pythonのコードも多くの場所にコメントが付けられています。 講義の質も高く、受講生が忘れそうな部分はリマインドしてくれるので、聞き逃すことがなくて良かったです。計算も、他の講義では大抵1、2回見せて終わりですが、この講義では最後まで一緒に計算してくれるので、確実で良かったです。 Q&Aも頻繁にチェックされているのか、質問を投稿するとすぐに回答をいただけるので助かりました。講義はおそらく今年撮影されたものだと思いますが、そのせいか最新トレンドの内容が多くて良いです。 まだ口コミが広まっていない講義のようですが、関連するトピックで勉強が必要な方に本当に強くおすすめします。
5.0
램쥐뱅
最高です。ありがとうございます。
5.0
정현욱
わかりやすく説明してくださってありがとうございます。
Transformerモデルのエンコーダ・デコーダ構造と核心的な動作原理を理解する
MHA、MQA、GQA、MLAなど、最新のアテンションメカニズムの発展の流れを理解する
現在、AIサービングの事実上の標準であるvLLMエンジンの活用方法を実習する
vLLMサービング環境におけるTTFT、TPOTなどの主要なパフォーマンス指標のモニタリング
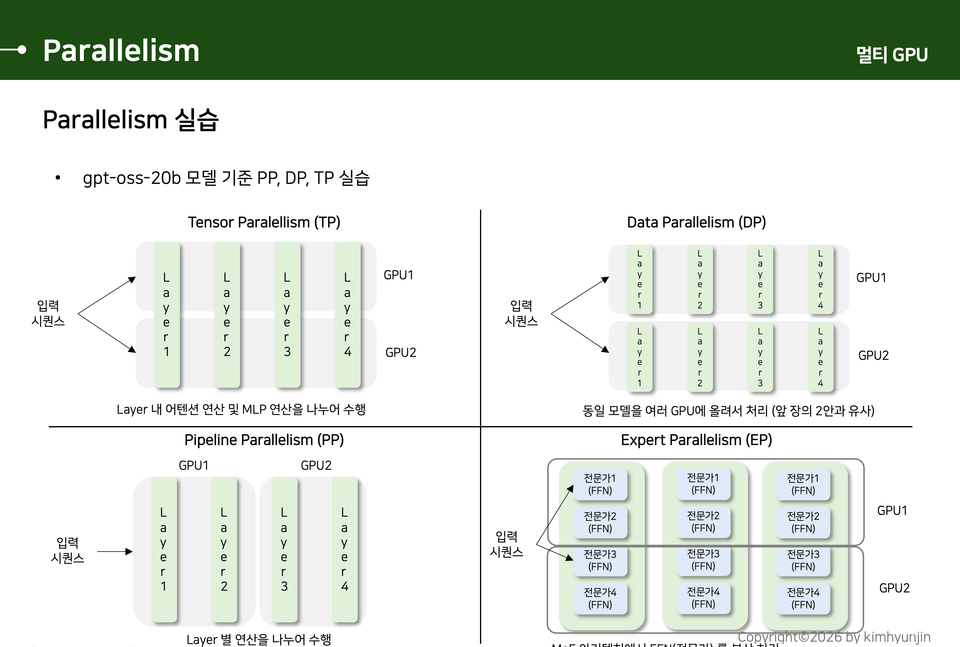
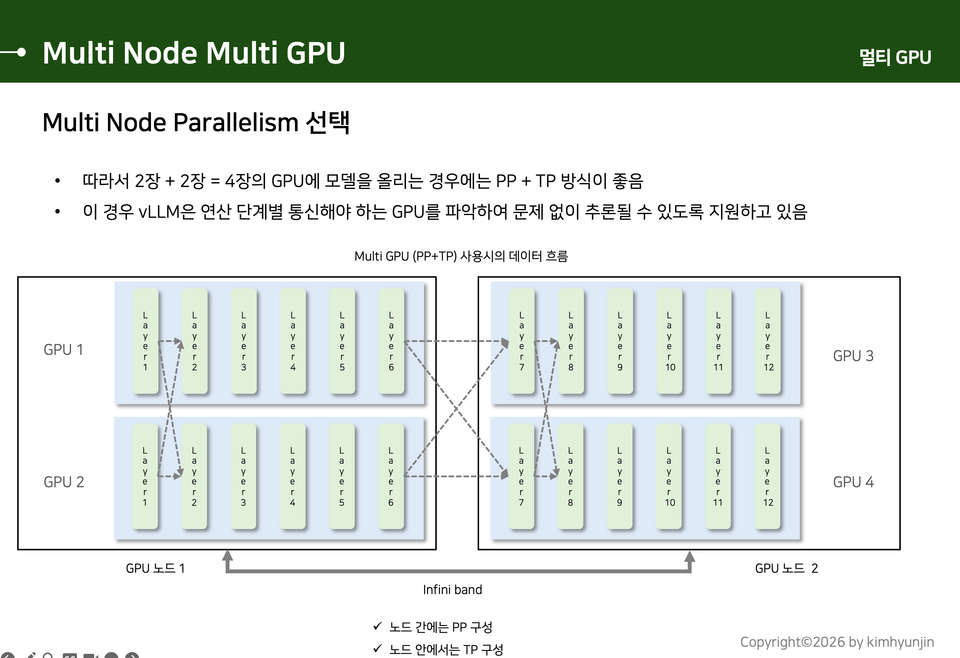
Tensor/Pipeline/Data Parallelを活用したマルチGPUアーキテクチャの設計および実装
Agent AIの核心概念とTool Callingの動作原理を理解する
実際の現場視点でのAIシステムパイプライン構築および性能モニタリング経験
最新の論文に基づき、MLA、MTP、エングラムなど、最新のLLMトレンドを理解する
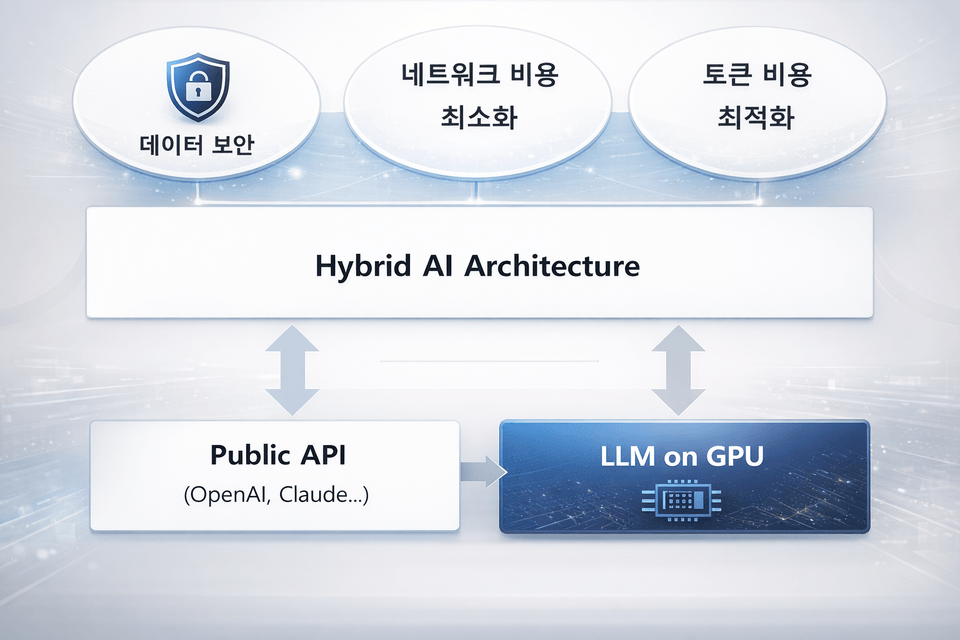
自律型AIエージェント時代には
OpenAI、Claude、Codexなど、さまざまなエージェントツールやPublic APIを活用できます。
しかし、実際のサービス環境では
データセキュリティ、ネットワークコスト、トークンコスト、GPUリソース管理まで併せて考慮する必要があります。
そこで重要なのは
Public APIと自前のGPUベースLLMを状況に応じて組み合わせる
Hybrid AIアーキテクチャへの理解です。
それでは、Public APIだけを使用することが常に最善なのでしょうか?
必ずしもそうとは限りません。
最近では、public API(chatGPT、Claude、Sonnetなど)に匹敵する
LLMが国内外で多数開発されています。
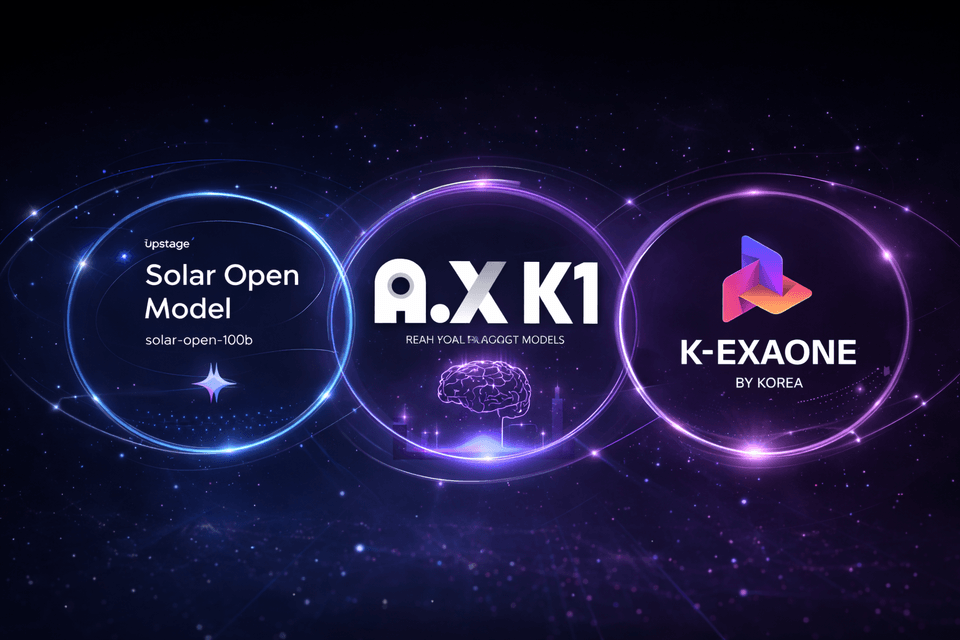
しかし、LLMを深く理解して使いこなすのは容易ではありません。
高価なGPUを購入したうえで、
LLMを理解して使用する場合と、理解せずに使用する場合とでは、
大きな違いが生じます。
대規模エージェントの時代を迎え、今や学習よりも推論の時代です。Public APIをうまく使うことも必要ですが、多くの企業ではセキュリティ、ガバナンス、コストなどさまざまな理由から、ローカル環境でのサービング環境の構築を好みます。ローカル環境でLLMサービング環境を構築するためのLLMアーキテクチャの理解から、アーキテクチャの構成、LLM開発のトレンドまで、すべてを学びましょう。
Hugging Faceで公開されている数多くのLLMを理解して使いこなす必要があります。
しかし、LLMモデルの仕様を示すconfig.jsonファイルは、初心者にとって暗号文も同然です。なぜなら、トランスフォーマー(transformer)モデルを理解していなければ読み解けないからです。
しかし、心配はいりません。この講義を受講すれば、主要なスペックを見て理解できる専門家になれます。
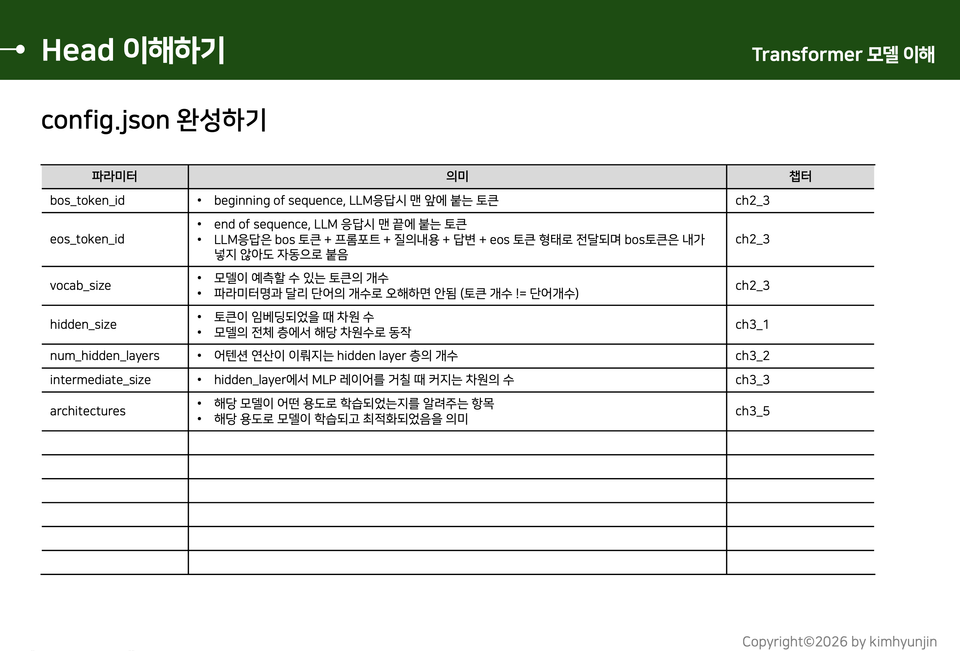
(チャプター3-5の内容です。残りの主要パラメータについてもすべて学んでいきましょう)
現在のLLMモデルの基盤となっているトランスフォーマーモデルの始まりと終わりは、アテンションです。
attention-modelは2017年に登場しましたが、
今なお10年近くにわたって最強のアルゴリズムとして君臨しています。
トランスフォーマー構造から脱却するための多くの試みが行われていますが、
いまだにトランスフォーマーのアテンションを完全に代替するアーキテクチャは登場していません。
⚠️ アテンションは生半可な理解では絶対にいけません。
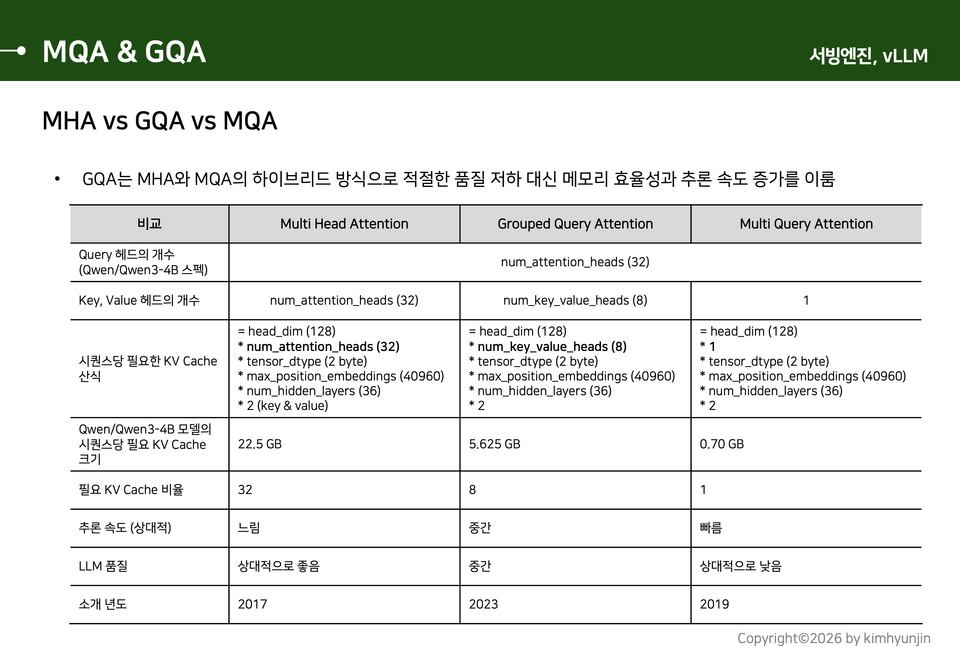
(第5-4章の内容です。アテンションの発展の流れが、そのままLLMの発展の流れです)
大規模LLMの稼働と高速な推論のためには、マルチGPU構成が不可欠です。
しかし、マルチGPU構成にもさまざまな方法があることをご存じですか?
トランスフォーマーとアテンションの構造を学んでみたいと思っていたものの、
複雑な数式や概念に難しさを感じていた方
ChatGPTや生成AIサービスを使ったことはあるものの、
LLMが実際にどのように動作するのか、その原理を理解したい方
LLMアーキテクチャとGPU環境を理解し、
実際のAIシステムを構築・運用する能力が必要なAIエンジニア
Transformerモデルを理解する
トークナイザー & 埋め込み
エンコーダー vs デコーダー
モデルのソースコードを見る
Docoderモデルを極める
アテンションをマスターする
マスクドアテンション
KVキャッシュ
vLLM Serving
Paged Attention
OpenAI互換
SSEプロトコル
Tool Callの理解
ツール応答アーキテクチャ
チャットテンプレート
ツール呼び出しパーサー
パフォーマンステスト
vLLMモニタリング
マルチGPU & Parallelism
vLLMの追加機能
マルチトークン予測
mHC
Engram
限界克服に向けた取り組み
数式なしで学ぶアテンションの核心原理
数式なしで、Excelを通してさまざまなアテンション手法を直感的に学びます(MHA → MQA → GQA、Sliding Windowアテンション)
3 Tier構造のAIアーキテクチャ実装
OpenWebUI、FastAPI、vLLMへとつながる3Tierアーキテクチャの基本構造を理解し、Tool連携の基本的な流れを学びます
vLLM運用のための同時ユーザー数の測定とヒント
jMeterを使用してFastAPI → vLLMの負荷テストを行い、同時ユーザー数に応じたTTFT、TPOTなどの指標を確認します。
vLLMサービスのモニタリング
Prometheus & Grafanaダッシュボードのパイプラインを構築し、vLLMサービス運用の基本原理を習得します。
単一GPU / マルチGPUテスト
3種類の基本的なマルチGPU(Pipeline Parallel、Tensor Parallel、Data Parallel)を実践し、なぜマルチGPUが必要なのかを自分の目で確認します。
LLM開発トレンドを制覇する
DeepSeekのMTP、Shared MoE、MLA、Engramなどの最新技術と、推論の効率化に向けて進められているLLM開発のトレンドを紹介します。
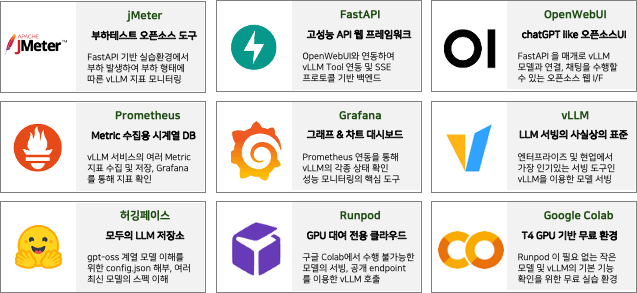
vLLMシステムの構築はRunpodを利用して行います。また、Google ColabのT4 GPUを活用した実習も並行して行います。T4 GPUは15GBのGPUメモリを提供しているため、Colabで可能な実習はColabで行います。
OpenWebUI → FastAPI → Runpodフローをベースとした実習環境を構築します。RunpodクラウドのGPUサーバーにvLLMを構築し、さまざまな実習を行います。
実習のために約$10~$20程度の実習費用が発生します。
人工知能(AI)実習の標準環境ともいえるGoogle Colabは、Runpod環境を必要としない単純な実習に活用します。Proではなく通常の無料ティアで進め、T4 GPUを利用します。
vLLMサービスはRunpod上で起動しますが、
講義を受講するローカルコンピューターでもOpenwebUIおよびFastAPIが起動します。
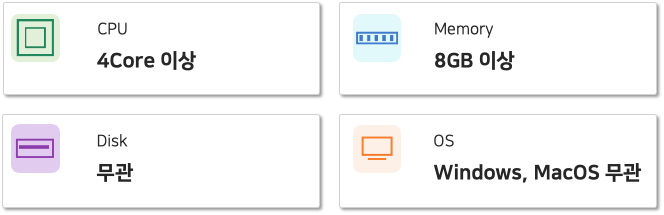
そのため、以下の受講環境を満たしているかご確認ください!

vLLMのアップデート速度は非常に速いです。しかし、Majorバージョンはまだ0番台にとどまっています。
それでも、多くの企業が事実上の標準のようにvLLMを推論エンジンとして使用しています。
現在のLLMの主軸を成すトランスフォーマーモデルだけでなく、代替として登場した Mamba アーキテクチャまでvLLMでサポートされており、Multi Token Predictionのようにモデルに新しい機能が追加されると、それを支えるためにvLLMはそのたびにアップデートされます。
本講義も、新しいvLLMの機能や新しいモデルタイプが登場した際にはアップデートされる予定です。
学習対象は
誰でしょう?
ChatGPTや生成AIを使用しているものの、LLMが実際にどのように動作するのか理解したい実務担当者
AIエンジニアを目指し、LLMサービングとシステムアーキテクチャを体系的に学びたい初心者
複雑な数式なしで、トランスフォーマーとアテンションの構造を実務的な観点から理解したい開発者
GPU最適化とマルチGPU環境における実際のAIシステム構築の流れを理解したいバックエンド・インフラエンジニア
AIサービスの企画・開発プロセスにおいて、LLMの構造とGPU活用戦略を理解したいPM・プランナー
前提知識、
必要でしょうか?
Pythonの基本文法に関する理解(変数、関数、条件文など)
gitの基本的な使い方

インフラーン認証
2,026
受講生
134
受講レビュー
251
回答
4.9
講座評価
3
講座
こんにちは。
大手企業でデータ&AI分野に携わっている17年目の現役エンジニアです。
情報管理技術士を取得して以来、これまで得た知識を多くの人々と共有するためにコンテンツを制作しています。
はじめまして。 :)
Contact: hjkim_sun@naver.com
全体
53件 ∙ (14時間 27分)
講座資料:
3. ローカルLLM構築の必要性
13:37
5. トークナイザー
22:53
6. 埋め込み
17:43
7. トランスフォーマーを理解する
21:23
8. アテンションメカニズム
16:57
9. encoderモデルの詳細を見る
18:05
10. decoderモデルの詳細を見る
11:30
11. headを理解する
16:35
12. エンコーダー vs デコーダー
09:17
13. モデルのソースコードを見る
09:35
全体
27件
5.0
27件の受講レビュー

受講レビュー 3
∙
平均評価 3.7

受講レビュー 3
∙
平均評価 5.0
修正済み
5
私はディープラーニング関連の職種ではありませんが、コンピュータビジョン(ルールベース)の分野で働いています。会社でLLMとビジョン系のディープラーニング技術が必要になり、関連するトピックを勉強しています。 まだ40%ほどしか受講していませんが、受講評を書かなければと思い投稿します。 ディープラーニング関連の講義もたくさん受けてきましたし、それなりに有名で評判の良い方の講義も受けてみましたが、この講義ほどスッキリとまとまった講義はありませんでした。 一番良いのは、講義資料のクオリティが素晴らしいことです。エクセルで行列計算を一つひとつ書き留めてくださっていますが、復習の際に本当に役立ちます。Pythonのコードも多くの場所にコメントが付けられています。 講義の質も高く、受講生が忘れそうな部分はリマインドしてくれるので、聞き逃すことがなくて良かったです。計算も、他の講義では大抵1、2回見せて終わりですが、この講義では最後まで一緒に計算してくれるので、確実で良かったです。 Q&Aも頻繁にチェックされているのか、質問を投稿するとすぐに回答をいただけるので助かりました。講義はおそらく今年撮影されたものだと思いますが、そのせいか最新トレンドの内容が多くて良いです。 まだ口コミが広まっていない講義のようですが、関連するトピックで勉強が必要な方に本当に強くおすすめします。
こんにちは、Wonjune leeさん。 心のこもった受講レビューをいただき、ありがとうございます! 受講生の皆様が十分に意味のある資料を受け取り、後で見返してもしっかりと復習ができるよう、講義資料のクオリティを高めるために試行錯誤を重ねました。 また、アテンションのような演算をどのように伝えれば効果的に伝わるかについても、深く悩みました。 私が出した結論は、数式だけで見てもいけないし、単に簡単な比喩で伝えてもいけない、そしてPyTorchのコードだけで説明してもいけないということでした。 目で流れを追いながら見てこそ理解できると考え、エクセルで最大限説明させていただきましたが、うまく伝わったようでとても嬉しいです :) 残りの部分もぜひ最後まで受講して、良い内容を吸収していただければと思います。 応援しています!

受講レビュー 33
∙
平均評価 4.5
受講レビュー 4
∙
平均評価 4.8
受講レビュー 2
∙
平均評価 4.5
知識共有者の他の講座はこちら
同じ分野の他の講座を見てみましょう!
新規会員登録で25%OFF
¥13,422
25%
¥17,892