inflearn logo

Lý thuyết thiết yếu cho thiết kế chất bán dẫn AI — từ nơ-ron đến LLM

Nếu muốn tự mình thiết kế các chất bán dẫn AI như NPU, bộ tăng tốc Transformer hay mini LLM, bạn cần nắm được bằng lý thuyết tại sao các phép tính bên trong chúng lại diễn ra. Khóa học này cô đọng trong ba phần những tinh túy lý thuyết thiết yếu cho thiết kế phần cứng, từ một nơ-ron đơn lẻ đến CNN, Transformer và LLM. Không phải là học thuộc công thức, mà là dùng trực giác để hiểu “tại sao lại như vậy”; một giáo sư đương nhiệm với 30 năm kinh nghiệm trong ngành bán dẫn sẽ kết nối lý thuyết phần mềm với việc triển khai phần cứng thành một thể thống nhất.

(4.0) 1 đánh giá

29 học viên

Độ khó Nhập môn

Thời gian Không giới hạn

Deep Learning(DL)
Deep Learning(DL)
Machine Learning(ML)
CNN
CNN
transformer
transformer
LLM
LLM
Deep Learning(DL)
Deep Learning(DL)
Machine Learning(ML)
CNN
CNN
transformer
transformer
LLM
LLM

Bạn sẽ nhận được điều này sau khi học.

  • Khả năng hiểu trực quan nguyên lý hoạt động của nơ-ron, mạng nơ-ron, CNN, Transformer và LLM

  • Nền tảng lý thuyết cốt lõi cần thiết cho thiết kế phần cứng AI, bao gồm học máy, phương pháp hạ dốc và lượng tử hóa.

  • Hiểu ở cấp độ nguyên lý về cách ChatGPT, GPT và BERT được tạo ra

  • Bức tranh toàn cảnh về cách lý thuyết AI được hiện thực hóa thành các mạch bán dẫn thực tế (NPU·bộ tăng tốc)

  • Nền tảng lý thuyết để có thể hiểu và theo kịp các bài thực hành thiết kế bộ tăng tốc AI và NPU sau này.

■ Vì sao cần khóa học này?

NPU, bộ tăng tốc Transformer, mini LLM — để trực tiếp thiết kế những chất bán dẫn AI như thế này, bạn cần biết bên trong chúng diễn ra những phép toán gì, tại sao chúng diễn ra, và những phép toán đó phải đánh đổi điều gì trên chip. Chỉ vẽ theo mạch điện thôi thì sẽ chạm đến giới hạn.

Khóa học này cô đọng nền tảng lý thuyết đó thành ba phần, chỉ chắt lọc những tinh túy thực sự cần thiết. Bắt đầu từ phép nhân của một nơ-ron cho đến CNN, attention, Transformer và LLM — giữa kho tàng lý thuyết AI rộng lớn, chúng tôi chỉ chọn lọc và đưa vào 'những gì thực sự cần thiết cho thiết kế phần cứng'.

Vì vậy, mỗi phần sẽ giải thích mối liên hệ với thiết kế bán dẫn.

Phần 1 đề cập đến thực tế rằng phép nhân và phép cộng của mạng nơ-ron trên chip chính là điện năng,

Phần 2 nói về việc các phép toán ma trận của attention đòi hỏi một bộ tăng tốc chuyên dụng gọi là systolic array,

Phần 3 khép lại với thực tế rằng một phần đáng kể năng lượng được tiêu thụ không phải cho tính toán mà cho việc di chuyển dữ liệu.

Đây không phải là lý thuyết nhằm đạt chiều sâu học thuật, mà là lý thuyết để trực tiếp tạo ra chất bán dẫn AI.


■ Lý do khóa học này khác biệt

Các khóa học lý thuyết AI trên thị trường thường chỉ dừng lại ở góc nhìn phần mềm và toán học. Khóa học này ngay từ đầu đã hướng đến 'lý thuyết để hiện thực hóa bằng phần cứng'. Phép nhân·phép cộng của nơ-ron được chuyển hóa thành mức tiêu thụ điện năng trên chip như thế nào, tại sao các phép toán ma trận của Transformer lại đòi hỏi bộ tăng tốc chuyên dụng (NPU), tại sao chất bán dẫn AI công suất thấp là tương lai — tất cả lý thuyết AI đều được giải thích dưới góc nhìn của một nhà thiết kế chất bán dẫn. Một giáo sư đang làm việc với 30 năm kinh nghiệm trong ngành công nghiệp bán dẫn kết nối lý thuyết phần mềm và hiện thực hóa phần cứng thành một thể thống nhất.


■ Bài giảng này là điểm khởi đầu

Khóa học này là điểm khởi đầu về mặt lý thuyết cho các khóa học thiết kế phần cứng tiếp theo.

· Bài giảng này (lý thuyết) → Thiết kế NPU → Bộ tăng tốc Transformer → mini LLM SoC

Chỉ khi có nền tảng lý thuyết được củng cố ở đây, bạn mới có thể hiểu và theo kịp các bài giảng sau, biết 'vì sao mạch này lại được thiết kế như vậy'. Ngược lại, nếu chỉ nhìn vào mạch mà không có lý thuyết, bạn sẽ chỉ học thuộc lòng và không thể vận dụng.


■ Cấu trúc gồm 3 phần

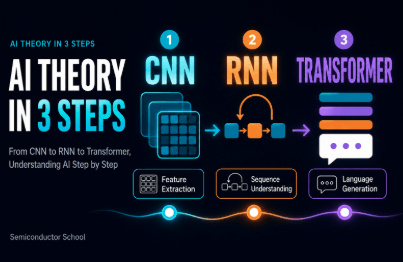
· Phần 1: Từ nơ-ron đến CNN — nguyên lý học (phương pháp hạ gradient), perceptron và bức tường XOR, mạng nơ-ron sâu (DNN), mạng nơ-ron tích chập (CNN)

· Phần 2 Từ RNN đến Transformer — dữ liệu tuần tự và RNN, word embedding, cơ chế attention, Transformer

· Phần 3: Từ Transformer đến LLM — tiền huấn luyện · học chuyển giao, BERT và GPT, ChatGPT và RLHF, cùng chất bán dẫn công suất thấp

Ba phần này là một câu chuyện liền mạch. Nếu học theo đúng thứ tự, bạn sẽ hoàn thiện bức tranh tổng thể từ nơ-ron đến LLM.


■ Khuyến nghị dành cho những người sau đây

· Dành cho những ai muốn trực tiếp thiết kế NPU, bộ tăng tốc AI và AI SoC trong tương lai (dựa trên nền tảng lý thuyết đó)

· Những người muốn củng cố tinh gọn lý thuyết nền tảng trước khi tham gia khóa học thiết kế phần cứng AI

· Dành cho những người muốn hiểu AI từ nguyên lý nhưng quan tâm đến “những điều cốt lõi để tạo ra” hơn là chiều sâu học thuật

· Dành cho những người đã từng nghe các thuật ngữ (CNN, Attention, Transformer, LLM) nhưng chưa nắm được nguyên lý hoạt động của chúng


■ Đây là một khóa học như thế nào?

· Chắt lọc những lý thuyết cần thiết cho thiết kế phần cứng — tinh hoa của kho tàng lý thuyết AI

· Tập trung vào trực giác thay vì học thuộc công thức — giải thích “tại sao lại như vậy” bằng hình ảnh và phép ví von

· Một câu chuyện liền mạch từ một nơ-ron đơn lẻ đến LLM

· Góc nhìn hiếm có kết nối lý thuyết AI với phần cứng bán dẫn

· Có thể hoàn thành toàn bộ chỉ bằng video, không cần thực hành, bo mạch hay cài đặt riêng biệt


■ Tham khảo

· Khóa học này là phần lý thuyết. Việc thực hành tự xây dựng bộ tăng tốc AI bằng FPGA sẽ được trình bày trong các khóa học riêng. Lý thuyết trong khóa học này là nền tảng cho những khóa học thực hành đó.

· Toàn bộ nội dung của khóa học này do giảng viên biên soạn, còn phần thuyết minh (giọng nói) được tạo bằng TTS.

Khuyến nghị cho
những người này

Khóa học này dành cho ai?

  • Những người muốn trực tiếp thiết kế NPU, bộ tăng tốc AI và SoC AI trong tương lai nhưng chưa có nền tảng lý thuyết.

  • Trước khi học khóa học về thiết kế phần cứng AI, tôi muốn củng cố kiến thức lý thuyết nền tảng một cách cô đọng.

  • Dành cho những người biết các thuật ngữ CNN, Attention, Transformer, LLM nhưng chưa nắm được nguyên lý hoạt động.

  • Dành cho những ai muốn hiểu AI từ nguyên lý, nhưng quan tâm đến 'cốt lõi để xây dựng' hơn là chiều sâu học thuật

Cần biết trước khi bắt đầu?

  • Giải thích dựa trên trực giác để có thể hiểu ngay cả khi không có kiến thức đặc biệt về cầu thủ.

  • Nếu biết toán học ở trình độ trung học phổ thông (hàm số, đồ thị) thì sẽ dễ dàng hơn.

  • Không cần lập trình hay thực hành (phần lý thuyết)

Xin chào
Đây là EdgeChipLab

Xác minh sự nghiệp

Trực tiếp thiết kế và triển khai chất bán dẫn AI bằng FPGA

Với tư cách là giáo sư đại học đương nhiệm, tôi đã đúc kết 30 năm kinh nghiệm trong ngành bán dẫn hệ thống cùng bí quyết nghiên cứu và đào tạo về chất bán dẫn AI.

Bắt đầu sự nghiệp với vai trò nghiên cứu viên chất bán dẫn hệ thống tại Bộ phận DS của Samsung Electronics, tôi đã được trao Giải Bạc Công nghệ Samsung (Giải thưởng của Chủ tịch Tập đoàn) trong lĩnh vực tự động hóa thiết kế. Sau đó, tôi lần lượt đảm nhiệm vị trí Giám đốc tại các pháp nhân ở Anh và Đức, Trưởng nhóm marketing·kinh doanh LSI hệ thống, và hiện đang giảng dạy kỹ thuật bán dẫn. Dựa trên những kinh nghiệm đó, chương trình này là một khóa học thực tiễn, trong đó bạn trực tiếp thiết kế và kiểm chứng trên FPGA.

Đây không chỉ là khóa học về cách sử dụng FPGA.
Bạn sẽ hiểu thuật toán AI → trực tiếp thiết kế NPU và CPU bằng RTL → triển khai trên FPGA → kiểm chứng trên phần cứng thực tế → hướng tới mở rộng đến AI SoC.

Thuật toán AI → Thiết kế RTL → Triển khai FPGA → Xác minh Bit-True → AI SoC


Vượt qua lý thuyết để triển khai phần cứng AI thực tế

Chỉ với những kiến thức rời rạc và manh mún thì khó có thể đạt được năng lực thiết kế chất bán dẫn AI ở cấp độ hệ thống.

Học viên không chỉ dừng lại ở việc sử dụng các IP dạng hộp đen đã hoàn thiện. Mục tiêu là từng bước xây dựng năng lực thiết kế hệ thống, có thể tự mình thiết kế NPU AI và CPU RISC-V, tích hợp bộ nhớ và các thiết bị ngoại vi, port RTOS trên nền tảng đó, và cuối cùng xây dựng AI SoC của riêng mình.

Bắt đầu từ nền tảng về transistor và mạch kỹ thuật số, khóa học kết nối các kiến thức này qua FPGA, CPU, NPU, cho đến phần cứng tăng tốc Transformer và LLM.


Kiểm chứng kết quả nghiên cứu trên phần cứng FPGA thực tế.

Đây không phải là một khóa học chỉ để xem bằng mắt. Không dừng lại ở lý thuyết hay mô phỏng đơn thuần, bạn sẽ cho mạch bán dẫn AI do chính mình thiết kế hoạt động trên FPGA thực tế và thực hiện kiểm chứng Bit-True, trong đó kết quả của mô hình Python và RTL khớp nhau đến từng bit.

Các kết quả nghiên cứu, bao gồm 4 bài báo được đăng trong KCI liên quan đến chất bán dẫn AI, FPGA và RISC-V của giảng viên cũng được kết nối với nội dung đào tạo, giúp chuyển các công nghệ đã được kiểm chứng trong nghiên cứu thành thiết kế thực tế và triển khai trên FPGA.

Công khai mã nguồn cần thiết cho thực hành, bao gồm CPU RISC-V tự phát triển, mã Python dùng để huấn luyện hình ảnh và Verilog RTL.

Được xây dựng xoay quanh bo mạch FPGA Arty S7-25 phổ thông và công cụ thiết kế Vivado miễn phí, khóa học giúp người học có thể tự mình tái hiện toàn bộ quy trình từ thiết kế, triển khai đến kiểm chứng.

Ngoài ra, cũng có thể sử dụng trên các bo mạch FPGA của Digilent, bao gồm Zybo Z7. Vui lòng điều chỉnh ánh xạ chân XDC (bo mạch) và tham số chia tần số xung nhịp (RTL) cho phù hợp với bo mạch.

'NPU MNIST được tạo bằng FPGA' chỉ cần sửa ánh xạ chân XDC, còn các bài giảng sử dụng OLED và Camera thì cần sửa tham số chia tần số xung nhịp (RTL).

→Phần thực hành của khóa học được thiết lập các tham số chia tần dựa trên xung nhịp đầu vào 100 MHz của Arty S7. Vì các bo mạch khác có xung nhịp đầu vào khác nhau (ví dụ: Zybo Z7 là 125 MHz), bạn cần tính toán lại giá trị chia tần để đạt được cùng tần số mục tiêu. Nếu bỏ qua phần này, màn hình hoặc video sẽ không hiển thị bình thường, nên rất dễ lầm tưởng là lỗi mã; vui lòng kiểm tra kỹ.


Lộ trình full-stack liền mạch: từ nền tảng đến bộ tăng tốc mini LLM

Tất cả các bài giảng không phải là những mảnh ghép rời rạc, mà là hành trình hoàn thiện một hệ thống khổng lồ.

  • Step 1: Cơ bản về lý thuyết AI và xử lý hình ảnh (bao gồm Machine Learning)

  • Step 2: Thiết kế và kiểm chứng bộ tăng tốc AI (NPU) (bao gồm Machine Learning)

  • Bước 3: Thiết kế CPU RISC-V và tích hợp hệ thống

  • Bước 4: Triển khai SoC AI nâng cao và mở rộng thành nền tảng tăng tốc mini LLM (liên tục cập nhật nội dung)


Các chỉ số kiểm chứng khách quan

Tất cả sản phẩm thiết kế của khóa học này đều đã trải qua quá trình kiểm chứng nghiêm ngặt theo các tiêu chuẩn toàn cầu và giới học thuật.

  • Kiểm chứng kiến trúc RISC-V: CPU RISC-V do chúng tôi tự phát triển đã vượt qua bài kiểm tra tuân thủ chính thức (ACT) của quỹ quốc tế và công khai mã nguồn (GitHub)

  • Uy tín học thuật: 4 bài báo học thuật với tư cách tác giả duy nhất (đăng trên tạp chí học thuật danh tiếng IJIBC được KCI xếp hạng A)

  • Được công nhận trên toàn cầu: Đã xuất bản 4 cuốn sách kỹ thuật trên Amazon toàn cầu (đạt vị trí số 1 về doanh số bán chạy nhất)


    Sách đã xuất bản: Roger Kim: sách, tiểu sử, cập nhật mới nhất

  • Hoàn tất xác minh hoạt động thực tế: Các IP cốt lõi như CPU RV32I, NPU, hệ thống thị giác, GPS, Transformer, SoC AURA-Edge đã hoạt động hoàn hảo trong môi trường Arty S7


Hãy thử thách bản thân. Khi hoàn thành quá trình tự mình tải mã lên bo mạch và kiểm tra kết quả này, bạn sẽ nâng cấp thành một kỹ sư phần cứng với góc nhìn hoàn toàn khác trước.

Thêm

Chương trình giảng dạy

Tất cả

3 bài giảng ∙ (1giờ 40phút)

Ngày đăng: 
Cập nhật lần cuối: 

Đánh giá

Tất cả

1 đánh giá

4.0

1 đánh giá

  • mdrifatnahid님의 프로필 이미지
    mdrifatnahid

    Đánh giá 1

    ∙

    Đánh giá trung bình 4.0

    4

    100% đã tham gia

    Vì có tiêu đề là “Chất bán dẫn” nhưng hầu như không có nội dung gì về chủ đề này. Tuy nhiên, khóa học phù hợp để bắt đầu học những kiến thức nền tảng rất cơ bản về AI.

    • estlit
      Giảng viên

      Cảm ơn bạn đã dành thời gian viết thư, cũng như dành những lời tốt đẹp cho phần kiến thức nền tảng — tôi rất vui vì phần đó hữu ích với bạn. Về tiêu đề, tôi xin chia sẻ mục tiêu của khóa học, hy vọng điều này sẽ giúp giải thích rõ hơn. Đây là tập lý thuyết trong một chuỗi khóa học về phần cứng. Các khóa học tiếp theo sẽ xây dựng một CPU RISC-V, một bộ tăng tốc CNN, một NPU và cuối cùng là một SoC LLM mini trên bo mạch FPGA thực tế — trong chuỗi này, một engine Transformer đã được triển khai và kiểm chứng trên FPGA. Tập này tồn tại vì những mạch đó rất khó thiết kế chỉ dựa trên sơ đồ. Bạn cần biết bên trong chúng đang thực hiện phép toán gì, và tại sao chúng lại tiêu tốn từng ấy tài nguyên. Vì vậy, phần lý thuyết AI ở đây được lựa chọn và trình bày nhằm phục vụ mục đích đó. Ví dụ: Phép nhân-tích lũy như một bài toán về công suất. Phần 1 khép lại bằng nhận định rằng mạng nơ-ron về bản chất là sự lặp lại khổng lồ của các phép nhân và phép cộng, và mỗi phép toán như vậy đều tiêu thụ công suất trên một chip thực tế. Chính nhận định đơn giản đó là nền tảng cho toàn bộ phần thảo luận về thiết kế tiết kiệm năng lượng ở các phần sau. Tích chập như một mẫu hình phần cứng. Bài giảng về phép tích chập mô tả một bộ lọc nhỏ trượt qua ảnh, thực hiện phép nhân và cộng trên các vùng chồng lấn. Cấu trúc cửa sổ trượt đó — trong đó cùng một bộ trọng số được tái sử dụng ở nhiều vị trí — chính là kiểu truy cập mà một bộ tăng tốc được xây dựng để khai thác. Tại sao Transformer cần một bộ tăng tốc chuyên dụng. Phần 2 giải thích rằng việc loại bỏ tính đệ quy giúp mọi từ có thể được tính toán song song, và bản chất của sự song song đó là các phép nhân ma trận quy mô lớn. Sau đó, phần này chỉ ra phép nhân ma trận sẽ trở thành gì trong silicon: sắp xếp các phép nhân-cộng đó thành một lưới và cho chúng chạy đồng thời chính là mảng tâm thu, cấu trúc cốt lõi của một NPU. Tại sao việc di chuyển dữ liệu chiếm phần lớn ngân sách năng lượng. Phần 3 chỉ ra rằng một phần lớn năng lượng của AI không được tiêu thụ cho bản thân các phép tính số học, mà cho việc di chuyển dữ liệu. Đây là ràng buộc mà mọi chip AI tiết kiệm năng lượng đều phải xoay quanh, và đó là lý do chuỗi khóa học kết thúc bằng hai hướng cần được thúc đẩy song song: giảm thiểu việc di chuyển dữ liệu và làm nhẹ mô hình. Mỗi phần trong số này đều kết thúc bằng cùng một câu trong bài giảng: đây là cầu nối đến phần cứng. Slide định hướng ở phần đầu đã nêu trực tiếp điều đó — mọi khái niệm trừu tượng trong khóa học này sau đó sẽ trở thành một phép toán thực tế trên silicon trong các phần tiếp theo của chuỗi, đó là lý do phần lý thuyết được xây dựng theo hướng có thể triển khai, thay vì thuần túy mang tính toán học. Bình luận của bạn cũng giúp tôi nhìn phần mô tả từ góc độ của người đọc. Hiện tại, ghi chú về vị trí của tập này trong toàn bộ chuỗi đang được đặt ở cuối trang — tôi sẽ đưa nội dung đó lên đầu để mọi người có thể hiểu rõ trước khi đăng ký. Xin chân thành cảm ơn bạn. EdgeChipLab
Khóa học khác của EdgeChipLab

Hãy khám phá các khóa học khác của giảng viên!

Khóa học tương tự

Khám phá các khóa học khác trong cùng lĩnh vực!

Giảm 25% cho thành viên mới

154.029 ₫

25%

205.369 ₫