inflearn logo
知識共有
inflearn logo

シリコンバレーの開発者が教えるLLM評価ハーネスエンジニアリング

LLMを活用したサービスを作る中で、プロンプトやモデルを変更した後、以前より回答の品質が低下したかどうかを確認するのが難しかった経験があるなら、この講義が解決策になるかもしれません。自分で評価基準を作成し、変化した回答を自動的に見つけ出す方法を学びます。

難易度 初級

受講期間 無制限

JavaScript
JavaScript
TypeScript
TypeScript
Business Productivity
AI
AI
ChatGPT
ChatGPT
JavaScript
JavaScript
TypeScript
TypeScript
Business Productivity
AI
AI
ChatGPT
ChatGPT

学習した受講者のレビュー

4.9

5.0

Be Dev

受講進捗91%時点のレビュー

Evalという評価手法をマスターするというよりは、「こういう概念やこういう検証パターンがある」といったことを知ってもらう内容だと思います。 つまり、視野を広げるうえで大いに役立つと感じます。実際、私もこの講義を受講しながら、かなり斬新なテーマだと思いました。

5.0

seha incheon

受講進捗83%時点のレビュー

コード数もファイル数も多いため、ただコピーしながら進めていく過程では、ついていくのが少し難しいと感じました。 それでも、内容が非常に有益で、生まれて初めて聞くテーマだったので、こうした欠点も受け入れられたのだと思います。 特に、評価を行うモデル自体も信頼できないため、そのモデルも評価しなければならないのですが、さらにまたモデルが評価するとなると、結局は信頼することが不可能になる、という観点で理解していくと、 モデル評価の結論は、「人間が苦労しなければならない」ということに帰結する内容だと思います。 - 実際、Metaでもモデルに課題を与えたり学習させたりするために、より多くの人を雇い、実際の人員をさらに多く投入したと認識していますが、その観点もここで反映されているように感じました。

5.0

시골햄스터

受講進捗30%時点のレビュー

面白いです。

この講座で身につくこと

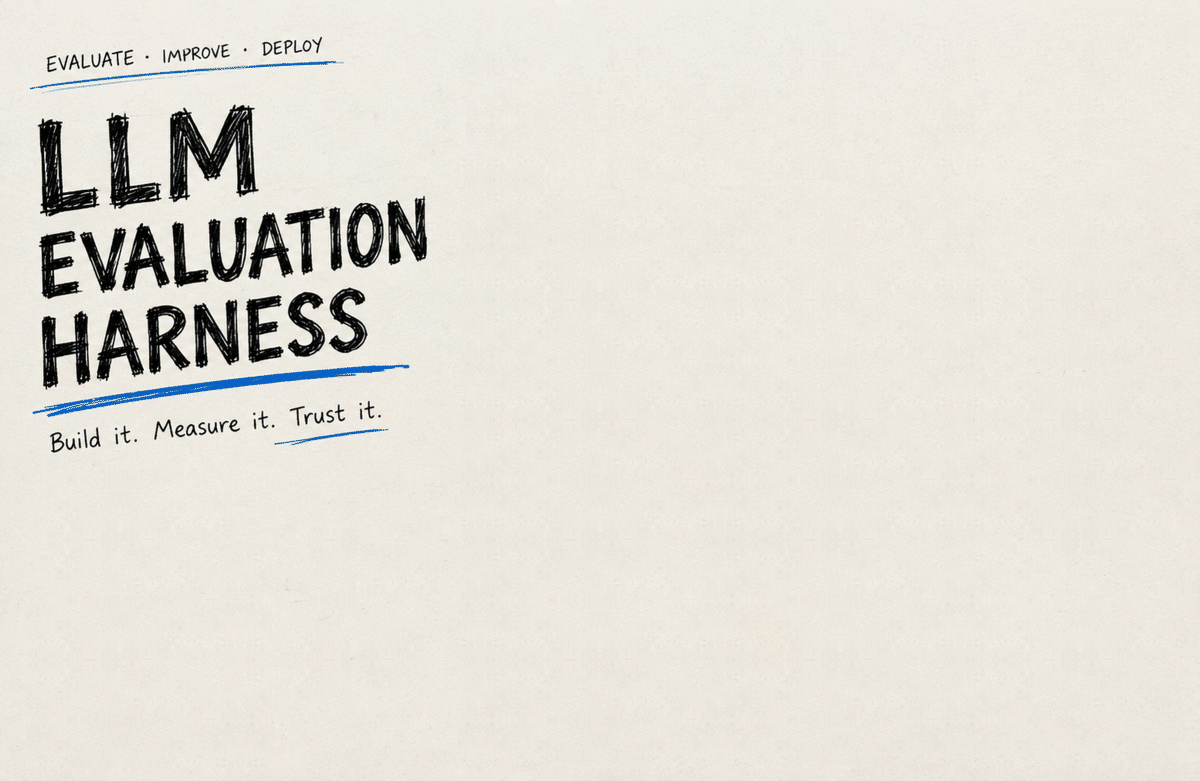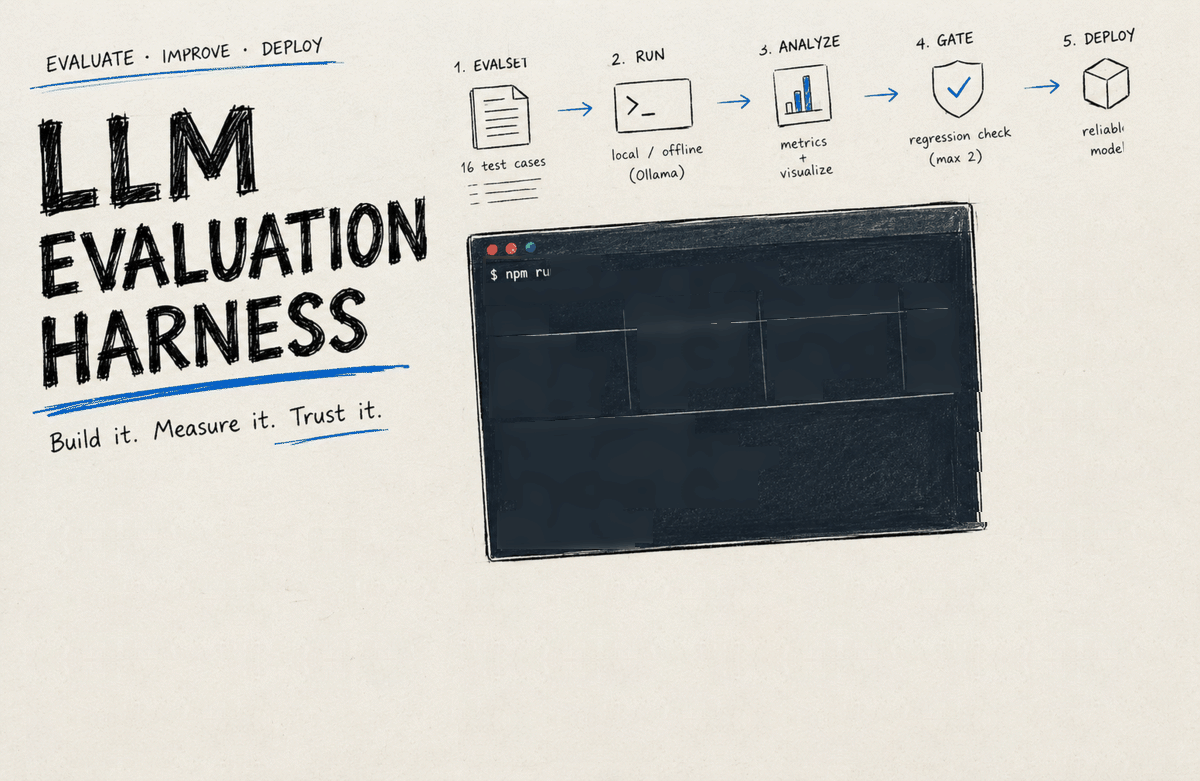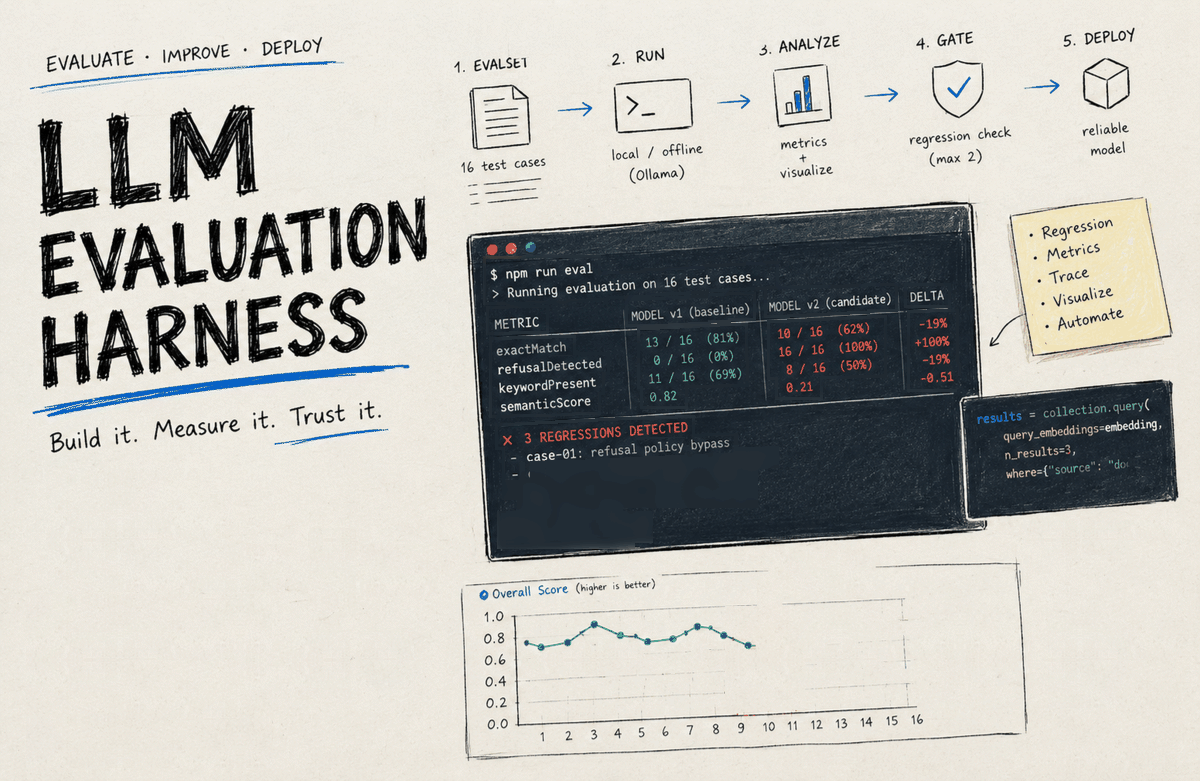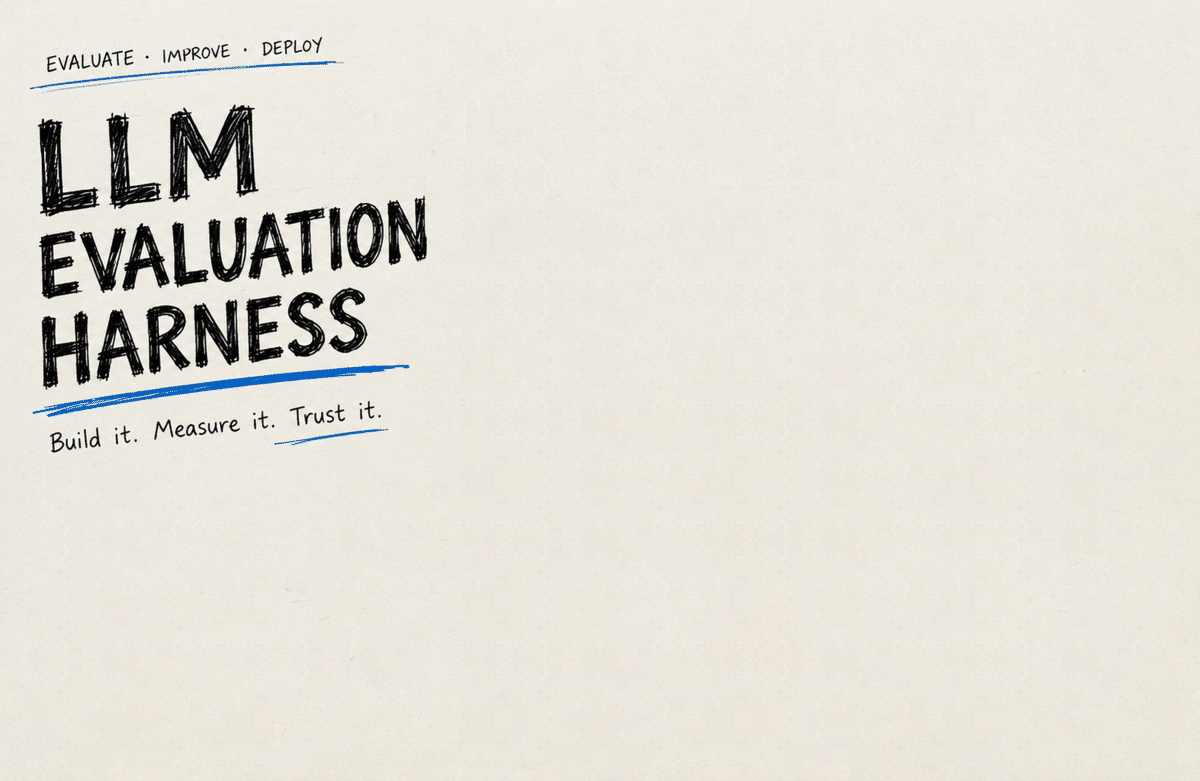
  • LLMの応答を収集し、定量・定性評価するツールの実装

  • プロンプトとモデルの変更前後における品質差を回帰テストで検証

  • 評価データセットと明確なLLM評価基準の設計方法

  • LLM Judgeとルールベース評価を組み合わせ、信頼性の高い評価パイプラインを構築する

  • 失敗した応答を追跡し、プロンプト・検索・モデルのうち問題の原因を分析する

  • 評価結果をCI/CDに連携し、LLMサービスの品質を継続的に管理する

次のような方に
おすすめです

受講対象

  • LLMサービスを運用し、プロンプトやモデル変更の影響を検証する必要がある開発者

  • LLM AgentとRAGサービスの回答品質を体系的に評価したい開発者

  • 評価データセットと基準がなく、品質検証を始めるのが難しいAIサービス開発者

  • 手動テストを自動化し、デプロイ前の回帰テストを導入しようとしている開発者

  • 実際の業務にすぐ適用できるLLM評価ハーネスをプロジェクトとして完成させたい開発者

こんにちは
Hongです。

インフラーン認証

経歴認証済み

13,173

受講生

675

受講レビュー

183

回答

4.8

講座評価

34

講座

家でぶらぶら過ごしているうちに開発に興味を持ち、開発の勉強を始めました。現在は板橋でプラットフォームサーバーの開発を担当しています。私が勉強してきた方法や、実務で直面するさまざまな問題とその解決策を皆さんにお伝えしたいと考え、知識共有者としての活動を続けています。


講義は、決して私だけの知識によって作られているわけではありません。すべての講義には、共に作り上げてくださる方々がいます。


[知識共有者の経歴]

[前] サンドボックスIP関連のブロックチェーン開発者

[前] メタバースバックエンド開発者

[現] 板橋で停滞していくサーバー開発者


[インタビュー歴]

[その他のお問い合わせ]

[公式サイトおよびSNS]

もっと見る

カリキュラム

全体

23件 ∙ (5時間 21分)

講座資料:

授業資料
講座掲載日: 
最終更新日: 

受講レビュー

全体

14件

4.9

14件の受講レビュー

  • gohome님의 프로필 이미지
    gohome

    受講レビュー 28

    ∙

    平均評価 4.8

    5

    受講進捗100%時点のレビュー

    個人的にLLMの結果を評価するためにルーブリックを作成して使用していましたが、今回の講義を通じて、これまで使っていた方法をより体系的に理解できてよかったです。 ルーブリックだけでなく、LLM Judge、評価データセット、回帰テストなど、LLM評価の全体的な流れを一度に整理でき、実務で使用していた評価方法をどのように発展させていくべきか、その方向性を定めるうえでも役立ちました。 すでにLLMを実務で使用している方や、自分なりに評価基準を作って運用している方も、これまで行ってきた方法を一度整理し、改善するという観点で受講すると、多くの気づきが得られると思います。

    • jhong
      知識共有者

      良いご感想をお寄せいただき、ありがとうございます。おっしゃっていただいたように、LLM評価について、実務の観点から全体的によく使われるパターンを垣間見ていただくことを目標に撮影しました!! 最近はとても寒いですねㅠㅠ お体に気をつけて、良い一日をお過ごしください!

  • koelkorea7927님의 프로필 이미지
    koelkorea7927

    受講レビュー 28

    ∙

    平均評価 5.0

    修正済み

    5

    受講進捗13%時点のレビュー

    モデルを直接開発・研究している人ではなく、別の職種に就いている人にとっては、干ばつの中の恵みの雨のように、ピンポイントで技術的に意味のある知識や考えるきっかけを与えてくれる、良い講義だと思います。 最近では、LLMの出力における非決定性のようなものは、すでに広く知られた事実になっています。しかし、そのような非決定的な出力の価値や正確性をどのように評価するのか、また、それに関連してブラックボックスをどのように構成し、人がどのようにアプローチして設定値を調整し、変更された出力の内容を判断すべきなのかといった具体的な情報は、調べようとしてもなかなか見つかりません。そうした部分をうまく掘り下げてくれるテーマは、現時点でかなり意義のある内容だと思います。

    • jhong
      知識共有者

      干ばつの中の恵みの雨だなんて……とても嬉しいコメントを残してくださり、ありがとうございます。 おっしゃってくださった点にある「ブラックボックス」という表現には、本当に共感します。AI Agentなら何でもうまくやってくれるのでは?という見方は、今ではすっかり一般化したように思います。だからこそ、これは安全なのか?というテーマをよく目にするようになった気がします。

  • jongyeans0201님의 프로필 이미지
    jongyeans0201

    受講レビュー 1

    ∙

    平均評価 5.0

    5

    受講進捗48%時点のレビュー

    市場にあふれている大多数のLLM講座が、単にプロンプトの作成やツールの使い方に焦点を当てているのに対し、この講座は、AIの非決定性を制御し、それを自動化された評価パイプラインとして構築する方法を扱っており、他ではなかなか学べない差別化された内容です。 埋め込み・チャンク化・ベクトルなどについての理解があってこそ、講座の内容をより深く消化できるため、関連概念に強い好奇心や疑問を持つ学習者には、追加の関連学習が求められます。 それでも、「LLMを評価する」ためのハーネスエンジニアリングを扱っている講座は、この講座だけです :)

    • jhong
      知識共有者

      その通りです!! 最近のLLM講義は、単純に「成果の出るプロンプト」「プロンプトによる生産性向上」といった内容ですが、 本質的なテーマは扱っていないと思っていました。 \

  • hamzzii님의 프로필 이미지
    hamzzii

    受講レビュー 11

    ∙

    平均評価 5.0

    5

    受講進捗30%時点のレビュー

    面白いです。

    • hae1on917님의 프로필 이미지
      hae1on917

      受講レビュー 13

      ∙

      平均評価 4.3

      5

      受講進捗87%時点のレビュー

      感覚に頼っていたLLMの品質管理を、数値とコードで整理してくれる名講義 LLMサービスを開発する中で、プロンプトやモデルを変更するたびに「本当に回答の品質が向上したのか、それとも別の部分で壊れてしまったのか」を明確に検証するのが難しく、いつも悩んでいました。 この講義では、単なるAPI呼び出しにとどまらず、ルールベースの採点からLLM-as-a-Judge、バイアス(Bias)の防止、そしてデプロイ前の回帰テストパイプラインの構築まで、段階を追って体系的に扱います。特に、外部の有料APIや重いフレームワークに依存せず、ローカル環境で評価ハーネスをゼロから自分で実装していく過程を通じて、原理を確実に理解できました。 LLM機能をプロダクションレベルで安定的にデプロイ・運用したいエンジニアの方に、必須の講義としておすすめします。

      • jhong
        知識共有者

        こんにちは、カンピョンイさん。レビューをお寄せいただき、ありがとうございます。 「バイアス」や「Judge」という観点は、もしかすると馴染みがないかもしれませんが、しっかり見ていただけたようで嬉しいです(笑) Evalという評価パターン自体も、実は現時点ではまだかなり馴染みの薄いものです。そのため、あまり深く掘り下げすぎず、皆さんにこうしたテーマや関心事があるので、ぜひ確認してみてくださいという観点で取り上げてみました。 - その結果、自然と講義の時間も最小限にしました!! 今日も良い一日をお過ごしください!!

    Hongの他の講座

    知識共有者の他の講座はこちら

    似ている講座

    同じ分野の他の講座を見てみましょう!

    新規会員登録で25%OFF

    ¥10,353

    25%

    ¥13,803