シリコンバレーの開発者と学ぶ実践AIエージェントの核心原理と拡張開発
Hong

¥13,729
29%
¥9,628入門 / JavaScript, TypeScript, AI, ChatGPT, AI Agent
5.0
(23)
300+
AIエージェントフレームワークは知っていても、その原理の理解や実務への応用は難しいですよね。シリコンバレーで実際に培ったノウハウをもとに、基本原理から実践的な活用方法までお伝えします。

入門
JavaScript, TypeScript, AI

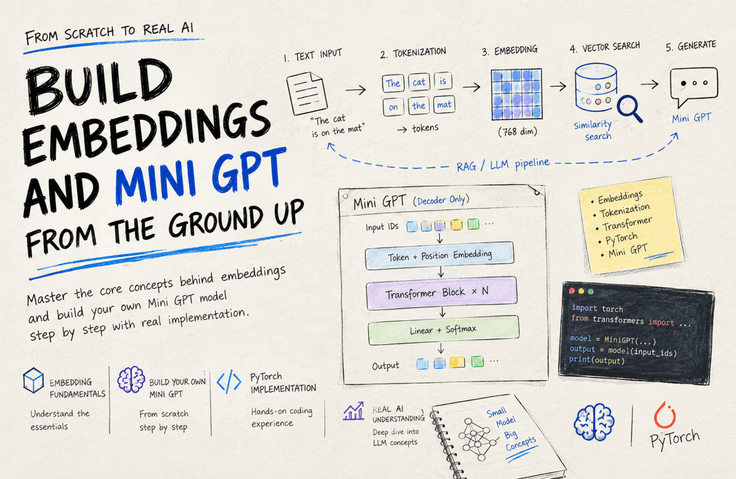
埋め込みAPIの呼び出し方は、どこででも学べます。ですが、結果がおかしいときにどこを見ればいいのかは、中身を開いて見た人にしか分かりません。シリコンバレーでAIを開発する経験13年のバックエンド開発者が、人の作ったツールに頼らず、ゼロからコードを書きながら、その中身を一緒にのぞきます。
同じ質問、異なる答え
"埋め込みですか? APIを呼ぶと数字がたくさん出てきます。それに意味が込められているそうですが。"
使い方は分かります。ですが、なぜそうなるのか、結果がおかしいときにどこを確認すべきかは分かりません。
"周囲に一緒に出てくる単語を当てさせて作った数字です。結果がおかしい場合は、学習が足りなかったのか、数字の数が足りないのかをまず確認します。"
原理で説明し、間違えたときにどこを確認すべきかが分かります。その違いを手作業で作り出します。
毎日使うGPT、
その中では何が起きているのでしょうか?
埋め込みAPIを呼び出すと、数字が次々と出てきます。GPTは次の単語を作り出します。ChatGPTは文脈を記憶します。使い方はわかっていても――"なぜそのように動くのか"を説明しようとすると、途方に暮れたことはありませんか?
この講義では、その中身を直接覗き込みます。説明を聞くだけではなく、コードを一行ずつ自分で書きながら。
この講義は、埋め込み・Word2Vec・Transformerを外部ライブラリなしでゼロから実装する実践型AI講義です。
"GPTはどうやって次の単語を知るのでしょうか?"
数字82万個分の小さなGPTが自分で書いた文章です。小さいので英単語は完全ではありませんが、「人物名の次に台詞が来る」という脚本の形は誰にも教えられていないのに、自ら学習しました。
文の中でどの単語がどの単語に注目すべきかを計算し、次の単語を選ぶ仕組みです。今私たちが使っているGPTは、すべてこの仕組みの上に成り立っています。この講義では、その仕組みをゼロから組み立て、上の文章を実際に作り出します。
"コンピューターは'意味'をどのように扱うのでしょうか?"
ルールを与えたことは一度もありません。「周囲に一緒に出てくる単語を当ててみて」とだけ指示したところ、動物は動物同士、食べ物は食べ物同士でまとまりました。(値は学習するたびに少しずつ変わります)
この結果を生み出すモデルを自分で学習させます。ディープラーニングフレームワークを使わず、TypeScriptで、学習ルールから一行ずつ組み立てます。
"本当にライブラリなしで作れるのでしょうか?"
類似度ライブラリを呼び出しているのではありません。掛けて、足して、割る三行がすべてです。意味を学ぶモデルも、GPTも、このように核心を一行ずつ自分で実装します。
ツールに頼らず、核心部分を一行ずつ自分の手で組み立てます。最後には"自分で組んだ埋め込みモデルと自分で組んだミニGPT"が手元に残ります。
“
ライブラリをimportする方法はどこでも学べます。
この講義では、その中で何が起きているのか、結果がおかしいときにどこを疑うべきかを手を動かして身につけます。
その感覚が、最終的に実力の差を生みます。
13年目のバックエンドサーバー開発者です。韓国内の複数の企業を経て、現在はシリコンバレーでAI関連の開発をしています。
埋め込みAPIの呼び出し方は、どこでも学べます。しかし、結果がおかしいときにどこを見ればよいのかは、中を開いて見た人にしか分かりません。その違いを生み出すプロセスを、そのままお伝えします。私が知っていることを、できるだけ分かりやすく、気軽にお届けします。
"埋め込みAPIの呼び出し方ではなく、その数値がどのように作られるのかを教えたかったのです。講義の準備をしながら自分でもう一度実装してみると、以前は知らなかった細部が新たに見えてきました。その過程をそのまま皆さんと一緒に進んでいきます。"


自分で作る順序が気になるなら
何を作り、何が手元に残るのかをまず見てみましょう
意味を数字として扱う方法から始め、意味を学ぶモデルと文章を書くモデルを順番に作ります。
2つの文がどれくらい近いかを数値で測る方法から作ります。公式を暗記するのではなく、コードで計算してみながら感覚をつかみます。(ベクトル・コサイン類似度・分布仮説)
"周囲に一緒に出てくる単語を当ててみて"とだけ指示し、単語の意味を身につけさせます。ツールを使わず最初からコードを書き、動物は動物同士、食べ物は食べ物同士で集まる様子を目で確認します。(Word2Vec・skip-gram)
答えが間違っていたとき、どの数値をどれだけ修正すべきか計算してくれる部品です。ディープラーニングフレームワークが代わりに行ってくれるその処理を自分で実装し、それを使って小さなニューラルネットワークを学習させます。(自動微分・逆伝播)
文中でどの単語がどの単語を見るべきかを計算する構造をゼロから組み立てます。シェイクスピアの台本を学習させ、誤差が減るにつれて文章が生成され始める様子を 自分の目で確認します。(トランスフォーマー・self-attention)
長い文章をモデルが扱いやすい断片に分けるルールを自分で作ります。次に、単語ではなく一つの文全体を数値に変換するところまで進みます。私たちが普段何気なく使っている埋め込みモデルがどのように作られているのかが分かります。(BPE・文埋め込み)
"OpenAIの埋め込みAPIを使いました"と"パラメータ82万個のトランスフォーマーをフレームワークなしで自分で実装しました"は、別の文です。後者を書くには中身を開いて見てみる必要があり、この講義がそのプロセスです。
6行すべて、この講義で実際に作り、実際に測定するものです。面接で"では、内部では何が起きているのですか"と聞かれても、答えられることが残ります。
理論スライドではなく、実際にコードを書く画面です。ミニGPTを一行ずつ完成させていく過程を、あらかじめご確認ください。
フィードフォワードネットワークのブロックとミニGPTの設計を、コードで一行ずつ書いていきます。各行ごとに、なぜこのように書くのかをコメントで一つひとつ説明します。完成した結果ではなく、作り上げていく過程をそのまま収めた講義の実際の画面です。
この講義で82万個規模で組むその構造が、ChatGPTとClaudeとGeminiが乗っているまさに同じ構造です。違うのは規模だけです。
この流れの中でAPIを呼び出せる人は、すでに大勢います。不足しているのは、結果がおかしいときに中身を開いて見られる人です。その差は、一度でも自分で組んでみたことがあるかどうかで分かれます。
出典:OpenAI公式発表(2026年2月、週間アクティブユーザー)・Sensor Tower State of AI 2026(Claudeの月間アクティブユーザー)・Anthropic発表(Fortune 100顧客の割合)・Semantic Scholarの引用数(2026年初頭時点)
以下のいずれか一つでも当てはまるなら、この講義はすぐに役立ちます。
以下の数値は、講義で実際に実行して得られた値をそのまま記載したものです。
WORD2VEC · 講義 E
150文を自分で組んだ学習コードで実行しました。予測の誤差が0.69から0.16まで下がると、「自動車」と尋ねた際に、自転車・地下鉄・電車・バスが0.970~0.995で近いものとして出力されます。
BPEトークナイザー・講義 F
頻繁に一緒に現れる文字のペアを結合するルールを50個だけ学習させたにもかかわらず、分割数が半分以下に減りました。一度に読み取れる量が2倍以上に増えるということです。
どちらもインストールするだけで無料で動作します。アカウントも、支払いも、GPUも必要ありません。
ミニGPTと残りの部分をPython + PyTorchで作ります。ただし、借りるのは数値計算と学習の補助までです。文の中で何に注目すべきかを計算する部分は、すべて自分で実装します。そうしてこそ、中身が見えるからです。
llama3.2とbge-m3を自分のノートパソコンで起動します。APIキーも料金もかかりません。最後には、自作した82万パラメータのミニGPTをここに用意した巨大モデルと並べて、何が違うのかを見てみます。
前半の3パートはTypeScriptで、後半の2パートはPython + PyTorchで進めます。どちらの言語も基本文法を読めれば、ついていけます。
大がかりな準備は必要ありません。ノートパソコン1台があれば始められます。
変数、関数、繰り返し文程度で十分です。数学やディープラーニングの理論は、講義内で必要な分だけ扱います。他の講義を先に受講する必要はありません。
講義はmacOS(zsh・Homebrew)を基準に進めます。埋め込み・LLMはすべてローカル(Ollama)で無料で動かします。GPUなしでも完走できます。
OpenAIのような有料APIキーは必要ありません。GPUもクラウドサーバーも必要ありません。オープンソースとローカルモデル(Ollama・bge-m3・llama3.2)だけで、最初から最後まで完走できます。
受講前に最も多く寄せられる疑問をまとめました。
今すぐ始めてください
GPTの内部を直接
覗き込む旅、
コードを1行ずつ一緒に作り上げていきます。
外部APIなしで、GPUなしで、最初から最後までローカルで完遂します。
学びは講義の外でも続きます。開発者たちが集まり、キャリアの悩みや現場の状況、技術の話を自由に語り合うKakaoTalkオープンチャットを運営しています。講義を受けていて行き詰まったところも、気軽に聞いてみてください。