Vivado·Python 기반 FPGA·NPU·CPU 설계환경 구축
EdgeChipLab
무료
입문 / Python, FPGA, jupyter-notebook, vivado
New
New
본 강좌는 FPGA 및 NPU 설계 실습에 필요한 AMD Vivado와 Python 개발환경을 처음부터 직접 구축하는 무료 과정입니다.

입문
Python, FPGA, jupyter-notebook
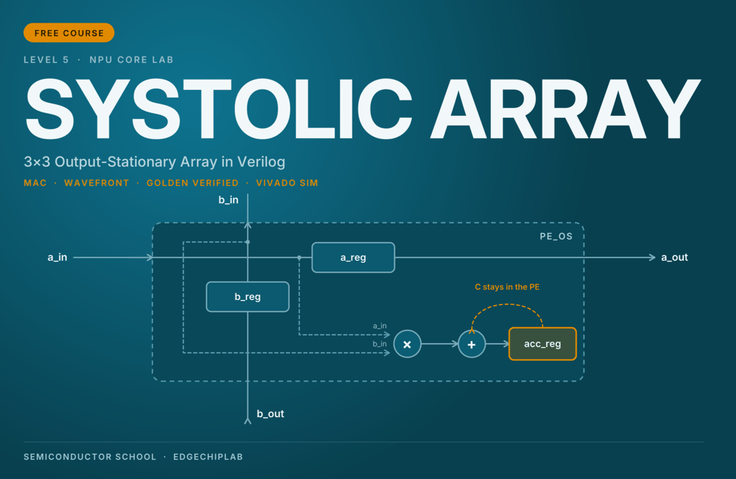
AI 반도체의 핵심 병렬 연산 구조인 Systolic Array를 Verilog로 직접 구현하고 Vivado 시뮬레이션으로 검증하는 무료 실습 강좌입니다. 3×3 Output-Stationary 구조를 예제로 Processing Element 설계부터 Input Skewing, Wavefront 분석, Testbench 검증까지 단계별로 학습하며, FPGA 보드 없이도 AI NPU의 기본 연산 원리를 완전히 이해할 수 있습니다.
1명 이 수강하고 있어요.
난이도 초급
수강기한 무제한
Systolic Array의 병렬 연산 원리와 PE 간 데이터 흐름 분석
Verilog RTL을 이용한 3×3 PE Array 및 MAC 연산기 설계
Vivado 시뮬레이션과 Golden Reference 기반 하드웨어 검증
AI 반도체의 병렬 연산 구조, 직접 Verilog로 구현하고 검증해 보세요!
AI 반도체의 핵심은 수많은 곱셈과 덧셈을 빠르고 효율적으로 처리하는 것입니다.
일반적인 순차 연산 방식과 달리, AI NPU는 여러 연산기를 병렬로 배치하여 데이터를 동시에 처리합니다. 이러한 병렬 연산을 구현하는 대표적인 하드웨어 구조가 Systolic Array(시스톨릭 어레이)입니다.
본 강좌에서는 3×3 Systolic Array를 실제 Verilog RTL로 구현하고, Vivado 시뮬레이션을 통해 동작을 검증하는 과정을 학습합니다.
단순히 코드를 설명하는 데 그치지 않고, 데이터가 Processing Element(PE) 사이를 어떻게 이동하는지, 각 PE가 어느 사이클에 연산하는지, 최종 결과가 정확한지를 단계적으로 확인합니다.
FPGA 보드 없이 Vivado만으로 학습할 수 있는 무료 AI NPU 설계 실습 강좌입니다.
3×3 Output-Stationary Systolic Array 구현
Systolic Array의 기본 구조와 병렬 행렬 곱 연산 원리를 학습합니다.
Output-Stationary 구조에서는 입력 데이터 A와 가중치 B가 PE 사이를 이동하고, 곱셈 결과는 각 PE 내부의 누적기에 저장됩니다.
Systolic Array와 Output-Stationary Dataflow
Processing Element(PE)와 MAC 연산 구조
입력 데이터 Forwarding과 Local Accumulation
Signed/Unsigned 데이터 처리
Generate 구문을 이용한 3×3 PE Array 구성
Input Skewing, Wavefront 및 Testbench 구현
Systolic Array에서는 데이터를 단순히 동시에 입력하는 것이 아니라, 각 PE에 필요한 데이터가 정확한 시점에 도착하도록 입력 타이밍을 조정합니다.
이러한 Input Skewing과 Wavefront의 원리를 이해하고, Testbench를 통해 데이터 흐름을 관찰합니다.
Input Skewing과 데이터 도착 타이밍
대각선 방향으로 진행하는 Wavefront
PE별 연산 시작 시점과 활성 구간
Testbench를 이용한 입력 데이터 주입
Golden Reference를 활용한 자동 검증 구조
Golden Data 검증, 성능 분석 및 NPU 확장
Vivado 시뮬레이션을 실행하고, 3×3 행렬 곱 결과가 Excel에서 계산한 Golden Matrix와 일치하는지 확인합니다.
9개의 PE가 7사이클 동안 연산하는 과정을 분석하고, 병렬 연산의 특징을 이해합니다.
Vivado Behavioral Simulation
Simulation Log와 Waveform 분석
Fill, Peak, Drain 단계별 PE 동작
7사이클 Wavefront와 PE Utilization
Golden Matrix 비교 및 total_errors = 0 확인
Parametric Array 구조와 확장 개념
Quad-Core 및 CIFAR-10 NPU 응용 구조 소개
1. AI NPU의 핵심 연산 구조 이해
Systolic Array가 여러 PE를 이용하여 행렬 곱을 병렬로 처리하는 원리를 이해할 수 있습니다.
2. 실제 Verilog RTL 설계 구조 학습
PE, MAC, Forwarding Register, Generate 구문을 활용하여 병렬 연산 하드웨어를 구성하는 방법을 배웁니다.
3. 사이클 단위의 하드웨어 동작 분석 능력
Input Skewing과 Wavefront를 이해하고, 시뮬레이션 로그와 파형을 통해 PE별 연산 과정을 추적할 수 있습니다.
4. Golden Reference 기반 검증 방법 이해
RTL 시뮬레이션 결과를 Excel Golden Matrix와 비교하여 하드웨어 연산의 정확성을 검증하는 방법을 학습합니다.
5. AI NPU 심화 설계를 위한 기초 역량
3×3 Systolic Array를 출발점으로, 더 큰 PE Array와 다중 코어 NPU 아키텍처의 확장 개념을 이해할 수 있습니다.
Verilog-HDL 기초를 학습하고 실제 하드웨어 설계 예제를 경험하고 싶은 분
AI 반도체와 NPU의 내부 연산 구조가 궁금한 대학생 및 입문자
FPGA를 활용한 병렬 연산 및 디지털 회로 설계에 관심 있는 분
MAC, Processing Element, Systolic Array의 동작 원리를 이해하고 싶은 분
Vivado 시뮬레이션과 Testbench 기반 검증을 학습하려는 분
향후 AI NPU, CNN 가속기 및 FPGA 기반 AI 시스템 설계에 도전하려는 분
권장 선수 지식
디지털 논리회로의 기본 개념
Verilog-HDL의 Module, Always, Register 및 Generate 문법
Clock 기반 순차회로의 동작 원리
행렬 곱셈의 기본 개념
실습 환경
Xilinx Vivado (Behavioral Simulation)
제공되는 Verilog RTL 및 Testbench 소스코드
FPGA 보드 불필요
본 강좌는 시뮬레이션 중심 실습이며, FPGA 보드 구현과 타이밍 클로저는 포함되지 않습니다.
본 강좌는 EdgeChipLab의 단계별 FPGA·AI 반도체 교육과정 중 Systolic Array 구현을 다루는 실습 과정입니다.
Verilog-HDL 문법이 익숙하지 않은 분은 무료 강좌 「디지털 반도체 설계를 위한 Verilog-HDL 입문」을 먼저 수강하시는 것을 추천합니다.
또한 Systolic Array의 병렬 연산 원리를 충분히 이해하려면 선행 이론 강의인 「NPU Systolic PE 구조의 이해」를 함께 학습하면 좋습니다.
이후에는 EdgeChipLab에서 제공하는 다양한 FPGA 설계 및 AI NPU 실습 과정으로 학습을 확장할 수 있습니다.
Verilog 코드가 실제 병렬 연산 하드웨어로 동작하는 과정, 이번 무료 강좌에서 직접 확인해 보세요.
Semiconductor School | EdgeChipLab
학습 대상은
누구일까요?
Verilog-HDL 기초를 익히고 실제 RTL 설계 예제를 경험하고 싶은 하드웨어 입문자
AI 반도체와 NPU의 내부 연산 구조에 관심 있는 전기전자공학 전공 대학생
FPGA 기반 병렬 연산 하드웨어 설계와 CNN 가속기 개발을 목표로 하는 엔지니어
선수 지식,
필요할까요?
디지털 논리회로의 기본 개념과 Clock 기반 순차회로 동작 원리
Verilog-HDL의 기본 문법 및 모듈 설계 경험
행렬 곱셈의 기초 개념과 Xilinx Vivado 시뮬레이터 사용 환경
커리어인증
현직 대학교수로서 시스템 반도체 산업 30년의 경험과 AI 반도체 연구·교육 노하우를 담았습니다.
삼성전자 DS부문 시스템반도체 연구원을 시작으로 영국 및 독일법인 Director, 시스템 LSI 마케팅·영업 그룹장을 거쳐 현재 반도체 공학을 교육하는 교수가 직접 설계하고 FPGA에서 검증한 실전형 커리큘럼입니다.
단순히 FPGA 사용법을 배우는 교육이 아닙니다.
AI 알고리즘을 이해하고 → NPU와 CPU를 RTL로 직접 설계하고 → FPGA에 구현하고 → 실제 하드웨어에서 검증하여 → 궁극적으로 AI SoC까지 확장하는 과정을 지향합니다.
AI Algorithm → RTL Design → FPGA Implementation → Bit-True Verification → AI SoC
흩어진 단편적인 지식만으로는 시스템 수준의 AI 반도체 설계 역량에 도달하기 어렵습니다.
수강생은 완성된 블랙박스 IP를 사용하는 데 머무르지 않습니다. AI NPU와 RISC-V CPU를 직접 설계하고, 메모리와 주변장치를 통합하며, 최종적으로 자신만의 AI SoC를 구축할 수 있는 시스템 설계 역량을 단계적으로 갖추는 것을 목표로 합니다.
트랜지스터와 디지털 회로의 기초에서 시작하여 FPGA, CPU, NPU를 거쳐 Transformer와 LLM 가속 하드웨어까지 연결합니다.
눈으로만 보는 강의가 아닙니다. 이론이나 단순한 시뮬레이션에서 끝내지 않고, 직접 설계한 AI 반도체 회로를 실제 FPGA에서 동작시키고 Python 모델과 RTL 결과가 1비트까지 일치하는 Bit-True 검증을 수행합니다.
강사의 AI 반도체·FPGA·RISC-V 관련 KCI 등재 논문 4편을 포함한 연구 결과도 교육 콘텐츠와 연결하여, 연구에서 검증한 기술을 실제 설계와 FPGA 구현으로 이어갑니다.
자체 개발한 RISC-V CPU를 비롯하여 이미지 학습용 Python 코드와 Verilog RTL 등 실습에 필요한 소스 코드를 공개합니다.
보급형 Arty S7-25 FPGA 보드와 무료 Vivado 설계 도구를 중심으로 구성하여, 학습자가 직접 설계하고 구현하고 검증하는 전 과정을 재현할 수 있도록 하였습니다.
또한 Zybo Z7을 포함한 Digilent사 FPGA 보드에서도 사용 가능합니다. XDC 핀 매핑(보드)과 클럭 분주 파라미터(RTL)를 보드에 맞게 수정하시면 됩니다.
'FPGA로 만드는 MNIST NPU'강의는 XDC 핀 매핑만 수정하면 되며, OLED와 Camera를 사용하는 강의는 클럭 분주 파라미터(RTL)를 수정해야 합니다.
→강의 실습은 Arty S7의 100 MHz 입력 클럭을 기준으로 분주 파라미터가 설정되어 있습니다. 다른 보드는 입력 클럭이 다르므로(예: Zybo Z7은 125 MHz), 목표 주파수가 동일하게 나오도록 분주 값을 다시 계산해 주셔야 합니다. 이 부분을 놓치면 화면이나 영상이 정상적으로 출력되지 않는데, 코드 오류로 오해하기 쉬우므로 확인해 주시기 바랍니다.
모든 강의는 독립된 파편이 아닌, 하나의 거대한 시스템을 완성해 가는 여정입니다.
Step 1: AI 이론 및 이미지 처리 기초 (Machine Learning 포함)
Step 2: AI 가속기(NPU) 설계 및 검증 (Machine Learning 포함)
Step 3: RISC-V CPU 설계 및 시스템 통합
Step 4: 고급 AI SoC 구현 및 mini LLM 가속 플랫폼으로의 확장 (지속적인 콘텐츠 업데이트)
본 과정의 모든 설계 결과물은 글로벌 표준과 학계의 엄격한 검증을 거쳤습니다.
RISC-V 아키텍처 검증: 자체 개발 RISC-V CPU, 국제재단 공식 컴플라이언스 테스트(ACT) 통과 및 소스 코드 공개 (GitHub)
학술적 권위: 단독 저자 학술논문 4편 (KCI A등급 저명학술 등재지 IJIBC)
글로벌 인정: 글로벌 Amazon 기술 서적 4편 출간 (베스트셀러 1위 달성)
실제 동작 검증 완료: RV32I CPU, NPU, 비전 시스템, GPS, Transformer, AURA-Edge SoC 등 핵심 IP의 Arty S7 환경 완벽 동작
도전하십시오. 직접 코드를 보드에 올리고, 결과를 확인하는 이 과정이 끝날 때쯤, 여러분은 이전과는 완전히 다른 시야를 가진 하드웨어 엔지니어로 레벨업해 있을 것입니다.
YouTube:@EdgeChipLab
Homepage: Semiconductor School
GitHub (소스코드 및 프로젝트):github.com/estlit
전체
3개 ∙ (15분)
지식공유자님의 다른 강의를 만나보세요!
같은 분야의 다른 강의를 만나보세요!
무료