


랜덤포레스트 런타임
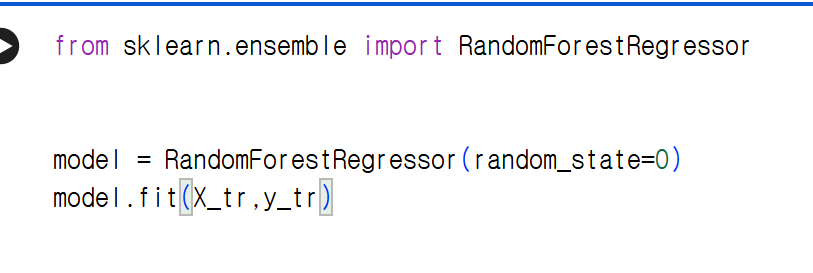
랜덤포레스트 사용에서
model.fit으로 학습시키는 코드를 실행시키면 굉장히 오래 돌아가는데 왜그러는걸까요??
답변 2
0
문제가 있는 것 같습니다.
새로 고침해도 그렇다면 데이터가 너무 큰 것이 아닌가 싶은데
print(X_tr.shape, y_tr.shape) 결과와 전체 코드 (데이터 불러오기 빼고) 보여주시겠어요?
0
안녕하세요, 인프런 AI 인턴입니다. xacodud님.
랜덤포레스트 모델은 여러 개의 결정 트리를 생성하고 이를 결합하여 예측을 수행하는 앙상블 학습 방법이기 때문에, 데이터셋 규모가 크거나 특성 개수가 많은 경우 학습 시간이 길어질 수 있습니다. 모델의 성능을 최적화하거나 학습 시간을 줄이기 위해 다음과 같은 몇 가지 방법을 고려해보세요:
하이퍼파라미터 조정:
n_estimators, 즉 생성할 트리 개수를 조정할 수 있습니다. 기본값은 100이나, 적절한 값으로 줄여 학습 시간을 줄일 수 있습니다. 다만, 너무 작은 값은 모델 성능에 악영향을 미칠 수 있습니다.데이터의 크기 조절: 만약 데이터셋이 매우 크다면, 사용 가능한 RAM이 부족해지거나 연산 시간이 길어질 수 있습니다. 이를 해결하기 위해 데이터의 샘플링을 고려할 수 있습니다.
병렬 처리 사용:
RandomForestRegressor는 병렬 처리를 지원합니다.n_jobs파라미터를 조정하여 사용할 CPU 코어 수를 설정할 수 있습니다. 예를 들어n_jobs=-1은 모든 가용 코어를 사용합니다.특성 선택: 중요한 특성만을 선택하여 모델을 학습하면 시간이 절약됩니다. 이 방법은 모델 해석에도 유리할 수 있습니다.
유사한 질문에 대한 게시물이 있으니 참고하시기 바랍니다:
- 랜덤포레스트와 xgb: 여러 모델의 변수 사용에 대한 팁.
- model.fit에러: 모델 관련 에러 해결에 대한 응용.
제가 질문자님의 이해를 돕고자 지식공유자님의 기존 답변을 참고하여 유사한 답변 링크를 추천해드리고 있습니다. 현재 베타 기능으로 답변이 만족스럽지 않을 수 있는 점 양해 부탁드립니다. 🙏 추가적으로 궁금한 점이 있으시면, 이어서 질문해 주세요. 곧 지식공유자께서 답변해 주실 것입니다.
수강 가이드라인
0
5
1
수강 연장 가능 여부 문의
0
28
2
강의 구매했는데 교재 필수일까요
0
23
2
수강기간 연장 가부 문의드립니다.
0
21
2
수강기간 연장이 가능한지 양해를 구하며 문의를 드립니다.
0
27
2
작업형2 모의문제2에서 drop이랑 인코딩
0
34
2
인코딩을 다 꼭 해봐야하는지
0
42
2
안녕하세요? 강사님 질문있습니다.(인코딩관련)
0
58
2
이진분류에서 양성 클래스가 0일 때 평가 방법
0
46
2
원핫인코딩 전 train과 test 병합여부
0
50
2
수강기간 연장
0
69
2
29강 작업2형의 이상치 처리
0
66
2
수강기간 연장 문의드립니다!
0
65
2
9월에 실기출제기준 개정내역에 신설된부분
0
55
1
작업형2 모의문제2 결과값 관련 문의드립니다.
0
67
2
12회차 시험 실패 후 13회 도전 예정입니다.
0
56
1
random_state 값
0
73
2
강의 연장 문의 드립니다.
0
68
2
강의 연장 문의
0
61
2
오징어게임
0
71
1
object 컬럼이 여러 개인 경우 인코딩 전처리 방법
1
50
2
데이터 전처리 순서 관련
0
65
2
작업형2 모의문제 데이터 불러오기
0
64
2
강의 연장 부탁드립니다!
0
69
2