블로그

한국인에게 딱 맞는 AI, 클로바 X 체험기

ChatGPT가 출시된 이후로, 계속해서 대화형 AI가 기하급수적으로 늘고 있는데요. 그중 최근 주목할 만한 새로운 AI가 등장했습니다. 네이버에서 출시한 CLOVA X! 다른 AI와 어떤 게 비슷하고 무엇이 다른지, 그리고 우리는 클로바 X를 어떻게 활용할 수 있을지 알아보기 위해 직접 사용해 봤습니다!클로바 X, 그것이 알고 싶다!CLOVA X는 네이버에서 대형 언어 모델(LLM)*을 활용해서 만든 대화형 인공지능 서비스입니다. 약 두 달 전 출시되었으며 한국을 대상으로 하여 한국어 버전으로만 출시되었어요. (추후 다른 언어를 추가할 가능성도 있다고 해요.) 오픈AI의 GPT-3.5와 비교했을 때 한국어를 6,500배 더 많이 학습했다고 해요! 아직까지는 서비스 안정성을 위해 대화 횟수에 제한을 두고 있으며, 3시간에 최대 30개까지 질문이 가능하다고 합니다.대형 언어 모델(Large Language Model)*이란?대규모의 데이터에서 얻은 지식을 기반으로 다양한 콘텐츠를 인식하여 요약, 번역, 예측, 생성 등을 할 수 있는 딥러닝 알고리즘입니다. 대규모라고 불리는 만큼, 오랜 기간 동안 인터넷에 작성된 거의 모든 것을 데이터로 훈련합니다. 네이버가 만든 서비스이기 때문에 네이버 계정으로 로그인하면 누구나 바로 사용이 가능하고, 사용법은 다른 대화형 AI 모델들과 비슷해서 사용하기에 어렵지 않았어요. 기존 생성형 AI와 다른 점은 skill이라는 부분인데, 사용할 스킬을 선택한 후 질문을 입력하면 선택한 스킬을 활용하여 최적의 답변을 제공해 줍니다. 현재까지는 스킬에 '네이버 쇼핑'과 '네이버 여행'이 추가되어 있으며 지속적으로 업데이트될 예정이라고 합니다.  (▲ '블라우스 추천해 줘.' 라는 질문에 네이버 쇼핑과 연동하여 링크를 보여줘요.)예를 들어, '네이버 쇼핑' 스킬을 선택 후 '블라우스 추천해 줘.' 등과 같이 쇼핑과 관련된 질문을 입력하면 네이버 쇼핑의 최신 정보를 연동해서 최저가나 상품 정보에 대한 추천 등을 답변으로 받을 수 있어요. 직접 써보면서 느꼈을 때는 네이버와의 연동성이 좋은 것 같았어요.국내 정보는 꽉 잡고 있다구! (▲ 유행했던 도도독 밈에 대해서 물어봤는데, 정확하게 파악하고 있어서 놀랐습니다.)클로바 X는 한국 특화형 AI이기 때문에 한국에서만 쓰이는 줄임말이나 유행어, 사투리, 근처 맛집이나 카페 등에 대한 질문을 했을 때 정확도가 높은 편이에요. 네이버의 방대한 한국어 자료를 학습하여 우리들이 일상생활에서 클로바 X를 자연스럽게 사용할 수 있는 부분이 장점으로 꼽히기도 해요. 출처: MBC 무한도전전반적인 평가는요CLOVA X에 대한 평가는 아직 많이 나뉘는 중입니다. 검색, 맛집 찾기 등에 대해 엉뚱한 답을 내놓는 다른 AI 서비스들에 비해서는 긍정적인 부분도 있지만, 아쉬운 부분들이 있다는 평가도 있어요. 문장을 직접 만들어 내거나, 전문적인 내용에 대해 물어봤을 때 나오는 답변이 상당히 부정확한 경우가 많기 때문이에요.그럼에도 나름 최신 정보들을 위주로 알려준다는 점, 답변을 주면서 정보의 출처까지 알려준다는 점, 할루시네이션*이 적은 AI라는 점들이 클로바 X만의 장점으로 꼽히기도 합니다. 할루시네이션(Hallucination)*이란?AI가 정보를 처리하는 과정에서 발생하는 오류를 뜻합니다. 정확하지 않거나 사실이 아닌, 조작된 정보를 생성하는 것을 의미해요. 원래의 뜻은 환각, 환영, 환청 등으로 사용됩니다.그 외 이런 것들도 있어요큐 (생성형 AI)생성 AI를 검색에 접목함복잡한 질의 의도를 빠르게 파악하여 검색 편의를 제고함네이버 검색에 축적된 다양한 콘텐츠 통해 풍성한 검색 결과를 보여줌클로바 스튜디오 (비즈니스 도구)사용자의 목적에 맞는 AI 모델을 노코드로 작업할 수 있음기업이 보유한 데이터를 하이퍼 클로바 X에 결합하여 자체적인 AI 모델 제작 가능프로젝트 커넥트 X (기업 업무 생산성 도구) 기업에서 사용하는 협업툴에 AI를 접목한 서비스문서 자료를 기반으로 일정 관리, 초안 작성, 이메일 답장 제안 등 업무 생산성을 높이는 것에 주목직접 사용해 본 결과 클로바 X는 전문적인 내용을 배우기 위해 사용하기보다는, 일상에서 편하게 사용할 수 있는 느낌인 것 같았어요. 실제로 네이버 쇼핑이나 네이버 여행 등의 스킬을 활용하고, 근처 맛집이나 실생활 정보를 물어보는 등 다양한 부분에서 편하게 잘 사용할 수 있을 것 같아요!

마케팅・클로바X・네이버・AI・채팅・생성형・LLM・큐・클로바스튜디오・프로젝트커넥트x・할루시네이션

일코

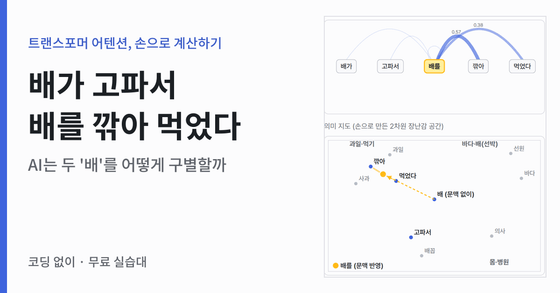
배가 고파서 배를 깎아 먹었다: AI는 두 '배'를 어떻게 구별할까

"배가 고파서 배를 깎아 먹었다."이 문장에서 앞의 '배'는 몸이고 뒤의 '배'는 과일입니다. 사람은 고민도 안 하고 읽습니다. 그런데 AI는 이걸 어떻게 구별할까요?단어를 숫자 목록(벡터)으로 바꾸는 임베딩만으로는 안 됩니다. 임베딩에서 '배'는 점 하나입니다. 과일 배, 타는 배, 몸의 배가 모두 같은 자리에 있습니다. 뜻을 가르려면 문장의 다른 단어를 봐야 합니다. 그 "다른 단어를 얼마나 볼지"를 정하는 계산이 어텐션(attention)이고, 어텐션을 여러 겹 쌓은 것이 ChatGPT 같은 대형 언어 모델의 뼈대인 트랜스포머입니다.이 글에서는 수식을 최소로, 장난감 모델 하나로 어텐션을 처음부터 끝까지 손으로 계산해 봅니다. 고등학교 수학이면 충분합니다.같은 '배'인데, 문장 속에서 누구를 보느냐에 따라 전혀 다른 곳으로 갑니다. 지금부터 이 움직임을 하나씩 뜯어 봅니다.1. 어텐션이 하는 일: 누구를 얼마나 참고할까위 그림의 위쪽 띠는 문장의 단어들입니다. 노란 칸 '배를'에서 다른 단어로 가는 곡선은 굵을수록 많이 참고한다는 뜻이고, 곡선 위 숫자가 그 비율(가중치)입니다. '배를'은 '깎아'를 0.57, '먹었다'를 0.38만큼 봅니다. 가중치는 모두 더하면 1입니다.아래쪽은 손으로 만든 2차원 "의미 지도"입니다. 왼쪽 위가 과일 무리, 오른쪽 위가 바다 무리, 아래가 몸 무리입니다. 문맥 없는 '배'는 세 무리의 한가운데에 있습니다. 어텐션을 거친 '배를'의 새 자리(노란 점)는 참고한 단어들의 자리를 가중치만큼 섞은 곳, 즉 가중 평균입니다. 그래서 과일 무리로 옮겨 갑니다.같은 문장의 첫 '배가'를 고르면 어떨까요?이번에는 '고파서'를 0.87만큼 보고 몸 무리로 갑니다. 출발점은 둘 다 같은 한가운데였습니다. 달라진 것은 누구를 참고했느냐뿐입니다.2. 비율은 어디서 나올까: 질문, 열쇠, 값그럼 0.57이라는 숫자는 어디서 왔을까요? 어텐션은 단어마다 숫자 목록 세 개를 둡니다. 도서관에 비유하면 이렇습니다.질문 Query (Q): 내가 들고 간 질문 카드. "나는 이런 정보를 찾는다"열쇠 Key (K): 책등의 분류 라벨. "나는 이런 정보를 갖고 있다"값 Value (V): 책의 내용. 뽑혔을 때 건네줄 정보질문과 라벨이 잘 맞는 책일수록 많이 꺼내 읽고, 꺼낸 책의 내용을 그 비율만큼 섞습니다.장난감 모델에서 Q와 K는 칸이 세 개입니다. 첫째 칸은 "나를 설명하는 서술어", 둘째 칸은 "목적어에 일어난 동작", 셋째 칸은 "명사"라고 정해 두었습니다.배를: 질문 Q = (0, 2, 0), 열쇠 K = (0, 0, 1.5)배가: 질문 Q = (2, 0, 0), 열쇠 K = (0, 0, 1.5)깎아: 질문 Q = (0, 0, 1.5), 열쇠 K = (0.3, 1.8, 0)먹었다: 질문 Q = (0, 0, 1.5), 열쇠 K = (0.3, 1.6, 0)고파서: 질문 Q = (0, 0, 1.5), 열쇠 K = (1.8, 0, 0)'배를'의 질문은 "나에게 일어난 동작을 찾는다", '배가'의 질문은 "나를 설명하는 서술어를 찾는다"입니다. 조사 하나 차이로 찾는 것이 다릅니다.가중치는 세 걸음으로 계산합니다.① 점수: Q와 K를 칸끼리 곱해서 더한다(내적). '배를'과 '깎아'는 $0 \times 0.3 + 2 \times 1.8 + 0 \times 0 = 3.6$입니다. '먹었다'와는 $2 \times 1.6 = 3.2$, 나머지 셋('배가', '고파서', 자기 자신)과는 0입니다.② 점수를 $e^{\text{점수}}$로 바꾼다. 모두 양수가 되고, 앞선 점수가 크게 앞서게 됩니다. $e^{3.6} \approx 36.6$, $e^{3.2} \approx 24.5$, $e^0 = 1$입니다.③ 합으로 나눈다. 합은 $36.6 + 24.5 + 1 + 1 + 1 = 64.1$이므로 가중치는 이렇습니다.깎아: $36.6 \div 64.1 \approx$ 0.571먹었다: $24.5 \div 64.1 \approx$ 0.383배가, 고파서, 배를(자기 자신): 각각 $1 \div 64.1 \approx 0.016$②와 ③을 합친 것이 소프트맥스(softmax)입니다. 언어 모델이 다음 단어의 점수를 확률로 바꿀 때도 같은 계산을 씁니다.$\text{가중치}_j = \dfrac{e^{\,Q \cdot K_j}}{\sum_k e^{\,Q \cdot K_k}}$마지막으로 새 의미 = Σ(가중치 × 그 단어의 값 V)입니다. V를 지도 위의 자리로 두면, 앞의 그림에서 노란 점이 옮겨 간 자리가 바로 이 합입니다.장난감에서는 Q, K, V를 제가 손으로 정했습니다. 실제 모델에서는 아무도 정해 주지 않습니다. 단어 벡터에 숫자 표(행렬) 세 개를 곱해 Q, K, V를 만들고, 그 표의 숫자를 "다음 단어를 잘 맞히는 쪽으로" 경사하강법이 조금씩 고칩니다. 그래서 실제 모델의 칸들은 '서술어', '동작'처럼 사람이 이름 붙이기 쉬운 뜻을 갖지 않는 경우가 많습니다.3. 머리 여럿, 층 여럿: 이것이 트랜스포머어텐션 하나는 한 가지 관점만 봅니다. 위 그림은 두 번째 어텐션(머리, head)을 켠 화면입니다. "항구에 배가 들어왔다"에서 머리 1은 서술어 '들어왔다'를, 머리 2는 장소 '항구에'를 봅니다. 두 결과를 합친 점이 바다 무리 안쪽으로 들어갑니다. 한 머리가 놓친 것을 다른 머리가 잡습니다.이런 어텐션 단계를 여러 층으로 쌓으면, 첫 층에서 과일 쪽으로 옮겨 간 '배'를 다음 층에서 다른 단어들이 다시 참고합니다. 층이 깊어질수록 단어 하나의 벡터에 문장 전체의 정보가 녹아듭니다. 이 구조를 처음 제안한 것이 2017년 논문 «Attention Is All You Need»입니다. 그 논문의 기본 모델은 층마다 머리 8개, 층은 읽는 쪽과 쓰는 쪽에 6개씩이었습니다.실제 모델과 장난감의 차이 두 가지만 덧붙입니다.순서 정보: 위 계산에는 단어 순서가 없습니다. 실제 트랜스포머는 단어 벡터에 위치 정보를 더해 줍니다.점수 나누기: 칸이 수백 개면 점수가 너무 커져 가중치가 한 단어에 몰립니다. 그래서 실제로는 Q·K를 $\sqrt{\text{칸 수}}$로 나눈 뒤 소프트맥스를 합니다.4. 그래서 AI는 앞의 말을 "기억"할까챗봇이 앞의 대화를 기억하는 것처럼 보이는 것은, 대개 앞의 대화를 통째로 다시 입력에 넣어 주기 때문입니다. 모델은 그 전체를 어텐션으로 매번 다시 훑습니다. 한 번에 받을 수 있는 길이가 문맥 창(context window)이고, 창 밖으로 밀려난 내용은 보지 못합니다. 모든 단어 쌍의 점수를 계산하니, 글이 두 배로 길어지면 계산할 쌍은 약 네 배가 됩니다.한 문제만 풀어 보세요어떤 단어가 두 단어만 참고하고, 점수가 각각 3과 1입니다. 가중치는 얼마일까요? ($e^3 \approx 20.1$, $e^1 \approx 2.72$) 그리고 두 점수에 모두 10을 더하면 가중치는 어떻게 될까요?답: 0.88과 0.12. 점수 차는 2인데 가중치는 7배 넘게 벌어집니다. 10을 더해도 가중치는 그대로입니다. 소프트맥스는 점수의 차이만 봅니다.직접 움직여 보기이 글의 그림은 브라우저에서 직접 만지는 실습대입니다. 단어 칸을 눌러 곡선이 바뀌는 것을 보고, '머리 둘'을 켜고, 다른 문장을 골라 볼 수 있습니다. 회원가입 없이 무료입니다.이 교시 전체 보기 (실습대, 연습 문제 풀이 포함)강의 전체 「과학관 특별전, AI는 어떻게 생각하나」: 머신러닝, 경사하강법, 신경망, 합성곱, 단어 벡터, 언어 모델, 어텐션, AI가 틀리는 방식까지 8교시코딩 없이 그림과 손계산으로 AI의 원리를 따라가는 강의입니다. 같은 사이트에 확률·통계, 미분·적분, 화성학 강의도 있습니다.

자연어 처리・트랜스포머・어텐션・LLM・인공지능・딥러닝

AI/ML 커리어 준비하기 🔥

AI/ML 분야를 공부하다 보면 해야 할 것이 정말 많아 보입니다.Machine Learning, Deep Learning부터 시작해서 LLM, VLM, 생성 모델, Agent까지. 새로운 기술과 논문은 계속 등장하고, 채용공고를 보면 요구하는 역량도 한두 가지가 아닙니다.그러다 보니 자연스럽게 이런 고민을 하게 됩니다.“그래서 뭘 공부해야 하지?”하지만 AI/ML 커리어를 길게 바라본다면, 특정 기술 하나를 공부하는 것보다 먼저 생각해봐야 할 것들이 있습니다. 1. 결국 기초와 경험이 중요합니다AI/ML을 공부할 때 최신 모델과 기술에 눈이 가는 것은 당연합니다. 하지만 새로운 기술을 빠르게 이해하고 활용하기 위해서는 결국 기본기가 필요합니다.Linear Algebra, Probability & Statistics 같은 수학적 기초부터 Machine Learning, Deep Learning의 기본 개념, Optimization, Loss Function, Evaluation 등에 대한 이해가 대표적입니다.다만 기본기를 안다고 해서 바로 경쟁력이 생기는 것은 아닙니다.중요한 것은 배운 내용을 실제 문제에 적용해본 경험입니다. 모델을 직접 구현하고 학습해보는 것, 데이터의 문제를 찾아보는 것, 성능이 나오지 않는 이유를 분석하는 것, 여러 가설을 세우고 실험을 통해 검증하는 것.이런 과정을 반복하면서 지식은 비로소 문제 해결 능력으로 바뀝니다.그래서 AI/ML 커리어에서는 ‘무엇을 공부했는가’와 함께 ‘무엇을 해봤는가’가 중요합니다. 2. 대학원 역시 목적이 아니라 수단입니다AI/ML 커리어를 고민하다 보면 대학원 진학을 한 번쯤 생각하게 됩니다.특히 Research Scientist/Engineer 를 목표로 한다면 석·박사 과정에서 얻을 수 있는 연구 경험이 중요한 자산이 될 수 있습니다. 하지만 모든 AI/ML 직무에 대학원이 반드시 필요한 것은 아닙니다.중요한 것은 내가 어떤 커리어를 원하는지 먼저 생각하는 것입니다.새로운 방법론이나 모델 자체를 연구하고 싶은지, 연구 결과를 실제 문제에 적용하는 Applied Research를 하고 싶은지, 혹은 모델의 Training, Evaluation, Optimization, Serving까지 다루는 Research Engineering이나 ML Engineering을 하고 싶은지에 따라 필요한 경험은 달라집니다.대학원은 그중 하나의 방법입니다.연구 역량이 필요한 커리어라면 대학원이 좋은 선택이 될 수 있고, Engineering 역량이 더 중요한 커리어라면 실제 프로젝트와 개발 경험이 더 중요할 수도 있습니다.그래서 “AI를 하려면 대학원을 가야 할까?”보다 “내가 원하는 일을 하기 위해 어떤 경험이 필요한가?”를 먼저 질문해보는 것이 좋습니다. 3. 기본기를 먼저 쌓기AI/ML 분야에서는 새로운 기술이 끊임없이 등장합니다. LLM, VLM, Image/Video Generation, RAG, Agent처럼 새로운 분야가 주목받을 때마다 무엇을 먼저 공부해야 할지 고민하게 되죠.최신 기술을 공부하고 경험하는 것은 분명 중요합니다. 하지만 그보다 먼저 갖춰야 하는 것은 기본기입니다. Machine Learning과 Deep Learning의 기본 원리, Model Architecture, Loss Function, Optimization, Training, Evaluation 등에 대한 이해가 충분하지 않은 상태에서 특정 모델이나 프레임워크의 사용법만 익히면 기술이 바뀌었을 때 그 지식도 함께 쓸모를 잃기 쉽습니다.예를 들어 Transformer를 직접 공부하고 Attention의 원리를 이해한 사람과 특정 LLM API의 사용법만 익힌 사람은 새로운 모델과 기술을 접했을 때 문제를 이해하는 깊이에서 차이가 날 수밖에 없습니다.Engineering도 마찬가지입니다. Distributed Training이나 Inference Optimization을 단순히 라이브러리의 옵션과 사용법으로만 알고 있는 것과, GPU Memory, Parallelism, Communication, Throughput과 Latency 같은 기본 원리를 이해하고 사용하는 것은 다릅니다.그렇다고 기본기만 계속 공부해야 한다는 뜻은 아닙니다. 기본기를 충분히 쌓았다면 반드시 응용 기술을 공부하고 직접 경험해봐야 합니다. 기본기가 새로운 기술을 빠르게 이해할 수 있는 토대라면, 응용 경험은 그 지식을 실제 문제를 해결하는 능력으로 바꿔줍니다.결국 둘 다 중요합니다. 다만 기초 없이 쌓은 응용 기술에 대한 지식은 쉽게 무너집니다.유행하는 기술은 계속 바뀌지만 그 기술을 구성하는 핵심 원리는 생각보다 오래 남습니다. 기본기를 탄탄하게 만들고, 그 위에 새로운 기술과 경험을 계속 쌓아가는 것이 AI/ML 커리어를 오래 가져갈 수 있는 방법입니다. 4. 쉬운 것은 경쟁력이 되기 어렵습니다요즘은 AI를 공부하고 활용하는 것 자체가 과거보다 훨씬 쉬워졌습니다.좋은 강의와 오픈소스가 많아졌고, Hugging Face에서 모델을 가져와 몇 줄의 코드로 실행할 수도 있습니다. 생성형 AI의 도움을 받으면 구현의 진입장벽도 훨씬 낮아졌습니다. 좋은 변화입니다. 하지만 커리어의 관점에서는 한 가지를 생각해볼 필요가 있습니다.내가 쉽게 할 수 있는 일은, 다른 사람도 쉽게 할 수 있을 가능성이 높습니다.Pre-trained Model을 가져와 실행해보는 것, 튜토리얼을 따라 Fine-tuning 해보는 것, API를 연결해 서비스를 만들어보는 것만으로는 점점 차별화하기 어려워질 수 있습니다.그래서 그다음 단계가 중요합니다. 남들이 쉽게 해결하지 못하는 문제를 정의하고 해결해보는 것. 논문의 방법을 직접 구현하고 개선해보는 것. 데이터와 모델의 문제를 분석해 성능을 끌어올리는 것. 대규모 학습 과정에서 발생하는 문제를 해결하거나 제한된 GPU 환경에서 Training과 Inference를 최적화하는 것.Research든 Engineering이든 결국 경쟁력은 ‘남들이 쉽게 하지 못하는 일을 할 수 있는 능력’에서 만들어집니다.처음부터 어려운 문제를 해결할 필요는 없습니다. 다만 프로젝트와 공부를 반복하면서 조금씩 더 어려운 문제를 선택해보세요. 그리고 그 문제를 해결하기 위해 깊게 파고들어 본 경험을 만들어보세요.AI 기술이 발전할수록 많은 것들이 더 쉬워질 겁니다. 그럴수록 ‘무엇을 사용할 줄 아는가’보다 ‘어떤 어려운 문제를 해결할 수 있는가’가 더 중요한 경쟁력이 될 수 있습니다.

딥러닝 · 머신러닝・AI・ML・Computervision・LLM・MLE・Research・Engineering・SW

유클리드소프트

[고용노동부 K-DT] 「AI 캠퍼스」 교육생 모집(~7.1/장학금 지원/교육비 무료)

안녕하세요 🍀고용노동부와 함께하는 2026년 K-디지털트레이닝 AI캠퍼스 사업실무형 AI전문가 과정을 준비했습니다!🌟머신런닝 전문가 과정(MLOps) / AI챗봇 전문가 과정(LLMOps)🌟실제 대기업에 도입·운영 중인 자사 솔루션 활용 프로젝트 진행🌟현직 시니어 개발자 1:1 멘토링🌟취업 AI 포트폴리오 완성 (이론 60%+프로젝트 40%)🌟기술 세미나 및 모의 면접 등 취업 연계프로그램 지원 📌 모집대상▶ 바이브코딩을 통한 개발자, 프로젝트 기획자로 준비되길 원하는 자▶ 실무형 AI 엔지니어의 꿈을 가지고 있는 청년 및 취업준비생 25명▶ 국민내일배움카드 신규 발급자 및 사용 가능자(*중요) 📌 교육기간▶ 머신런닝 전문가 과정 : 2026년 7월 8일(수) ~ 2027년 3월 3일(수) (총 8개월)▶ AI 챗봇 전문가 과정 : 2026년 7월 22일(수) ~ 2027년 1월 14일(목) (총 6개월) 📌 교육시간▶ 월-금 9:00-18:00 (점심시간 12:00-13:00) 📌 교육장소▶ 제1캠퍼스(머신런닝) : 대전 동구 계족로 151 (대전지식산업센터 602호)▶ 제2캠퍼스(AI 챗봇) : 대전광역시 서구 계룡로 314 대전일보사 (대전일보사 4층) 🎁 참여혜택▶💰 전과정 교육비 무상(자비부담금 없음)▶💻 노트북, GPU, 클로드 Max 지원▶💵 매달 지원금 60만원(출석률고려) + 자사 장학금 30만원(월세 지원)▶📚 관련 자격증 취득 시 자격증 응시료 환급 🔗 신청링크(~6/30 까지)▶ 링크 : https://abcbootcamp.kr/abc_education/abc_education_detail/EDUA_000000103/ 📞 문의▶ 카카오채널: 유클리드소프트 혁신역량교육팀 http://pf.kakao.com/_pDpyb

AI 개발 활용・고용노동부・K-디지털트레이니・AI캠퍼스・전액지원・AI・머신러닝・LLM・클로드・취업지원・대전

AI 에이전트와 웹의 연결, Chrome의 새로운 표준 'WebMCP'를 아시나요?

안녕하세요! 최근 AI 에이전트가 브라우저에서 직접 작업을 수행하는 능력이 주목받고 있는데요.기존에는 AI가 화면을 스크래핑하거나 DOM 구조를 추측하는 방식이라 UI가 조금만 바뀌어도 동작이 깨지는 한계가 있었습니다. 이를 해결하기 위해 구글 크롬 팀이 제안한 새로운 프로토콜, WebMCP(Web Model Context Protocol)를 소개하고자 합니다. 핵심 요약: "추측에서 계약으로"WebMCP의 핵심은 웹사이트가 AI에게 "나 이런 도구(Tool)가 있고, 이런 데이터가 필요해"라고 명시적인 '사용 설명서'를 건네주는 것입니다.정확도 상승: JSON Schema를 통해 입력값 규격을 맞추므로 환각(Hallucination)이 줄어듭니다.유지보수 용이: UI 레이아웃이 변경되어도 정의된 도구 이름만 같다면 AI는 문제없이 작동합니다.클라이언트 기반: 서버가 아닌 브라우저 내부에서 사용자의 컨텍스트를 활용해 실시간으로 동작합니다. 🖼 기존 방식 vs WebMCP 방식 비교 💻 구현 예시 (선언적 방식)JavaScript 한 줄 없이 HTML 속성만으로도 AI용 도구를 만들 수 있다는 점이 놀랍습니다.<form toolname="search_flights" tooldescription="출발지, 목적지, 날짜를 입력받아 항공권을 검색합니다." > <input type="text" name="departure" label="출발지" required> <input type="text" name="arrival" label="목적지" required> <input type="date" name="travel_date" label="여행 날짜"> <button type="submit">검색</button> </form>이제는 SEO(검색 최적화)를 넘어, AI 에이전트가 우리 서비스를 얼마나 잘 활용하게 만들 것인가를 고민하는 AIO(AI Optimization)가 웹 개발의 새로운 표준이 될 것으로 보입니다.WebMCP의 구체적인 작동 원리와 JavaScript API 활용법 등 더 자세한 내용이 궁금하신 분들은 아래 제 블로그 포스팅에 정리해 두었습니다. 👉[블로그 링크: WebMCP - 웹과 AI 에이전트를 잇는 새로운 표준] 앞으로의 웹 생태계가 어떻게 변할지, 여러분의 의견도 궁금합니다

AI 개발 활용・WebMCP・AI에이전트・AIO・웹표준・구글크롬・프론트엔드・LLM・자동화・신기술・웹개발

채널톡 아이콘