


배가 고파서 배를 깎아 먹었다: AI는 두 '배'를 어떻게 구별할까
"배가 고파서 배를 깎아 먹었다."
이 문장에서 앞의 '배'는 몸이고 뒤의 '배'는 과일입니다. 사람은 고민도 안 하고 읽습니다. 그런데 AI는 이걸 어떻게 구별할까요?
단어를 숫자 목록(벡터)으로 바꾸는 임베딩만으로는 안 됩니다. 임베딩에서 '배'는 점 하나입니다. 과일 배, 타는 배, 몸의 배가 모두 같은 자리에 있습니다. 뜻을 가르려면 문장의 다른 단어를 봐야 합니다. 그 "다른 단어를 얼마나 볼지"를 정하는 계산이 어텐션(attention)이고, 어텐션을 여러 겹 쌓은 것이 ChatGPT 같은 대형 언어 모델의 뼈대인 트랜스포머입니다.
이 글에서는 수식을 최소로, 장난감 모델 하나로 어텐션을 처음부터 끝까지 손으로 계산해 봅니다. 고등학교 수학이면 충분합니다.
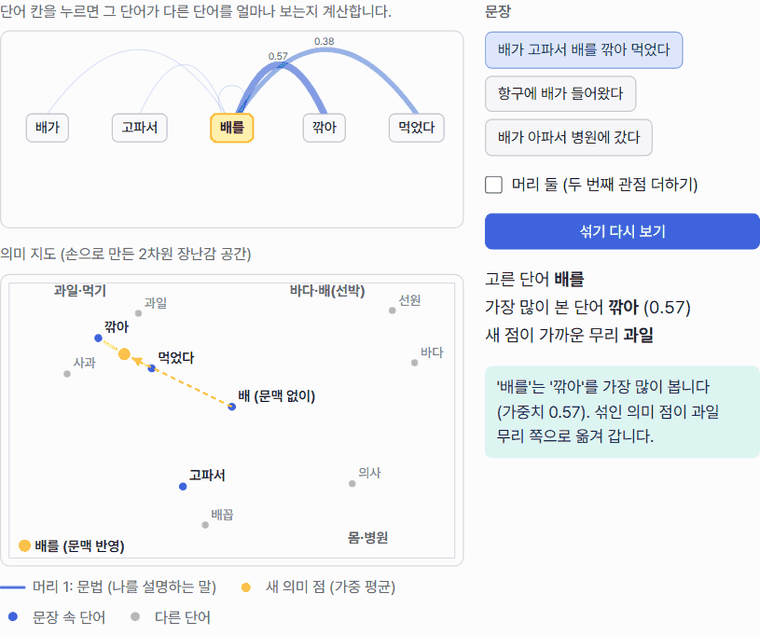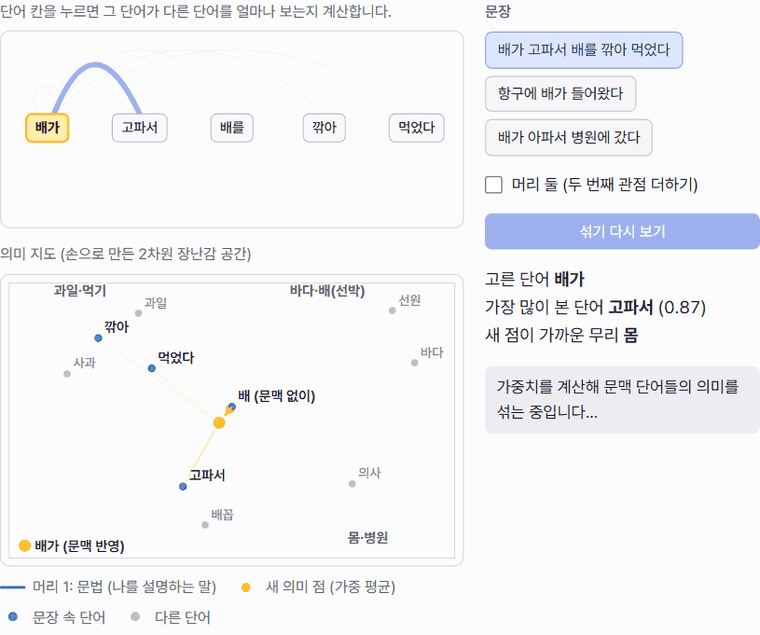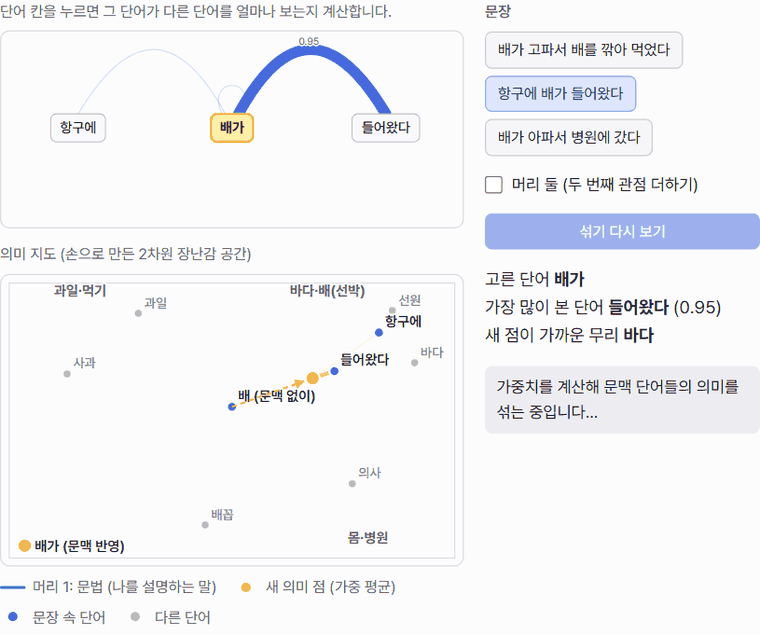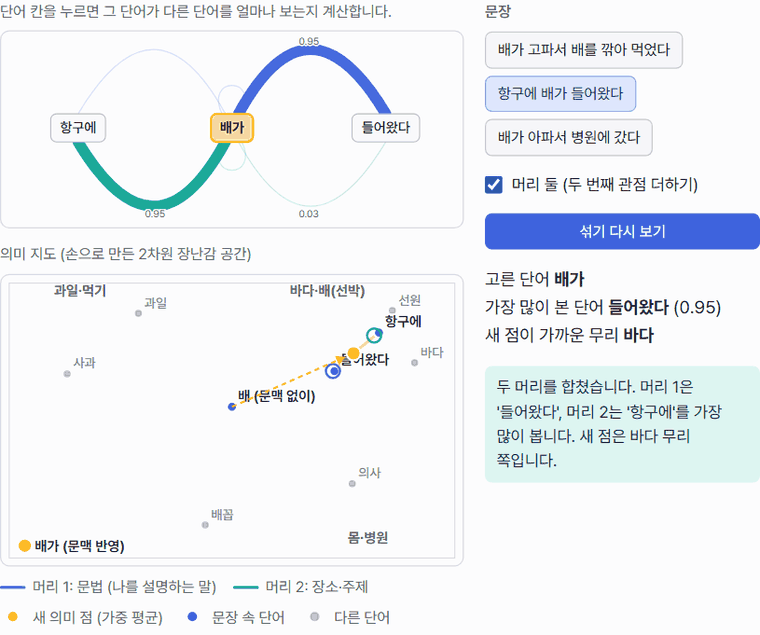
같은 '배'인데, 문장 속에서 누구를 보느냐에 따라 전혀 다른 곳으로 갑니다. 지금부터 이 움직임을 하나씩 뜯어 봅니다.
1. 어텐션이 하는 일: 누구를 얼마나 참고할까
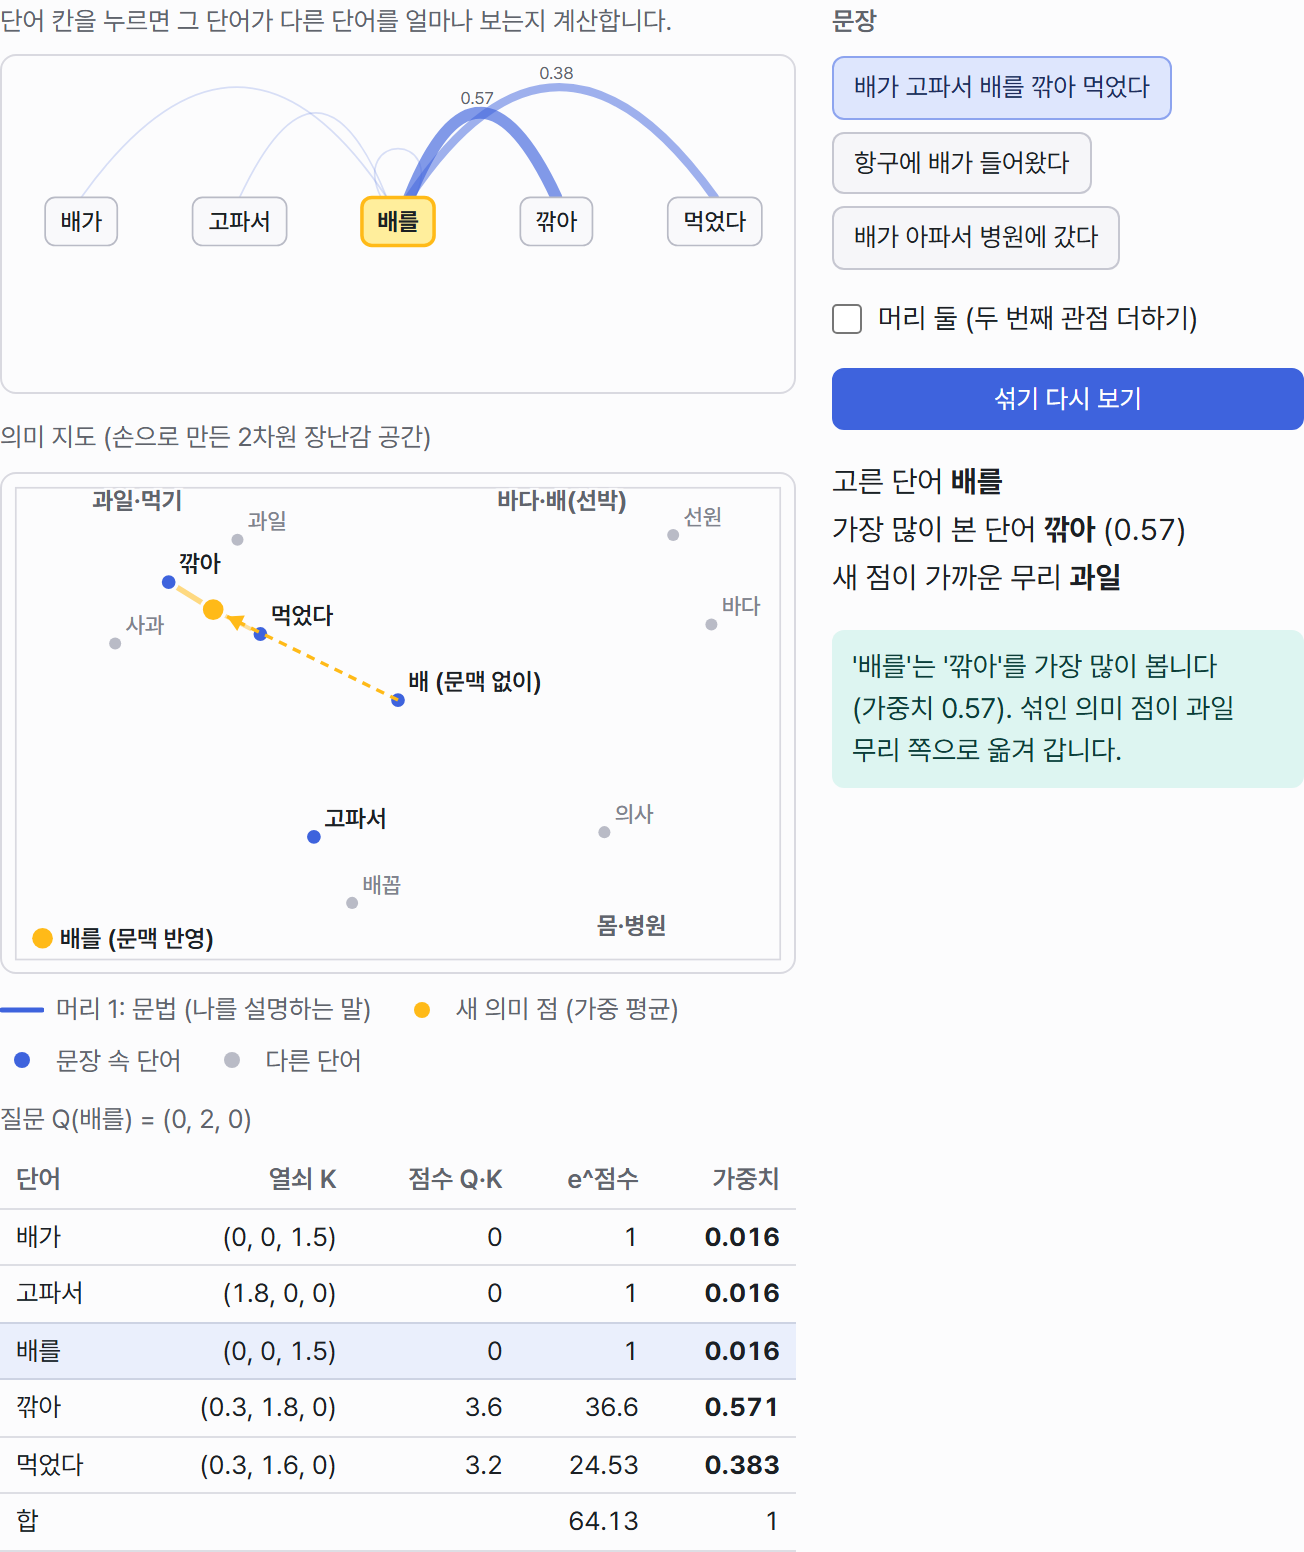
위 그림의 위쪽 띠는 문장의 단어들입니다. 노란 칸 '배를'에서 다른 단어로 가는 곡선은 굵을수록 많이 참고한다는 뜻이고, 곡선 위 숫자가 그 비율(가중치)입니다. '배를'은 '깎아'를 0.57, '먹었다'를 0.38만큼 봅니다. 가중치는 모두 더하면 1입니다.
아래쪽은 손으로 만든 2차원 "의미 지도"입니다. 왼쪽 위가 과일 무리, 오른쪽 위가 바다 무리, 아래가 몸 무리입니다. 문맥 없는 '배'는 세 무리의 한가운데에 있습니다. 어텐션을 거친 '배를'의 새 자리(노란 점)는 참고한 단어들의 자리를 가중치만큼 섞은 곳, 즉 가중 평균입니다. 그래서 과일 무리로 옮겨 갑니다.
같은 문장의 첫 '배가'를 고르면 어떨까요?
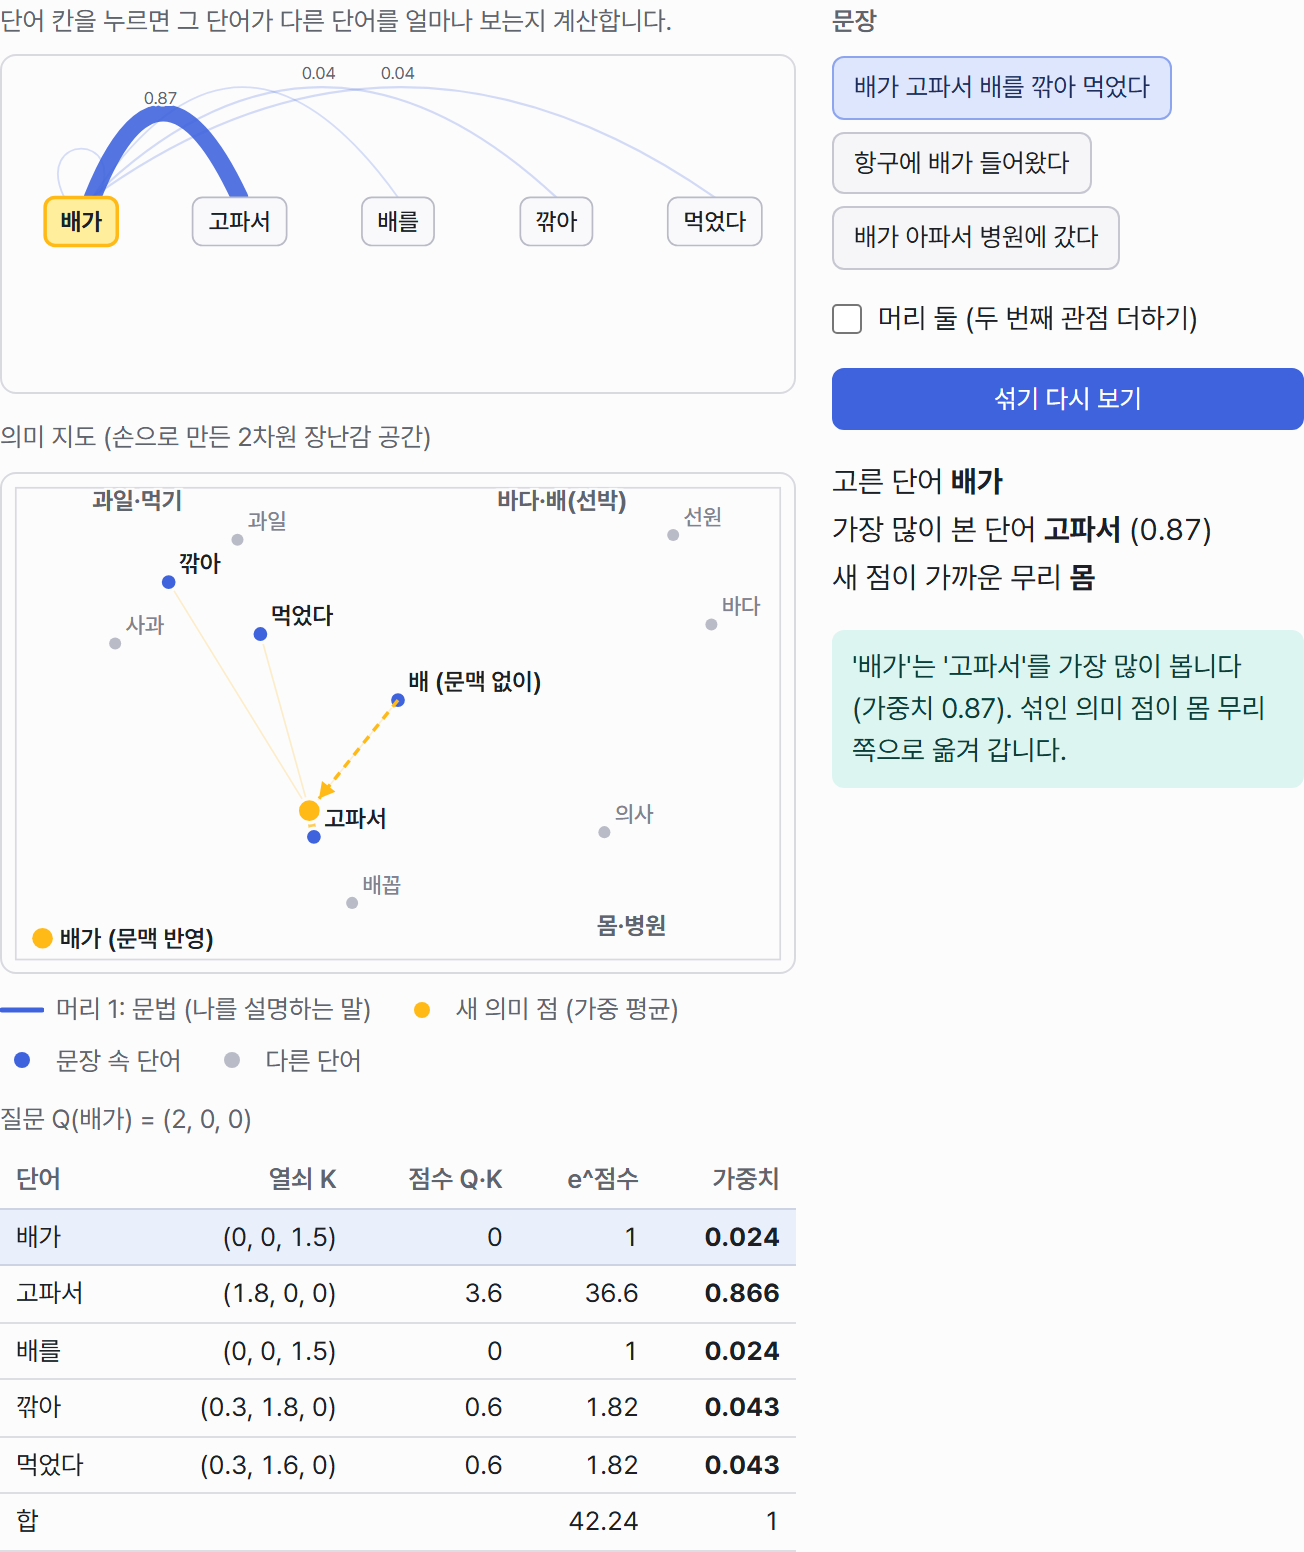
이번에는 '고파서'를 0.87만큼 보고 몸 무리로 갑니다. 출발점은 둘 다 같은 한가운데였습니다. 달라진 것은 누구를 참고했느냐뿐입니다.
2. 비율은 어디서 나올까: 질문, 열쇠, 값
그럼 0.57이라는 숫자는 어디서 왔을까요? 어텐션은 단어마다 숫자 목록 세 개를 둡니다. 도서관에 비유하면 이렇습니다.
질문 Query (Q): 내가 들고 간 질문 카드. "나는 이런 정보를 찾는다"
열쇠 Key (K): 책등의 분류 라벨. "나는 이런 정보를 갖고 있다"
값 Value (V): 책의 내용. 뽑혔을 때 건네줄 정보
질문과 라벨이 잘 맞는 책일수록 많이 꺼내 읽고, 꺼낸 책의 내용을 그 비율만큼 섞습니다.
장난감 모델에서 Q와 K는 칸이 세 개입니다. 첫째 칸은 "나를 설명하는 서술어", 둘째 칸은 "목적어에 일어난 동작", 셋째 칸은 "명사"라고 정해 두었습니다.
배를: 질문 Q = (0, 2, 0), 열쇠 K = (0, 0, 1.5)
배가: 질문 Q = (2, 0, 0), 열쇠 K = (0, 0, 1.5)
깎아: 질문 Q = (0, 0, 1.5), 열쇠 K = (0.3, 1.8, 0)
먹었다: 질문 Q = (0, 0, 1.5), 열쇠 K = (0.3, 1.6, 0)
고파서: 질문 Q = (0, 0, 1.5), 열쇠 K = (1.8, 0, 0)
'배를'의 질문은 "나에게 일어난 동작을 찾는다", '배가'의 질문은 "나를 설명하는 서술어를 찾는다"입니다. 조사 하나 차이로 찾는 것이 다릅니다.
가중치는 세 걸음으로 계산합니다.
① 점수: Q와 K를 칸끼리 곱해서 더한다(내적). '배를'과 '깎아'는 $0 \times 0.3 + 2 \times 1.8 + 0 \times 0 = 3.6$입니다. '먹었다'와는 $2 \times 1.6 = 3.2$, 나머지 셋('배가', '고파서', 자기 자신)과는 0입니다.
② 점수를 $e^{\text{점수}}$로 바꾼다. 모두 양수가 되고, 앞선 점수가 크게 앞서게 됩니다. $e^{3.6} \approx 36.6$, $e^{3.2} \approx 24.5$, $e^0 = 1$입니다.
③ 합으로 나눈다. 합은 $36.6 + 24.5 + 1 + 1 + 1 = 64.1$이므로 가중치는 이렇습니다.
깎아: $36.6 \div 64.1 \approx$ 0.571
먹었다: $24.5 \div 64.1 \approx$ 0.383
배가, 고파서, 배를(자기 자신): 각각 $1 \div 64.1 \approx 0.016$
②와 ③을 합친 것이 소프트맥스(softmax)입니다. 언어 모델이 다음 단어의 점수를 확률로 바꿀 때도 같은 계산을 씁니다.
$\text{가중치}_j = \dfrac{e^{\,Q \cdot K_j}}{\sum_k e^{\,Q \cdot K_k}}$
마지막으로 새 의미 = Σ(가중치 × 그 단어의 값 V)입니다. V를 지도 위의 자리로 두면, 앞의 그림에서 노란 점이 옮겨 간 자리가 바로 이 합입니다.
장난감에서는 Q, K, V를 제가 손으로 정했습니다. 실제 모델에서는 아무도 정해 주지 않습니다. 단어 벡터에 숫자 표(행렬) 세 개를 곱해 Q, K, V를 만들고, 그 표의 숫자를 "다음 단어를 잘 맞히는 쪽으로" 경사하강법이 조금씩 고칩니다. 그래서 실제 모델의 칸들은 '서술어', '동작'처럼 사람이 이름 붙이기 쉬운 뜻을 갖지 않는 경우가 많습니다.
3. 머리 여럿, 층 여럿: 이것이 트랜스포머
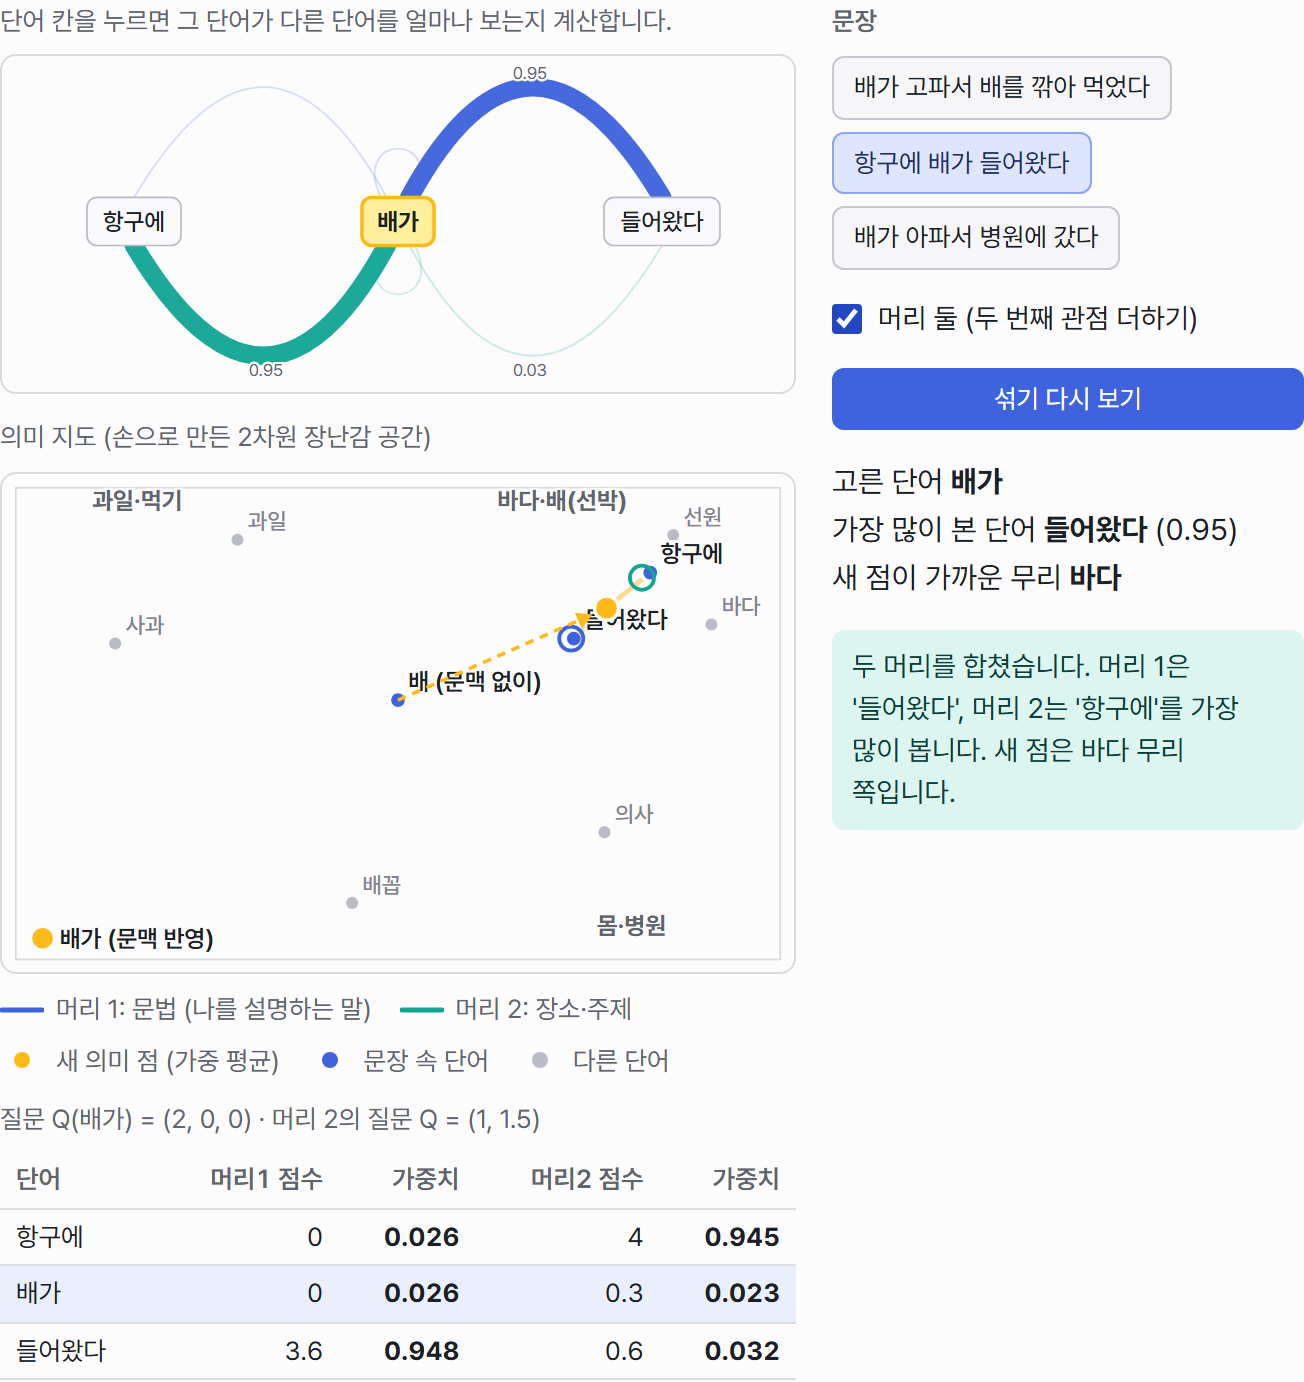
어텐션 하나는 한 가지 관점만 봅니다. 위 그림은 두 번째 어텐션(머리, head)을 켠 화면입니다. "항구에 배가 들어왔다"에서 머리 1은 서술어 '들어왔다'를, 머리 2는 장소 '항구에'를 봅니다. 두 결과를 합친 점이 바다 무리 안쪽으로 들어갑니다. 한 머리가 놓친 것을 다른 머리가 잡습니다.
이런 어텐션 단계를 여러 층으로 쌓으면, 첫 층에서 과일 쪽으로 옮겨 간 '배'를 다음 층에서 다른 단어들이 다시 참고합니다. 층이 깊어질수록 단어 하나의 벡터에 문장 전체의 정보가 녹아듭니다. 이 구조를 처음 제안한 것이 2017년 논문 «Attention Is All You Need»입니다. 그 논문의 기본 모델은 층마다 머리 8개, 층은 읽는 쪽과 쓰는 쪽에 6개씩이었습니다.
실제 모델과 장난감의 차이 두 가지만 덧붙입니다.
순서 정보: 위 계산에는 단어 순서가 없습니다. 실제 트랜스포머는 단어 벡터에 위치 정보를 더해 줍니다.
점수 나누기: 칸이 수백 개면 점수가 너무 커져 가중치가 한 단어에 몰립니다. 그래서 실제로는 Q·K를 $\sqrt{\text{칸 수}}$로 나눈 뒤 소프트맥스를 합니다.
4. 그래서 AI는 앞의 말을 "기억"할까
챗봇이 앞의 대화를 기억하는 것처럼 보이는 것은, 대개 앞의 대화를 통째로 다시 입력에 넣어 주기 때문입니다. 모델은 그 전체를 어텐션으로 매번 다시 훑습니다. 한 번에 받을 수 있는 길이가 문맥 창(context window)이고, 창 밖으로 밀려난 내용은 보지 못합니다. 모든 단어 쌍의 점수를 계산하니, 글이 두 배로 길어지면 계산할 쌍은 약 네 배가 됩니다.
한 문제만 풀어 보세요
어떤 단어가 두 단어만 참고하고, 점수가 각각 3과 1입니다. 가중치는 얼마일까요? ($e^3 \approx 20.1$, $e^1 \approx 2.72$) 그리고 두 점수에 모두 10을 더하면 가중치는 어떻게 될까요?
답: 0.88과 0.12. 점수 차는 2인데 가중치는 7배 넘게 벌어집니다. 10을 더해도 가중치는 그대로입니다. 소프트맥스는 점수의 차이만 봅니다.
직접 움직여 보기
이 글의 그림은 브라우저에서 직접 만지는 실습대입니다. 단어 칸을 눌러 곡선이 바뀌는 것을 보고, '머리 둘'을 켜고, 다른 문장을 골라 볼 수 있습니다. 회원가입 없이 무료입니다.
강의 전체 「과학관 특별전, AI는 어떻게 생각하나」: 머신러닝, 경사하강법, 신경망, 합성곱, 단어 벡터, 언어 모델, 어텐션, AI가 틀리는 방식까지 8교시
코딩 없이 그림과 손계산으로 AI의 원리를 따라가는 강의입니다. 같은 사이트에 확률·통계, 미분·적분, 화성학 강의도 있습니다.
답변 0