


세션 종료
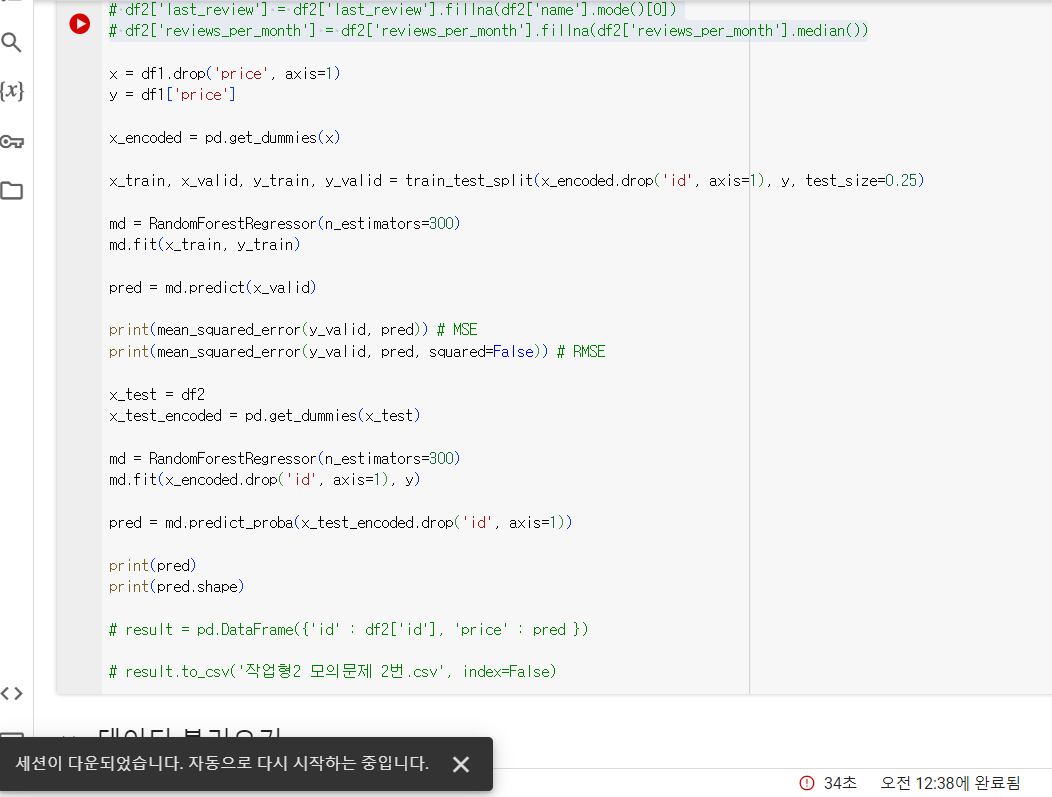
코드 작성하고 실행 시켰는데 세션이 다운됐어요. 왜 이런걸까요??
코랩 자체에서 무료 제공하는 리소스를 모두 소진한 줄 알았는데, 다른 문제들에 대해서는 아직 잘 돌아갑니다.
제가 작성한 코드도 같이 올려둘게요!
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
df1 = pd.read_csv('/content/drive/MyDrive/bigdata(빅분기 놀이터)/작업형2 모의문제/모의문제 2번/train.csv')
# print(df1.head())
# print(df1.info())
# print(df1.shape)
df2 = pd.read_csv('/content/drive/MyDrive/bigdata(빅분기 놀이터)/작업형2 모의문제/모의문제 2번/test.csv')
# print(df2.head())
# print(df2.info())
# print(df2.shape)
df1['name'] = df1['name'].fillna(df1['name'].mode()[0])
df1['host_name'] = df1['host_name'].fillna(df1['name'].mode()[0])
df1['last_review'] = df1['last_review'].fillna(df1['name'].mode()[0])
df1['reviews_per_month'] = df1['reviews_per_month'].fillna(df1['reviews_per_month'].median())
df2['name'] = df2['name'].fillna(df2['name'].mode()[0])
df2['host_name'] = df2['host_name'].fillna(df2['name'].mode()[0])
df2['last_review'] = df2['last_review'].fillna(df2['name'].mode()[0])
df2['reviews_per_month'] = df2['reviews_per_month'].fillna(df2['reviews_per_month'].median())
x = df1.drop('price', axis=1)
y = df1['price']
x_encoded = pd.get_dummies(x)
x_train, x_valid, y_train, y_valid = train_test_split(x_encoded.drop('id', axis=1), y, test_size=0.25)
md = RandomForestRegressor(n_estimators=300)
md.fit(x_train, y_train)
pred = md.predict(x_valid)
print(mean_squared_error(y_valid, pred)) # MSE
print(mean_squared_error(y_valid, pred, squared=False)) # RMSE
x_test = df2
x_test_encoded = pd.get_dummies(x_test)
md = RandomForestRegressor(n_estimators=300)
md.fit(x_encoded.drop('id', axis=1), y)
pred = md.predict_proba(x_test_encoded.drop('id', axis=1))
print(pred)
print(pred.shape)
result = pd.DataFrame({'id' : df2['id'], 'price' : pred })
result.to_csv('작업형2 모의문제 2번.csv', index=False)
답변 1
작업형2 모의문제2_updated2026.10
0
8
2
수강기간 연장문의
0
17
1
작업형 2 질문
0
23
2
강의 연장 관련하여 문의드립니다.
0
25
1
섹션7 자료 다운로드
0
26
2
작업형 1 연습문제 Section12
0
27
2
수강기간 연장 문의
0
36
1
안녕하세요, 혹시 수강기간 연장이 가능할까요?
0
33
2
판다스 강의자료는 어디서 받을 수 있나요?
0
39
2
작업형2 모의고사3 자료 업데이트 요청
0
43
4
수강 연장가능여부 문의드립니다!
0
44
2
수강기간 연장 문의드립니다!
0
40
2
최빈값
0
43
2
수강 가이드라인
0
40
2
수강 연장 가능 여부 문의
0
58
2
강의 구매했는데 교재 필수일까요
0
48
2
수강기간 연장 가부 문의드립니다.
0
43
2
수강기간 연장이 가능한지 양해를 구하며 문의를 드립니다.
0
43
2
작업형2 모의문제2에서 drop이랑 인코딩
0
53
3
인코딩을 다 꼭 해봐야하는지
0
52
2
안녕하세요? 강사님 질문있습니다.(인코딩관련)
0
64
2
이진분류에서 양성 클래스가 0일 때 평가 방법
0
48
2
원핫인코딩 전 train과 test 병합여부
0
54
2
수강기간 연장
0
73
2