ビッグデータ パイプライン マスタ: 成功のためのツールとテクノロジー
jphil
皆さん、ビッグデータ処理の4段階である[データ収集▶データ保存▶データ分析▶表現]について、理論30%+実践70%のコードラボ方式でより楽しく体系的に学習します🧑🏻🏫

初級
Big Data, Elasticsearch, Apache Spark
高可用性(High Availability)が保証されたビッグデータシステムまたは分散処理システムクラスター(HDFS、Zookeeper、Spark、Zeppelin)を自ら構築してみる、コードラボ中心の授業です。
受講生 122名
難易度 初級
受講期間 無制限
学習した受講者のレビュー
5.0
귤껍데기
内容が充実していて、初めて始めるのに良い講義だと思います。このような講義を用意してくださってありがとうございます。
5.0
one831
まもなく卒業を控えた、データエンジニアを志望するコムボールと学生です。 雇用関連ポートフォリオを作成しながら、ビッグデータを処理するためのパイプラインとアーキテクチャをどのように構成し、どのようにaws環境を設定してできるだけ低コストで効率的に利用できるか悩みが多かったが、本講義を通じて膨大なインサイトとノウハウを手に入れます。 特に、ビッグデータを扱うさまざまなフレームワークに関する多くの知識も得られるようになり、今後どのように掘り下げられるのかインスピレーションを得たようで嬉しいです。 干ばつの終わりにダンビーに会いました。私のようにこちらの分野を志望される学生の方に受講おすすめです。
5.0
권영미
ありがとうございます!
ビッグデータクラスターの構築
分散ファイルまたは処理システム
高可用性
Hadoop
HDFS
Apache Spark
Apache Zeppelin
Apache Zookeeper
AWS (EC2, AMI, Security Group)
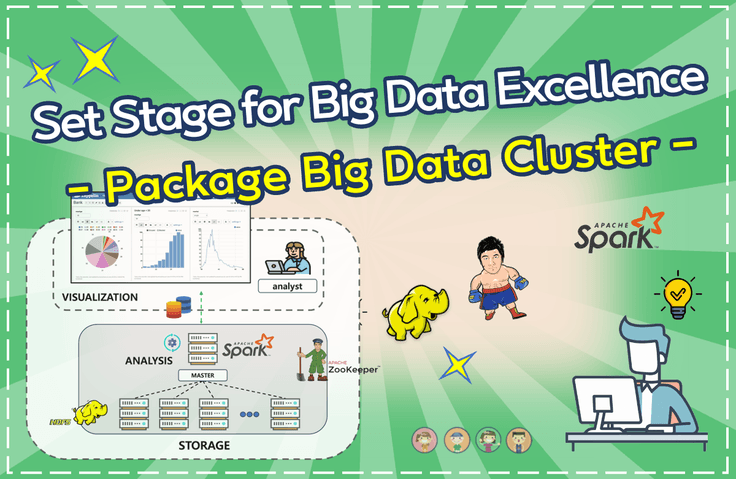
ビッグデータ分散クラスターをコードラボを通じて実際に構築してみる、
ビッグデータクラスター構築パッケージ👨🏻🎓
一学期が過ぎ、良い機会に恵まれ、今シーズンはビッグデータ分散クラスターを皆さんが直接構築してみる'ビッグデータクラスター構築パッケージ' 講義を行おうと思います 📚
皆様の声援に応え、前回の「ビッグデータパイプラインマスター」講座から得たインスピレーションをもとに、「多少チャレンジングではあるが、別の方向で有意義な講義があるのではないか?」と悩んだ末、一歩一歩丹精を込めて本講義を制作いたしました。
キーワード: Big Data Cluster, Distributed System, High Availability, Hadoop, HDFS, Apache Spark, Zookeeper, Zeppelin, AWS EC2 & AMI
約10年を超える歳月の間、急進的な技術発展によって多様なプラットフォームやサービスが雨後の筍のように生まれ、これを通じて生活から派生する無数のデータが活用・分析されることで、私たちは質の高い生活を享受しています。
下のfigure1.のように、国内の巨大企業だけでなく、世界の巨人企業はBig Data StorageおよびBig Data Processingの重要性を公然と強調しており、多くのエンジニアにこれに類する分析および構築のスキルセットを要求しています。
<F1. 世界中の数多くの企業がデータ処理に集中>
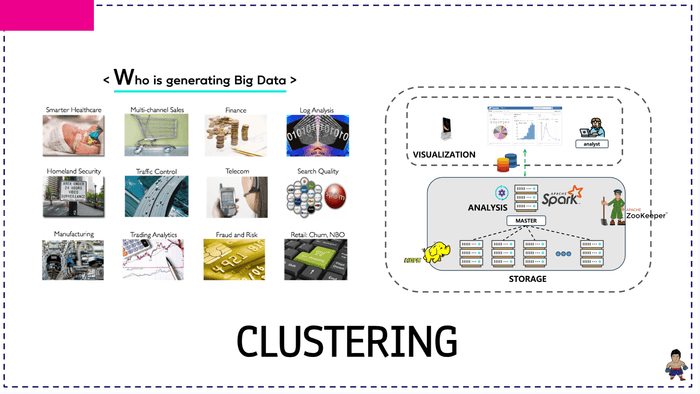
<F2. 数多くの分野でビッグデータクラスターを構築>
しかし、私たちが実際に該当する業界に参入するまでは、事前にビッグデータクラスターを直接構築したり扱ったりする経験を得ることは容易ではありません。そのため、いざ有意義な価値を得られる機会が訪れた際、これに対する経験不足で惜しい結果を迎えてしまうこともあります。
私自身も研究員時代に「DATA TOPTIER CONFERENCE」の論文を執筆した際、50台のビッグデータクラスターを自ら構築しなければならず、メンバーの模範とならなければならないというプレッシャーと課金に対する大きなストレスに耐えながら、15日間昼夜を問わずクラスターの構築のみに専念したことがありました。
もちろんその時の貴重な経験から多くを学び、前に進むための良い糧となりましたが、私は皆さんにこのように時間を多少非効率的に使ってほしくはありません。つまり、皆さんの貴重な約200時間をクラスターの構築だけに費やすのではなく、効率的にクラスター上での実験や顧客データの分析に専念していただくことを期待して、本講義を制作しました 📝
何よりも、皆さんがこの講義を通じてクラスター構築の経験を積んだ後、私のように実際の現場や大学院でビッグデータクラスターを構築する際に大きな助けとなることを願っています。本講義は無制限で公開しましたので、ぜひ参考にしてください💓
📝
Data Top-Tier Conference 論文を汗を流して書いた経験
👨🏻💼
現場で得た貴重なビッグデータシステムの構築および分析経験
🧑🏻🏫
長年大学で優れた弟子たちを養成してきた経験
このような貴重な経験をもとに、該当分野で皆さんが ⚔️ 強力な武器を作れるように
1. 高可用性が保証される分散ファイルシステム HDFS 上に(以下のデーモンの例を参照)
2. ビッグデータシステムの傑作、Apache Sparkおよびビッグデータ専用ノートブックZeppelin
クラスターパッケージを理論としっかりとしたコードラボを通じて、直接構築してみる予定です。

上記の高可用性ファイルシステムデーモンの構成が、少々難しく見えますか?本来、初めて目にするアーキテクチャやシステム構成図というものは、負担に感じて当然のものです。
約6年間にわたる素晴らしい弟子たちの貴重なフィードバックを振り返り、過去にInflearnで2つの講義をローンチした経験をもとに、受講生の皆さんの目線に合わせて一歩ずつ、できるだけ分かりやすく質の高いコンテンツで構成しましたので、安心してついてきてください。
 special thanks to my lovely students 👨🏻🎓

すぐにCODELABから始めるのではなく、高可用性クラスターを構築する際に必要な理論から学習します。そして、AWS環境やLinux環境に慣れていない受講生の方々のために、ガイド動画およびバックグラウンド知識を勉強してから、本格的に深層的なコードラボを進める予定です 😎


以下のような負担のない環境を準備していただければ、十分に授業についていくことができます。
OS: Ubuntu 20.04 LTS
Editor: Vim (お好みに合わせて)
マシン仕様
AWS EC2 / c5.large (2 Core 4GB) 4台または5台
詳細については Course Curriculum をご視聴ください 😊


受講対象
ビッグデータ処理システムのクラスター構築を直接経験したい受講生
データ分析およびシステムに関心があり、職務を希望する学生
高可用性クラスタの実習を直接体験したい開発者
ビッグデータ分析および構築分野で強みを作りたい就活生
前提知識
Python基礎コーディング
Linuxコマンドの基礎知識
データベースの基礎知識

476
受講生
45
受講レビュー
50
回答
4.9
講座評価
2
講座
最初の講義として、[ビッグデータシステムの構築および分析に関心のある入門者] のために
"Mastering Big Data Processing: Tools and Techniques for Success" 講座をオープンいたしました。
「授業およびプロフィール」の詳細は、授業詳細ページに詳しく記載しましたので、そちらをご参照ください 🙏🏻
全体
36件 ∙ (4時間 51分)
講座資料:
全体
21件
4.8
21件の受講レビュー

受講レビュー 4
∙
平均評価 5.0
5
理論からコードラップまで初期入務者に本当におすすめする講義です! ビッグデータクラスタ構築講義で必須で受講することをおすすめします!
こんにちはYeonwoo Jungさん、 大切な受講評 ありがとうございます。機会があれば、1日2日投資して、AWSで実践に従うことができます。明けましておめでとうございます:)
受講レビュー 1
∙
平均評価 5.0
5
まもなく卒業を控えた、データエンジニアを志望するコムボールと学生です。 雇用関連ポートフォリオを作成しながら、ビッグデータを処理するためのパイプラインとアーキテクチャをどのように構成し、どのようにaws環境を設定してできるだけ低コストで効率的に利用できるか悩みが多かったが、本講義を通じて膨大なインサイトとノウハウを手に入れます。 特に、ビッグデータを扱うさまざまなフレームワークに関する多くの知識も得られるようになり、今後どのように掘り下げられるのかインスピレーションを得たようで嬉しいです。 干ばつの終わりにダンビーに会いました。私のようにこちらの分野を志望される学生の方に受講おすすめです。
こんにちはone831、 大切な受講評ありがとうございます、今後も良い結果がありますようにファイティングです
受講レビュー 4
∙
平均評価 4.5
受講レビュー 3
∙
平均評価 5.0

受講レビュー 2
∙
平均評価 5.0
5
以前はパイプライン講義を聞いて見た講義を聞いていますが、頭の中によく入ってきてとても良いです〜 コンパクトで実務に使われる講義ありがとうございます〜 この講義もすぐに入ってしまいそうですが、他の講義もあるかと期待されます。
2日かかりましたね。 lab形式だからちょっと早く進んで、 namenode 起動ができなくてシャベルするのが難しかったのに(おそらくどこかミスしてそうだった) 後で見たら trouble shoot guide 部分に起動手順スクリプトとログ見る部分整理しておきましたね。これを見たら、もっと早く間違いを修復しました。 もし進んでいる方はみんな追いつくよりは一度精読して従うのもいいと思います~ 講師。良い講義毎回ありがとうございます〜
こんにちはJason.Kingさん、 私の今回の講義を熱心に受講していただきありがとうございます :) 時々バグや trouble shooting を直接体験してみて悩んで見て復活してみるのがたくさん役に立つ時があるのでむしろ今回の経験が今後大きな助けになると思われます。 大規模なオフソースを直接構築してみるとクラスタを構築してみましたので、他のオフソースが出ても今すぐ早く構築することができます。これからもファイティングです
知識共有者の他の講座はこちら
同じ分野の他の講座を見てみましょう!


講義サムネイル](https://cdn.inflearn.com/public/courses/324183/cover/fbe9f0cc-4c42-4435-b855-f283f6932415/324183.png?w=420)