inflearn logo
知識共有
inflearn logo

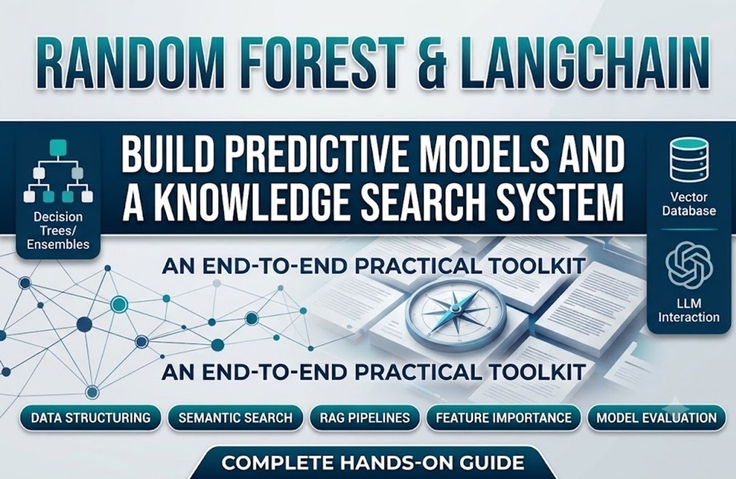
ランダムフォレストからLangChain知識検索システムまで:データ分析とLLMの実務活用

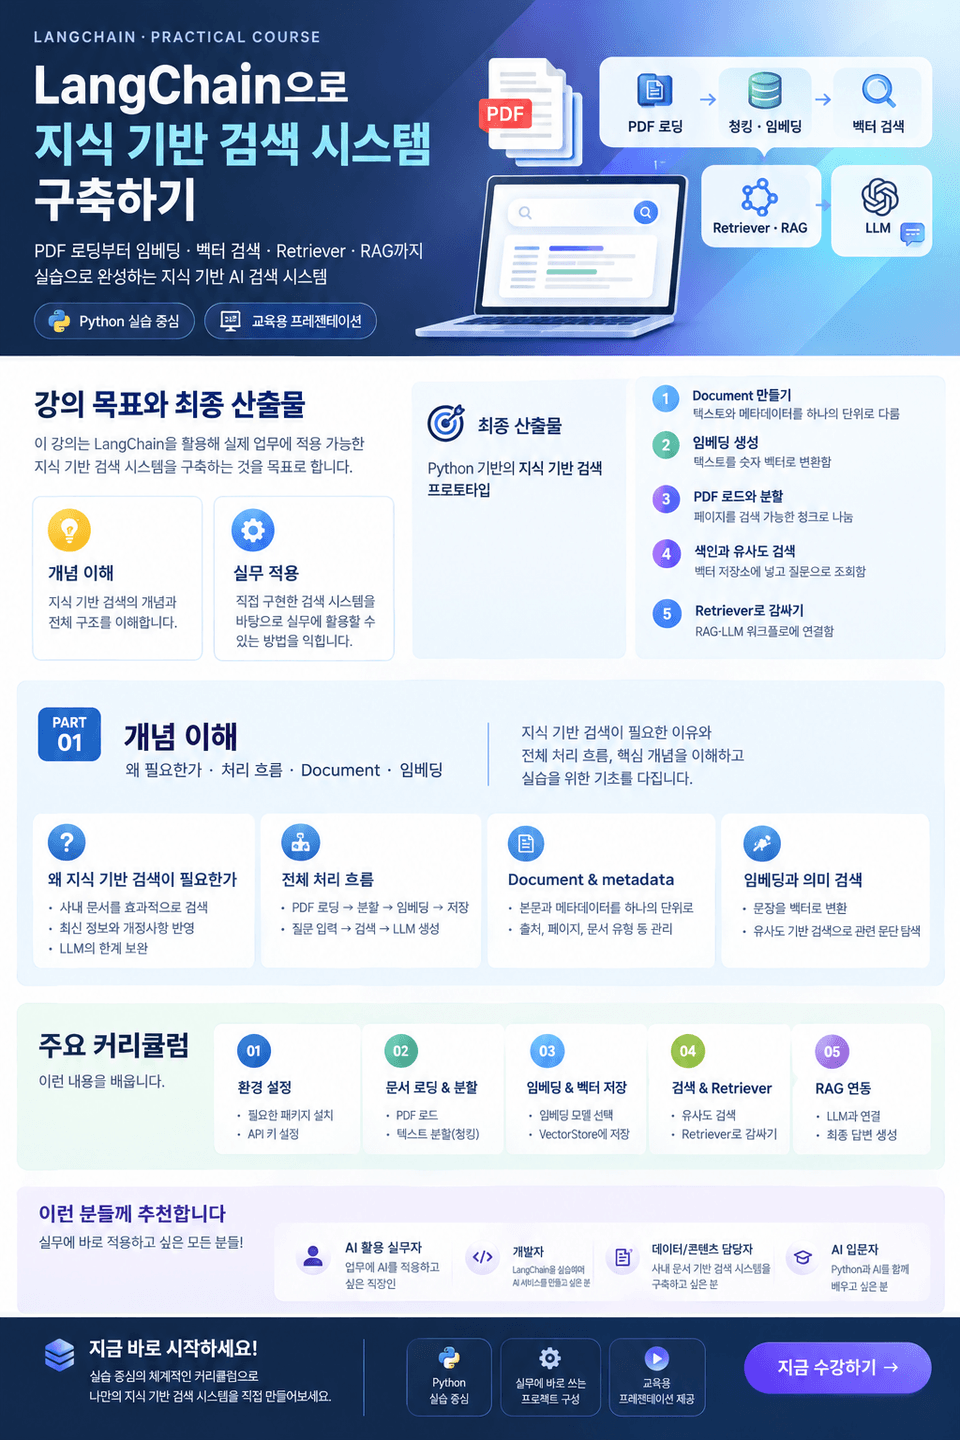
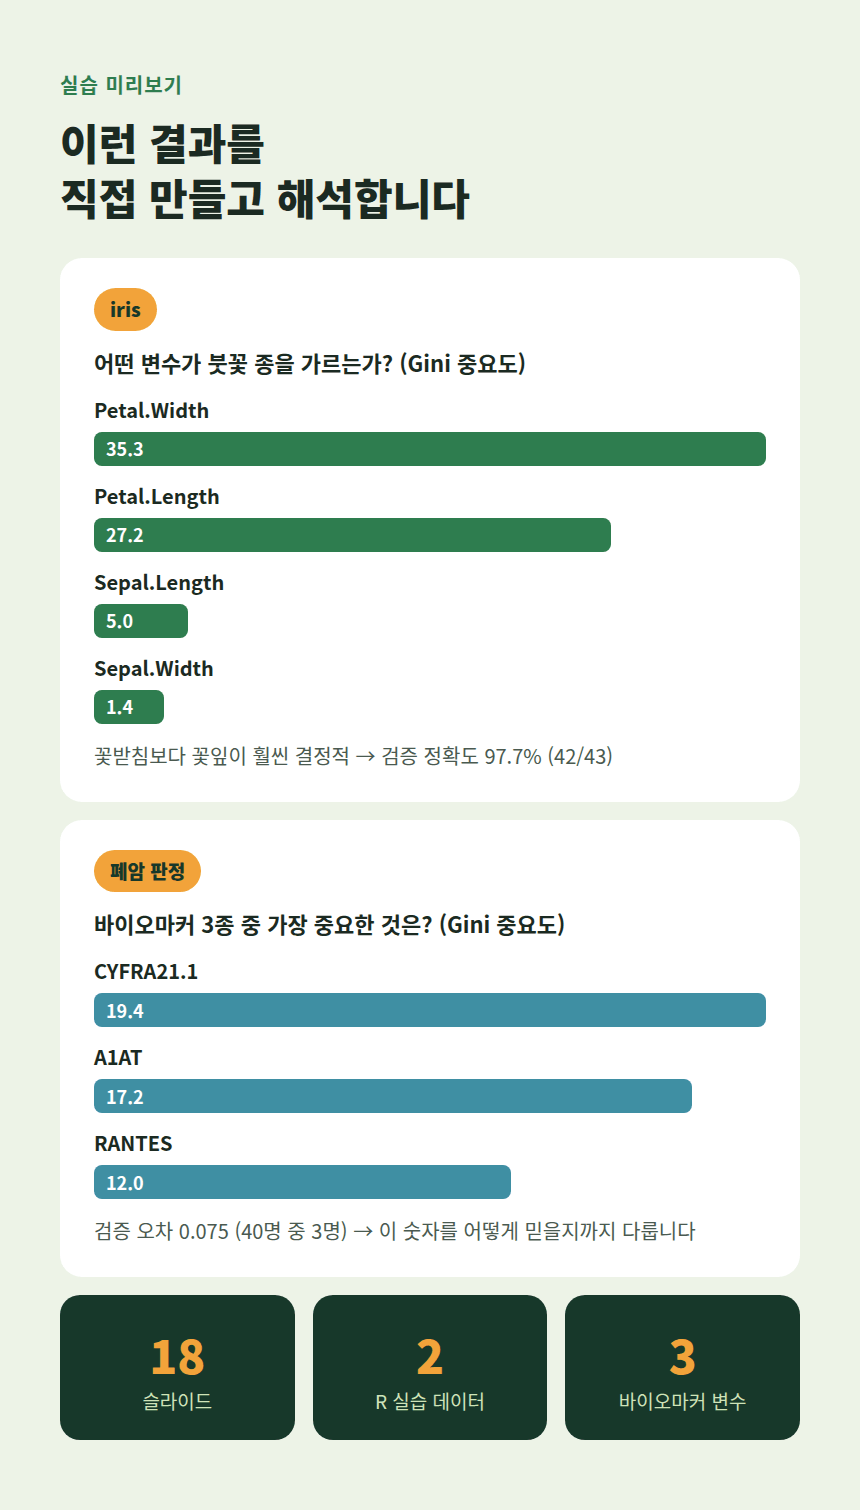
Part I PDFをページごとのDocumentとして読み込み、チャンク化し、埋め込みによってベクトル化してベクトルストアにインデックスするプロセスをコードで実習する。 質問をベクトルに変換して類似度検索(スコア・ベクトル・MMRを含む)を行い、これをRetriever(Runnable)でラップしてRAGに接続する構成を学ぶ。 検索品質のチェック、セキュリティ・ガバナンス(プロンプトインジェクションを含む)、よくあるミスを整理し、実務適用の基準を身につける。 Part II 意思決定木の限界を克服したランダムフォレストアルゴリズムをRで実装し、モデルの結果を正確に解釈する方法を学ぶ。 アヤメのデータと実際のバイオマーカーデータを活用し、OOB誤差、変数重要度、混同行列などの主要指標を読み取り、説明する能力を高める。 ハイパーパラメータチューニングと交差検証、ROC曲線分析まで、実務にすぐ適用できる一連のワークフローを完成させる。

1名 が受講中です。

難易度 初級

受講期間 3か月

Python
Python
R
R
vector-database
vector-database
AI
AI
figma variable
figma variable
Python
Python
R
R
vector-database
vector-database
AI
AI
figma variable
figma variable

受講後に得られること

  • OOB誤差と変数重要度指標を解釈し、モデルの信頼性を評価するとともに主要な変数を特定する

  • ntreeとmtryのハイパーパラメータ調整によるモデル最適化およびROC曲線に基づく性能比較

  • データ単位の処理:Documentオブジェクトを活用してテキストとメタデータ(出典、ページなど)を構造化する方法

  • 長い文書を適切なサイズのチャンクに分割し、OpenAIなどの埋め込みモデルを通じて文を数値ベクトルに変換する

  • ベクトル検索とRetriever:ベクトルストア(Vector Store)のインデックス作成からRetrieverによる類似度/MMR検索まで

  • LLMワークフロー(RAG)で接続する完全なエンドツーエンド(End-to-End)アーキテクチャ

  • 単純なLLMの記憶に依存するのではなく、社内規定やマニュアルなどの実際のPDF文書から、質問に最も近い段落を正確に見つけ出す検索プロトタイプ

  • 幻覚(Hallucination)の管理および出典の保持:検索された段落の原文内容だけでなく、出典ファイル名、ページ番号、文字位置(start_index)などのメタデータも併せて保持する

パート I

  • LangChain、つなぐことより検索結果を活用する方法:PDFの読み込み・埋め込み・ベクトル検索・RAG

  • LangChainで学ぶ知識ベース検索システム:原理からPython実習、検索結果の解釈まで

  • 文書内の根拠を探すAI検索システム(PDFからRetriever・RAGまで)

  • LangChain検索システムの完成:Document・チャンク分割・埋め込み・ベクトル検索・Retriever・RAG

Part II

  • ランダムフォレストを回すより結果を読み解く方法:Rで完結する分類・変数重要度・チューニング

  • Rで学ぶランダムフォレスト:原理から肺がん判定の実習、結果の解釈まで

  • 数字の裏にある物語を読み解くランダムフォレスト(irisからバイオマーカーまで)

  • ランダムフォレスト完全攻略:原理・R実習・OOB・変数重要度・チューニング

こんな方に
おすすめです

学習対象は
誰でしょう?

  • 機械学習のコードは実行したものの、出力結果の意味を理解できないデータ分析初心者

  • Rを活用した分類モデルの構築と解釈能力を向上させたい生物統計学研究者

  • ランダムフォレストの理論と実務での適用方法を体系的に学ぼうとするデータサイエンス学習者

  • 社内に蓄積されている数多くのPDF規程集やマニュアルをLLMと連携

  • 単にAPIを呼び出すだけでなく、Documentオブジェクトの構造、テキストのチャンク分割(RecursiveCharacterTextSplitter)、埋め込み(Embedding)の原理、ベクトルストア(Vector Store)のインデックス作成、そしてRetrieverとRAGへと続くアーキテクチャ全体の流れを確認したいです。

前提知識、
必要でしょうか?

  • Rプログラミングの基本構文とデータフレーム操作の経験

  • 意思決定木(Decision Tree)アルゴリズムの基礎概念の理解

  • 分類問題と混同行列(Confusion Matrix)に関する基礎知識

  • テキスト文字列(String)、リスト(List)、辞書(Dictionary)などのデータを扱う基本的な操作方法

  • コマンドプロンプト(CMD)、PowerShell、またはターミナル環境でのディレクトリ移動(cd)および基本コマンドの実行経験

  • 仮想環境を作成し、パッケージ管理ツールであるpipを使って必要なライブラリをインストールした経験

こんにちは
aha30005480です。

キャリア認証

データ分析・AI専門講師

  • 企業および公共機関向けのデータ分析・統計研修に多数出講

  • 職業専門教育院 ビッグデータ・AI課程 専任講師

  • データ分析、統計、社会調査分野の実務および教育の専門家

  • SPSS、R、Pythonを基盤としたデータ分析および統計実習講義

  • 社会調査分析士、ビッグデータ分析技師資格試験対策講座の運営

  • 著書:データサイエンティストシリーズ Step1~4、AI分析のためのビッグデータ構築(構造化および非構造化韓国語データ)、社会調査分析士2級 筆記&実技(記述式)、データ分析ツールR Fundamental

もっと見る
講座掲載日: 
最終更新日: 

受講レビュー

まだ十分な評価が集まっていない講座です。
ぜひ最初のレビューをお寄せください。

aha30005480の他の講座

知識共有者の他の講座はこちら

似ている講座

同じ分野の他の講座を見てみましょう!

期間限定セール

¥1,650

70%

¥714