inflearn logo
知識共有
inflearn logo

AIレッドチーミング3 - レッドチーム業務と脅威モデリング

実行前に、範囲・交戦規則・試験条件・判定根拠を定めます。AI資産と信頼境界、STRIDEシナリオを関連付け、レッドチーム計画書と脅威モデル書を作成し、反復結果から主張できる範囲を区別します。

1名 が受講中です。

難易度 初級

受講期間 無制限

Penetration Testing
Penetration Testing
security
security
AI
AI
LLM
LLM
Offensive Security
Offensive Security
Penetration Testing
Penetration Testing
security
security
AI
AI
LLM
LLM
Offensive Security
Offensive Security

受講後に得られること

  • レッドチーム・ブルーチーム・パープルチームの役割と診断方法の違いを区別します。

  • 範囲・禁止行為・中止基準・承認手順を盛り込んだ交戦規則と計画書を作成します。

  • 同じ条件下で完了した評価、成立回数、エラーと未観測を区別し、反復結果の限界を記録します。

  • AI資産・信頼境界・STRIDE・シナリオカードを関連付けて、ミッション3の脅威モデル文書を完成させます。

受講資料と実習案内

講義紹介(0-1) 授業の「資料ダウンロード」ボタンから、統合受講生資料ZIPをダウンロードしてください。最新の学習ガイド、是正実習キット、既存のミッション書式、証拠判定の事例・解説が含まれています。関連する判定授業の補足ノートと事例も併せて活用してください。

前の章は、講師の音声を基に作成したAI合成ナレーションです。実習では実際のAmazon Bedrockモデルを使用しますが、ツール・ドキュメントは教育用の模擬環境です。実際のメール送信やファイル削除は行いません。

AWSの利用料金は受講料とは別であり、モデル・リージョン・呼び出し量・ログの保管・維持リソース、ならびに無料利用の条件によって異なります。講義の費用は特定の条件における推定例であり、予算アラートは自動的に利用を停止するものではありません。実習後は使用量を確認し、リソースを整理してください。

なぜこの講義なのか

同じプロンプトを5回入力したところ、2回はシステムプロンプトが出力され、3回は拒否されました。報告書に「脆弱」とだけ書けば受け取った側は何をすべきか分からず、「安全」と書けば嘘になります。

AI診断がWeb診断と分かれるのはここであり、この一行をどう書くかがこの講義の問いです。

無闇に攻撃する前に、実務のレッドチームが行うことから学びます。範囲と交戦規則を定め、再現率と判定基準を設定し、基礎1で構築したバックエンドを対象に脅威モデルを描きます。手元には、レッドチーム計画書と脅威モデル書の2枚が残ります。

この講義を終えるとできること

  • レッドチーム・ブルーチーム・パープルチーム、脆弱性診断・ペネトレーションテスト・レッドチーミングがそれぞれどのように異なるのかを1枚で区別します

  • 交戦規定(ROE)に範囲・禁止行為・緊急中止・承認を記載し、診断担当者を保護する計画書を作成します(ミッション2)

  • 同じ条件下で完了した評価・成立回数・エラーを区別し、成立根拠と観測限界に応じた判定ルール・試験範囲を設定します

  • AIアプリケーションを6つの区画に分解し、資産をモデル・データ・インターフェースの3系列に分類して台帳に登録します

  • 信頼境界を5か所引き、STRIDEの6項目をAIに合わせて適用します

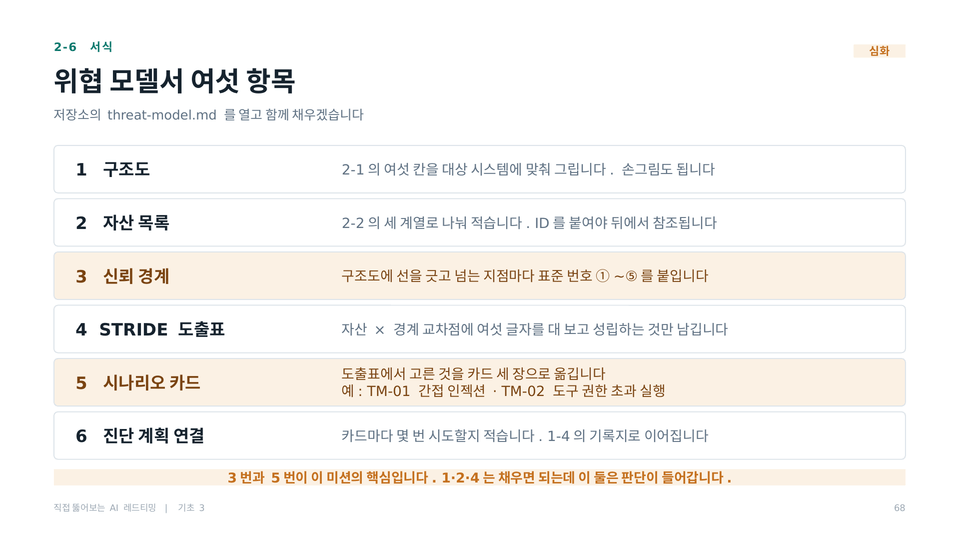
  • 攻撃シナリオカードを書き、脅威モデル書を完成させます(ミッション3)

このような方におすすめです

  • 基礎2まで終えて、攻撃対象領域マップを描いておいた受講生

  • AIシステムの点検報告書を書く必要があるものの、「同じ攻撃が、あるときは成功し、あるときは成功しない」とどのように記載すればよいか途方に暮れているセキュリティ実務担当者

  • Web上では脅威モデリングを行ったことがあるものの、LLM・エージェントにどのように適用すればよいかわからないセキュリティ担当者

  • ポートフォリオに入れる計画書・脅威モデル書の成果物が必要な就職準備生

このような方には向いていないかもしれません

  • この講座で実際の攻撃演習を期待している方――コンソール操作はなく、2枚の文書を作成します

  • 脅威モデリング自動化ツールの使い方を学びたい方 - 2種類の書式を手作業で記入する方式です

  • Web脅威モデリングの理論を深く扱うことを望む方 - STRIDEはAIに必要な分だけ読み直します

  • 基礎2のミッション1(攻撃対象領域マップ)がない方 - 第2部の脅威モデルがそのマップを引き継いで使います

講座の流れ - レッドチーム実務 → 判定基準 → 脅威モデル → 成果物2枚

全12回。セクションの順序がそのまま学習の順序です。

  • セクション1 · 講義紹介(1編 · プレビュー1編)

  • セクション2・第1部・レッドチームはどのように活動するのか(5編・プレビュー1編)

  • セクション3 · 第2部 · AI脅威モデリング(6編 · プレビュー1編)

受講前の確認事項

  • 基礎2のミッション1を完了した状態を前提とします。

  • 今回の講義のドキュメント課題は、新たにモデルを呼び出すことなく進められます。既存のAWSリソースの維持・使用料金については、別途ご確認ください。

  • テンプレート2種類(redteam-plan.md・threat-model.md)を資料室からダウンロードして記入します。

  • ナレーションは講師の声をもとに制作したAI合成音声です。

講義内容の詳細

第1部 · レッドチームはどのように活動するのか

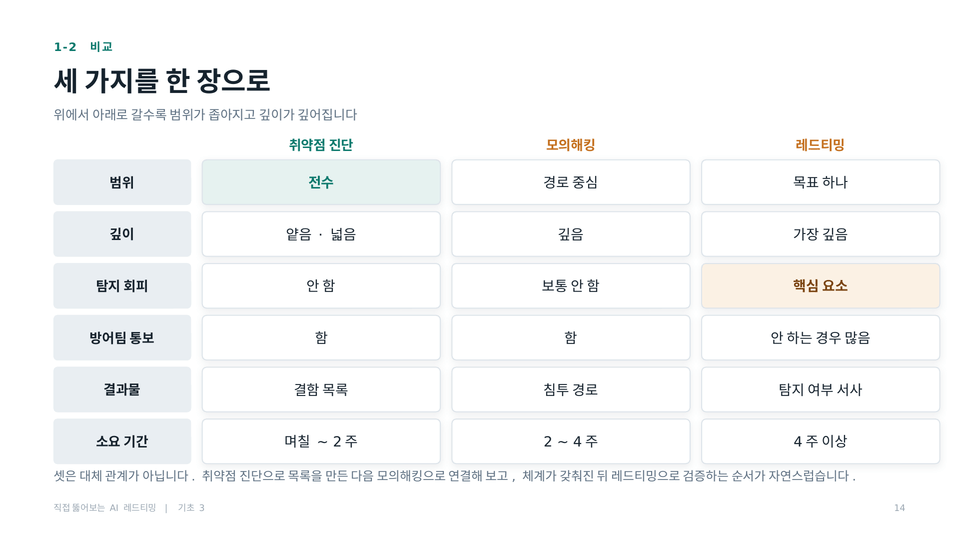
前の第1部では、レッドチームが実際にどのように活動するのかを見ていきます。レッドチーム・ブルーチーム・パープルチームがそれぞれどのようなチームなのか、脆弱性診断とペネトレーションテスト、レッドチーミングが範囲と深さにおいてどのように異なるのかを1枚にまとめ、争いが生じるポイントである交戦規則を扱います。含める項目のリストよりも除外項目のリストがなぜ重要なのか、どのような兆候が見られたら直ちに停止するのか、誰が承認し何を記録に残すのかを記した文書が診断担当者を守ります。次が非決定性です。

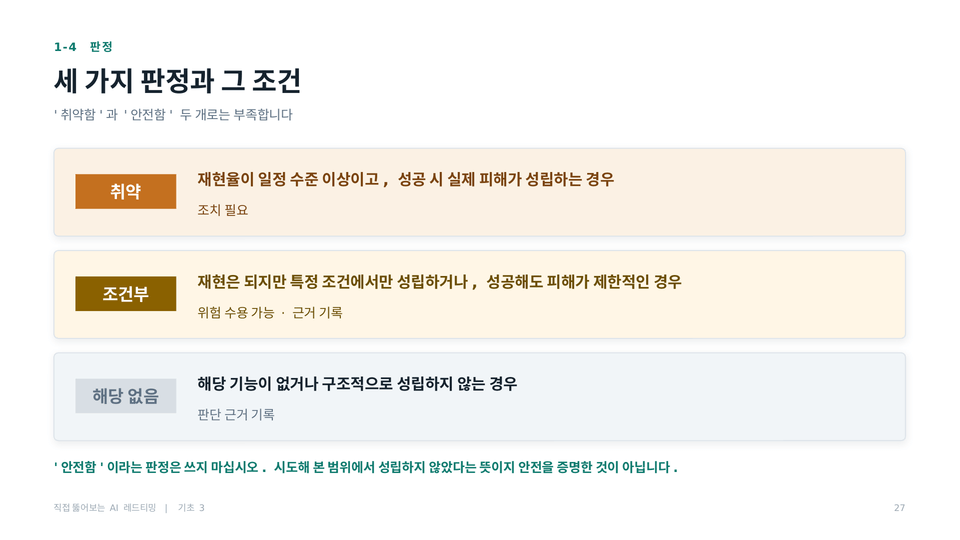
完了した評価、成立回数、エラーを区別し、判定の根拠と試験範囲を定めます。3・10・20回は講義における試験計画の例であり、回数だけで安全が保証されるわけではありません。未観測と構造上の該当なしを区別する補足事例も併せて使用します。1部は、レッドチーム計画書を自ら作成するミッション2で締めくくります。

第2部・AI脅威モデリング

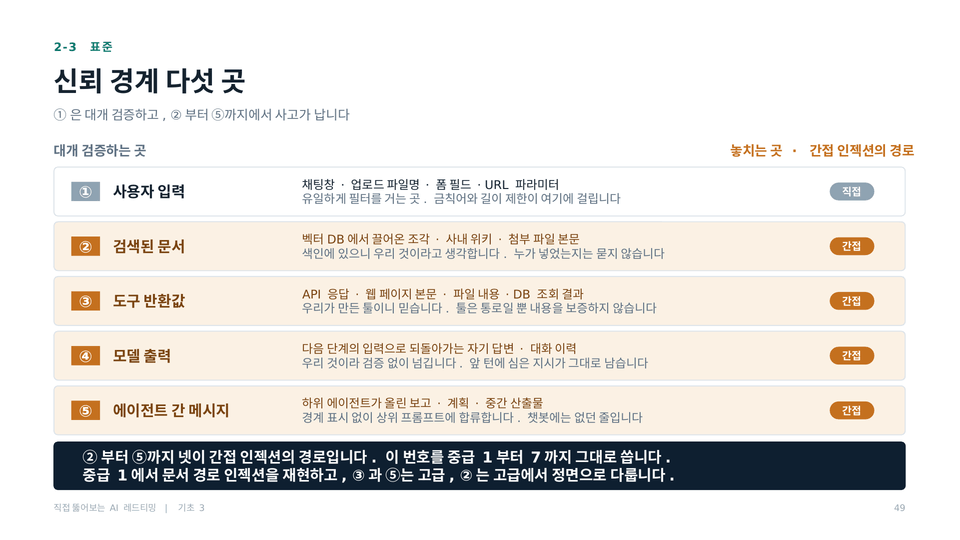
第2部は脅威モデルです。1つのリクエストが通過する6つの区画に沿ってAIアプリケーションを解剖し、自分たちで作ったものと借りて使うものを分け、資産をモデル・データ・インターフェースの3系列として台帳に登録します。続いて信頼境界を5か所に引きますが、この5つの番号は中級1から発展まで、後続の講義でそのまま使います。STRIDEの6文字をAIに合わせて読み替え、攻撃シナリオカードの書き方まで身につけたら、ミッション3で脅威モデル文書を完成させます。

構成と学習方法

構成は全12回で、講義紹介の後、第1部の5回と第2部の6回がそれぞれミッションで締めくくられます。ミッション2と3では、同じ対象を続けて扱います。1-5で架空の社内AIチャットボットを対象に計画書を書くと、2-6で同じ対象について脅威モデル書を完成させる流れなので、2つの文書が別々になることなく、1件の診断準備資料になります。

2-5では、社内文書アシスタントチャットボットを例に、攻撃シナリオカードを実際に1枚書いてみせ、カードが20枚できたときにどれから確認するか、その順序を決める基準まで扱います。書式を埋める際に判断が分かれる項目は、その項目だけを質問掲示板に投稿していただければ、根拠を添えて回答します。

次の講義

ここで基礎パートは終了です。次の講義である中級1からは、基礎1の最後の回で見たあの画面を実際に突破しながら、パラメータ1つとコード1行が再現率をどのように変えるのかを記録します。

講義の特徴

  • 完了した評価のうち、成立回数と判定根拠・限界を併せて記載する方法を練習します。

  • 5つの信頼境界の番号がシリーズの最後まで引き継がれ、後続講義のすべての発見事項がこの番号で整理されます

  • 書式2種(計画書・脅威モデル書)を埋める方式なので、成果物がそのまま残ります

  • 既存の情報資産台帳に3列追加するだけの形で、実務ですぐ使えるように説明します

  • 扱う分野 - ペネトレーションテスト・オフェンシブセキュリティ・AI securityの観点からの人工知能(AI)セキュリティ、LLM脅威モデリング

受講を終えると

受講を終えると、レッドチーム計画書と脅威モデル書の2つが手元に残ります。どちらも資料室の書式に記入して作成する形式なので、そのままポートフォリオに入れられます。また、基礎2で描いた攻撃対象領域マップが、ここで脅威モデルへと発展します。ドキュメント課題は新たにモデルを呼び出すことなく進められますが、既存のAWSリソースの維持・利用料金については別途ご確認ください。

シリーズ「自分で突破してみるAIレッドチーミング」第7回講義

  • AIレッドチーミング 1 - LLMセキュリティ入門と実習環境

  • AIレッドチーミング 2 - LLMの動作原理と攻撃対象領域

  • AIレッドチーミング 3 - レッドチームの業務と脅威モデリング ← この講義

  • AIレッドチーミング 4 - プロンプトインジェクションを直接突破する

  • AIレッドチーミング 5 - 欠けた設定一つが開く攻撃

  • AIレッドチーミング 6 - エージェントとRAGを突破する

  • AIレッドチーミング 7 - 制御設計とレッドチーム報告書

前の講義のミッション成果物が次の講義の材料になる構成のため、番号順に公開され、未公開の講義は順次公開されます。

こんな方に
おすすめです

学習対象は
誰でしょう?

  • AI診断の範囲と判定根拠を定める必要があるセキュリティ担当者・診断員

  • AIサービスの信頼境界を設計またはレビューする開発者・アーキテクト

前提知識、
必要でしょうか?

  • 第2講義のミッション1:攻撃対象領域マップを準備してください。提供された実習環境の構成要素を理解し、文書編集ソフトでミッション2の計画書とミッション3の脅威モデル書を作成します。

こんにちは
rmsxodxod1289です。

キャリア認証

模擬ハッキングから出発し、情報セキュリティ管理体制を構築する実務者です。

完成車メーカーとエネルギー企業の年間セキュリティ診断を担当し、インフラ・Web・アプリケーションを

層ごとに診断し、同じ顧客企業のISMS-P認証を初回・事後・更新の3回にわたって

対応し、技術的保護対策の領域を単独で担当しました。

現在は、一人で担う情報保護担当者として初回認証取得の準備を進めながら、AIセキュリティガバナンス

体制を設計しています。基準がまだ形成途上にある領域であるため、統制対象の定義から

自ら構築しなければならない立場です。

情報セキュリティ技師・CPPG・ISO/IEC 27001審査員補の資格を保有しており、東国大学の国際情報保護񟿿

大学院の人工知能セキュリティ学科で、AI環境における情報漏えい経路と認証基準の照合を研究しています。

経験5年9か月。顧客企業名と実際に発見した脆弱性は秘密保持の対象であるため、講義では

取り扱いません。

もっと見る

受講レビュー

まだ十分な評価が集まっていない講座です。
ぜひ最初のレビューをお寄せください。

rmsxodxod1289の他の講座

知識共有者の他の講座はこちら

似ている講座

同じ分野の他の講座を見てみましょう!

期間限定セール

¥8

68%

¥3,910