inflearn logo
知識共有
inflearn logo

AIレッドチーミング2 - LLMの動作原理と攻撃対象領域

トークンとコンテキストからRAG・エージェント・ガードレールまで、AIサービスの動作をセキュリティの観点から読み解きます。概念を提供されたバックエンドコードと照らし合わせ、入力・検索・ツール呼び出しで確認すべきポイントを、攻撃対象領域マップ1枚に整理します。

2名 が受講中です。

難易度 入門

受講期間 無制限

AI
AI
prompt engineering
prompt engineering
LLM
LLM
Offensive Security
Offensive Security
RAG
RAG
AI
AI
prompt engineering
prompt engineering
LLM
LLM
Offensive Security
Offensive Security
RAG
RAG

受講後に得られること

  • トークン・コンテキスト・システムプロンプトがモデル入力を構成する仕組みを説明します。

  • RAGのインデックス作成・検索・入力組み立てと、エージェントのツール呼び出しフローを区別します。

  • ガードレールとアプリケーション制御が担う役割と限界を整理します。

  • 提供されたバックエンドコードとサービス構造を照合し、ミッション1の攻撃対象領域マップを作成します。

受講資料と実習案内

講義紹介(0-1) 授業の資料ダウンロードボタンから、統合受講生資料ZIPをダウンロードしてください。最新の学習ガイド、校正実習キット、既存のミッション書式、証拠判定の事例・解説が含まれています。関連する判定授業の補足ノートや事例も併せて活用してください。

前の講義は、講師の声をもとに作成したAI合成ナレーションです。実習では実際のAmazon Bedrockモデルを使用しますが、ツールやドキュメントは教育用の模擬環境です。実際のメール送信やファイル削除は行いません。

AWSの利用料金は受講料とは別途で、モデル・リージョン・呼び出し量・ログ保存・維持リソース、ならびに無料利用条件によって異なります。講義の費用は特定条件での推定例であり、予算アラートは自動停止ではありません。実習後は使用量を確認し、リソースを整理してください。

なぜこの講義なのか

プロンプトインジェクションの事例を二十件読んでも答えが出ない問いがあります。なぜ入力フィルターだけでは十分でない場合があるのか、なぜ「見せるな」と書かれたシステムプロンプトが外部に出てくるのか、なぜ検索文書一枚がモデルの行動を変えるのか。

手法を暗記するだけでは答えは出ません。モデルが入力をどのように受け取るのかを理解してこそ、答えが出ます。

この講義では、攻撃者が知る必要がある範囲に限って、その原理を見ていきます。1枚の図で説明し、基礎1でアップロードした皆さんのバックエンドのapp.pyにそのまま当てはめて、どの行がどの図に対応するのかを確認したうえで、皆さんが実際に利用しているAIサービスの攻撃対象領域のマップを描きます。

この講義を終えるとできるようになること

  • トークン処理と入力構成の仕組みを理解し、入力フィルターの役割と限界を説明します

  • システム指示・役割ごとの対話メッセージ・参考資料がモデル入力を構成する仕組みと、出所ごとの信頼度の違いを描き出します

  • RAGのインデックス作成・検索・注入の3段階のうち、どこが攻撃対象となる領域なのか、エージェントがツールを呼び出す際に誰の権限で動作するのかを確認します

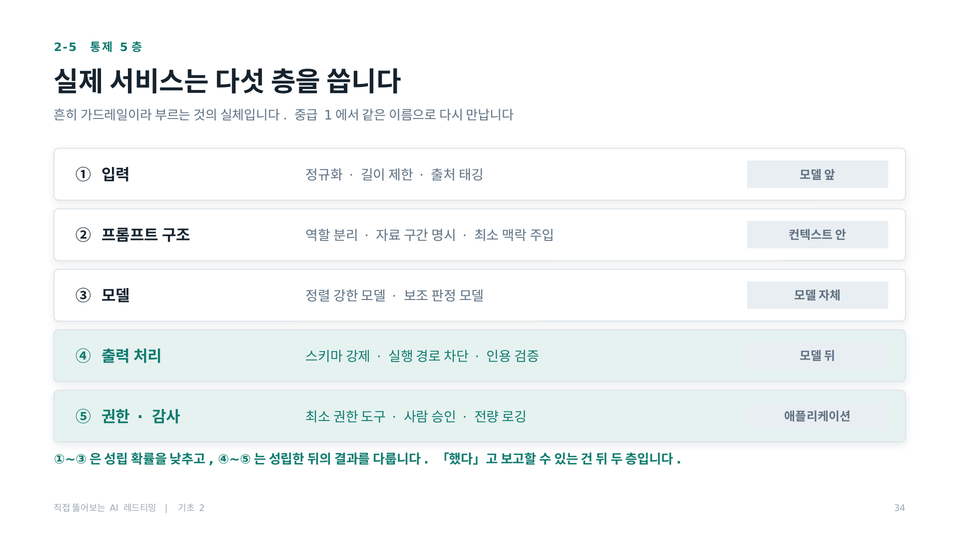
  • 実際のサービスが用いる5層の制御が、何を防ぎ、何を防げないのかを区別します

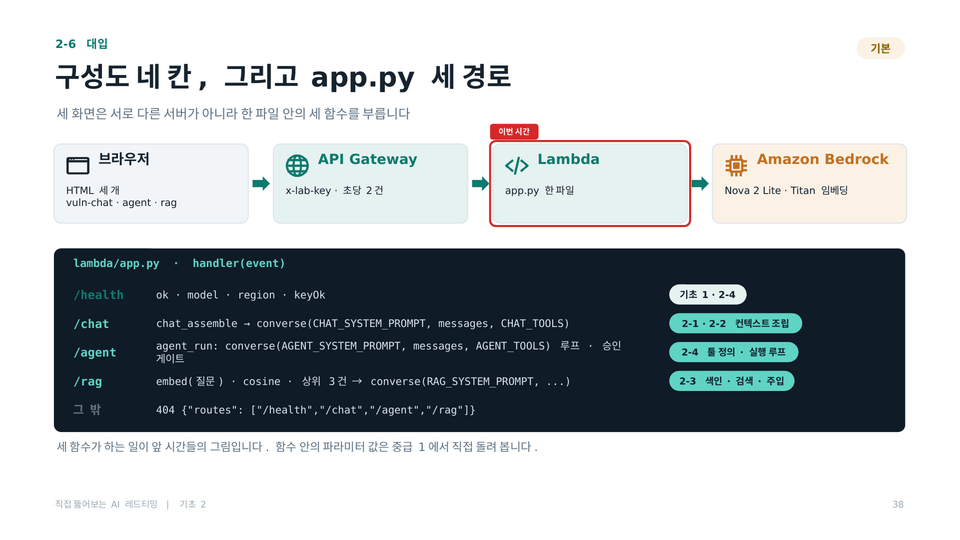
  • 基礎1で作成したapp.pyのconverse呼び出し1行に、この構造がどのように組み込まれているかを対応表で確認します

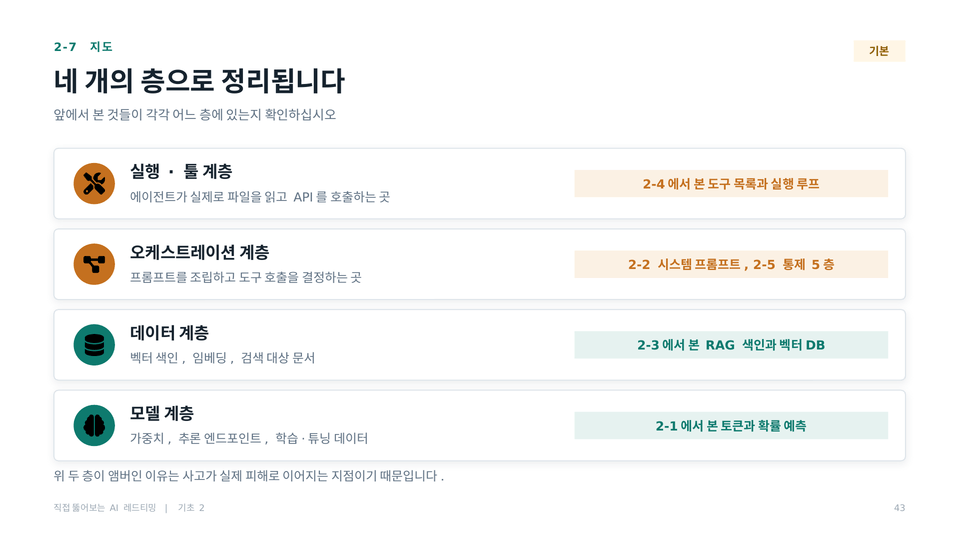
  • 私が使うAIサービスの攻撃対象領域を、4層のマップに描きます(ミッション1)

このような方におすすめです

  • 基礎1を修了し、実習用バックエンドを立ち上げておいた受講生

  • プロンプトインジェクションの成立条件と制御の限界を原理から知りたい開発者・セキュリティ担当者

  • LLM・RAG・エージェントを導入することで、どこにリスクが生じるのかを一枚で整理したい企画担当者・PM

このような方には向いていないかもしれません

  • トークン化アルゴリズムやトランスフォーマーの数式を学びたい方――数学は出てきません

  • コードを書く実習を期待している方――2-6ではapp.pyを読むだけで、作成はしません

  • この講義で直接攻撃を試してみたい方 - 攻撃する実習は第4講(中級1)からで、ここではなぜ突破されるのかを見ていきます

  • 基礎1のミッション0(実習バックエンドのデプロイ)を飛ばした方――2〜6回目の講義でそのコードを開きます

講義の流れ - 原理 → 自分のコードに当てはめる → 攻撃対象領域マップ

全8回。セクションの順序がそのまま学習の順序です。

  • セクション1 · 講義紹介(1編 · プレビュー1編)

  • セクション2 · LLMは入力をどのように受け取るのか(5編 · プレビュー1編)

  • セクション 3 · 自分のバックエンドコードに当てはめ、攻撃対象領域の地図を描く(2編 · プレビュー 1編)

受講前の確認事項

  • 基礎1のミッション0を終えていることを前提とします。

  • この講義はコードの読み取りとマップ作成が中心です。新たなモデル呼び出しは必須ではありませんが、既存のAWSリソースの使用・維持費用については別途ご確認ください。

  • ブラウザ中心の講義であり、私のPCにインストールするものはありません。

  • ナレーションは講師の声を基に制作したAI合成音声です。

講義内容の詳細

LLMは入力をどのように受け取るのか

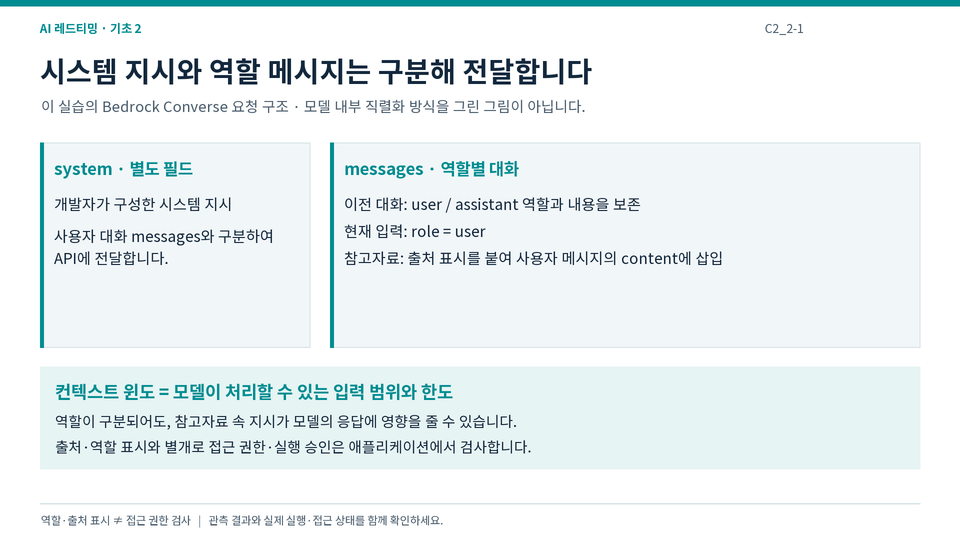
モデルはテキストをトークン単位で処理し、APIはシステム指示と役割ごとの会話メッセージを区別します。実習のBedrock Converse呼び出しでも、systemを別フィールドで送信し、user・assistantメッセージを使用します。参考資料は、出典表示とともにユーザーメッセージ本文に追加されます。役割や出典表示があるという事実と、アプリケーションの権限・データアクセス制御が保証されることは、区別して検討します。

次に、システムプロンプトだけでは権限境界を保証するのが難しい理由、RAGが文書を分割・検索して注入する3段階のうちどこが攻撃対象領域になるのか、エージェントがツールを呼び出す際に誰の権限で動作するのかを順に確認し、実際のサービスで使われている5層の制御が何を防ぎ、何を防げないのかまで見ていきます。

自分のバックエンドコードに当てはめ、攻撃対象領域のマップを描く

図だけで終わらせません。2〜6時限では、基礎1で皆さんが構築したバックエンドのapp.pyを開き、Converse呼び出しのsystem・messages・toolConfigがそれぞれどのように構成されているのかを対応表で確認します。出典ごとの断片を作るchat_assembleと、役割ごとのメッセージ・参考資料を構成する呼び出し経路も区別します。講義の図が自分のアカウントのコードのどこにあるのか、そしてどの制御層が空いているのかが、この時点で見えてきます。最後の時限では、これまで見てきたものを4層の地図に整理し、ミッション1で皆さんが実際に使っているAIサービスの攻撃対象領域を描いてみます。この地図が、基礎3で描く信頼境界の下絵になります。

数学やコード作成の課題はありません。基礎1のミッション0を終えていることを前提とし、スタックを削除した場合は、デプロイ手順に従って再度準備してください。準備にかかる時間は、アカウント・権限・モデルへのアクセス状況によって異なり、既存リソースの費用も確認する必要があります。

構成と学習方法

構成は全8回で、各回の再生時間は現在のカリキュラムで確認できます。図とコードを結び付ける形式になっているため、概念編の6本は移動中に聴き、2-6「コードの代入」と2-7「ミッション1」だけは画面の前でご覧ください。各回の最後のまとめスライドには、その回の図と一文がもう一度表示されるので、後で中級編でつまずいたときに、該当するスライドとコードの説明を再度確認できます。

ミッション1は、書式なしで皆さんが実際に使っているAIサービスを1つ選び、その4層マップを描くことです。どのサービスを選べばよいか迷ったら、質問掲示板にサービス名だけ書いていただければ、方向性をお伝えします。

次の講義

次の講義である基礎3では、やみくもに攻撃する前に実務のレッドチームが行うこと、つまり範囲を定め、資産を数え、脅威モデルを描く手順を学び、ここで描いた攻撃面マップを脅威モデル書へと発展させます。

講義の特徴

  • "90パーセント守られるものと、必ず守られるものは異なる"という一文を原理として説明します

  • 図 → 自分のアカウントのコード → 攻撃サーフェス・マップの順に、抽象から実物へと落とし込みます

  • ベクトルDBのように資産台帳から抜け落ちやすいものを、どこで押さえるべきか実務の観点から確認します

  • 全8回を、概念理解・コード照合・マップ作成の順に学習します。

  • 扱う分野 - 人工知能(AI)セキュリティ、LLMの動作原理、プロンプトエンジニアリングの観点から見た攻撃対象領域、RAGとAI Agent(エージェント)の構造、オフェンシブセキュリティ

受講を終えると

受講を終えると、「90パーセント守られることと、必ず守られることは違う」という一文を原理として説明できるようになり、皆さんが使っているAIサービスの一つについて、攻撃対象領域のマップが手元に残ります。このマップは基礎3で脅威モデル書へと成長します。

シリーズ「自分で突破してみるAIレッドチーミング」第7講義

  • AIレッドチーミング 1 - LLMセキュリティ入門と実習環境

  • AIレッドチーミング 2 - LLMの動作原理と攻撃対象領域 ← この講義

  • AIレッドチーミング 3 - レッドチームの業務と脅威モデリング

  • AIレッドチーミング 4 - プロンプトインジェクションを直接突破する

  • AIレッドチーミング 5 - ひとつの抜けた設定が開く攻撃

  • AIレッドチーミング 6 - エージェントとRAGを突破する

  • AIレッドチーミング 7 - 制御設計とレッドチーム報告書

前の講義のミッション成果物が後の講義の材料となる構成のため、番号順に公開され、未公開の講義は順次公開されます。

こんな方に
おすすめです

学習対象は
誰でしょう?

  • LLM・RAG・エージェントをどこから点検すべきか整理しようとするセキュリティ実務担当者

  • AIサービスの構成要素とリスクポイントをともに理解しようとする開発者・PM

前提知識、
必要でしょうか?

  • 第1講義のミッション0で配布した実習環境と、最初のクエリ体験が必要です。数学やコード作成は求められず、提供されたバックエンドコードを案内に従って読む回が含まれます。

こんにちは
rmsxodxod1289です。

キャリア認証

模擬ハッキングから出発し、情報セキュリティ管理体制を構築する実務者です。

完成車メーカーとエネルギー企業の年間セキュリティ診断を担当し、インフラ・Web・アプリケーションを

層ごとに診断し、同じ顧客企業のISMS-P認証を初回・事後・更新の3回にわたって

対応し、技術的保護対策の領域を単独で担当しました。

現在は、一人で担う情報保護担当者として初回認証取得の準備を進めながら、AIセキュリティガバナンス

体制を設計しています。基準がまだ形成途上にある領域であるため、統制対象の定義から

自ら構築しなければならない立場です。

情報セキュリティ技師・CPPG・ISO/IEC 27001審査員補の資格を保有しており、東国大学の国際情報保護񟿿

大学院の人工知能セキュリティ学科で、AI環境における情報漏えい経路と認証基準の照合を研究しています。

経験5年9か月。顧客企業名と実際に発見した脆弱性は秘密保持の対象であるため、講義では

取り扱いません。

もっと見る

受講レビュー

まだ十分な評価が集まっていない講座です。
ぜひ最初のレビューをお寄せください。

rmsxodxod1289の他の講座

知識共有者の他の講座はこちら

似ている講座

同じ分野の他の講座を見てみましょう!

新規会員登録で25%OFF

¥1,995

25%

¥2,665