実践しながら学ぶクローリングマスター withデータ工房
Pythonクローリングマスター。これ一冊でインストールから応用まで一気に。 実際に活用するのに必ず必要な内容だけをぎっしり詰め込みました。
お知らせ
8 件
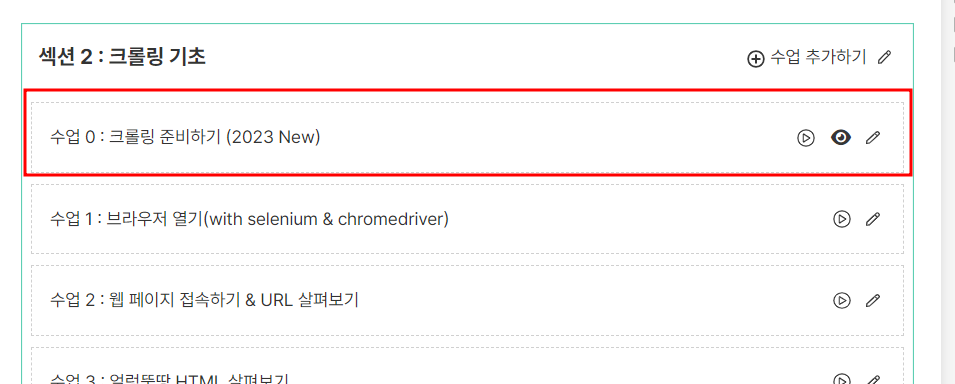
2023年初のアップデートで、
Chromeブラウザバージョン自動管理ライブラリの使い方のヒントを追加しました。
(既存のchromedriverのインストールセッションを変更しました)
この他にも、ライブラリ更新されながら変更された部分を反映して説明する映像、
そして他の講義も準備中です。参考にしてください
seleniumこのバージョンを更新しながら
find_elements_by_css_selector()命令を削除しました。
find_elements( 'css selector' , ) で使用できますので、該当する部分コードを変更してご使用ください。
詳細はブログにまとめておきました。
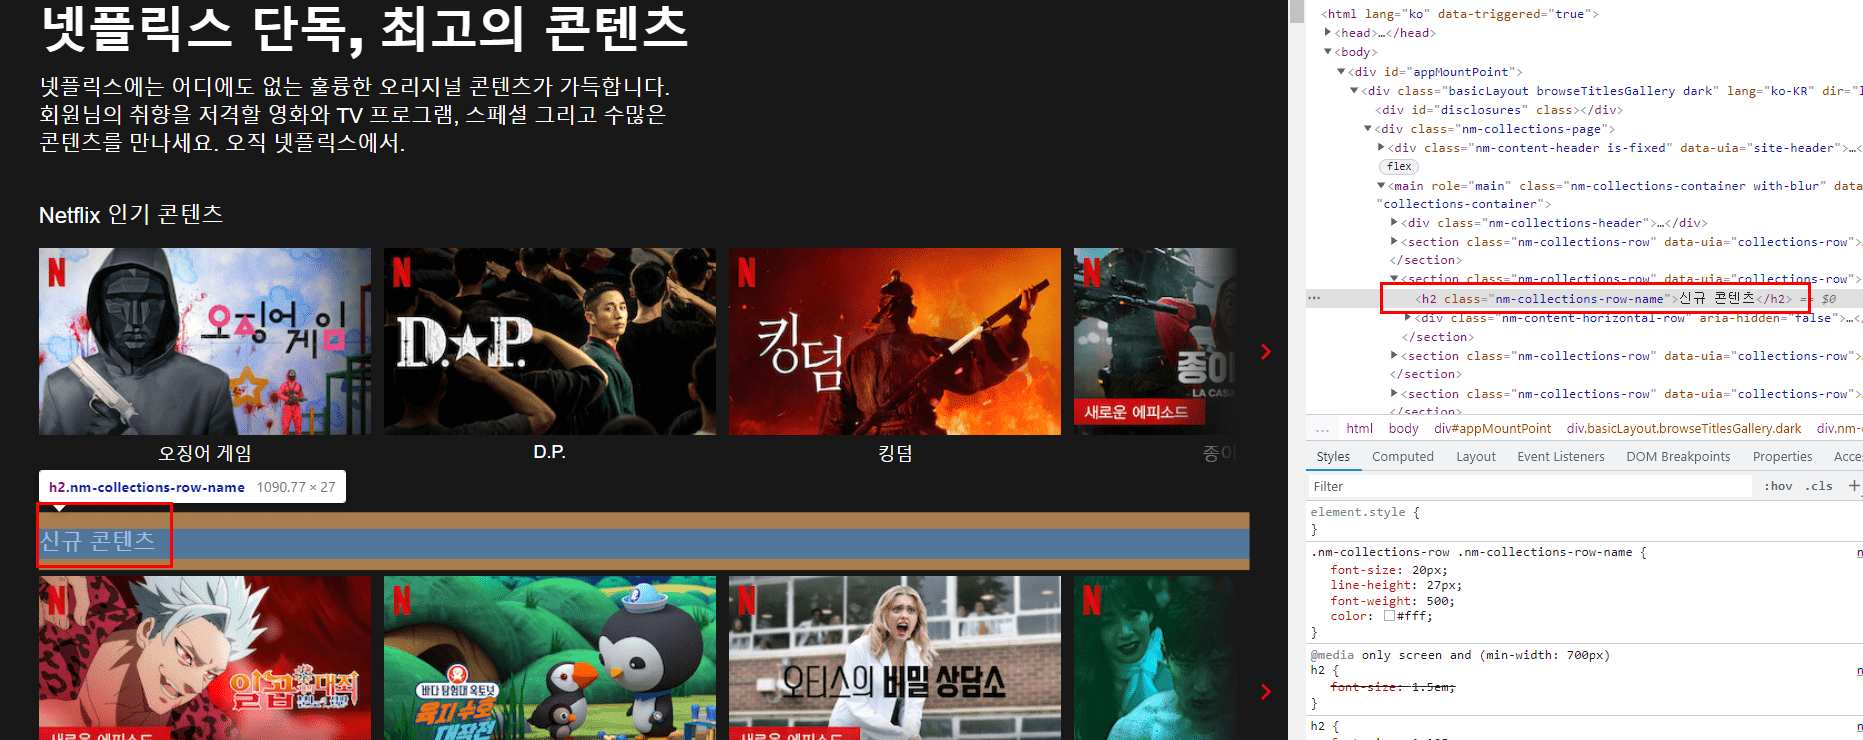
ネットフリックスサイト改編で、タイトル部分タグが変更されました。
その投稿の下に編集コードを追加します。
section_title = section.select('h3')[0].text #変更前)
section_title = section.select('h2')[0].text # 修正) セクションタイトル部分タグの変更
-----------------------
2022.01.01 追加修正
Netflixから画像ファイル、プログラムURL部分を取得するとき
情報がないか、異なる情報が含まれている場合があり、このとき、整理するコードを追加しました。
画像ファイル情報の場合
1. 画像ファイル情報を含む場合、
2. ファイル以外の形式(data:image/gif;base64,R0lGODlhAQABAAAAACH5BAEKAAEALAAAAAABAAEAAAICTAEAOw==) に含まれている場合(画面には画像は表示されません)
3. 画像ファイル情報自体がない場合がありますね。
上記のステップごとに1つずつチェックし、探している情報でない場合は、次の情報で整理するように
try、except構文、if条件文などを活用して以下のように修正しました。
-------------------------------------------------- ----------------------
try:
program_img = program.select('img')[0]['src']
if 'https' not in program_img:
program_img = ''#画像ファイルの場所が表示されない場合(画面に表示されない場合)は空白で入力する
except:
program_img = ''#画像情報自体がない場合は空白で入力
-------------------------------------------------- ----------------------
プログラムリンク部分もタグに情報がない場合があり、ない場合は空白が入力されるように整理しました。
-------------------------------------------------- ----------------------
try:
program_link = program.select('a')[0]['href']
except:
program_link = ''#リンクアドレスがない場合は空白で入力
-------------------------------------------------- ----------------------
updated 2021.09.30ネットフリックスサイト改編でセクションタイトル部分のタグが変更されました。
したがって、クロールコードも変更する必要があります。
[変更前]
section_title = section.select('h1')[0].text
[変更後]
section_title = section.select(' h2' )[0].text
※サイトは継続的に少しずつ変わるので、コードそのものよりは
私が進めながら説明するアプローチとBeautifulSoup select()コマンドの使い方を学ぶことをお勧めします。
(既に多くの方々が、、自分で見つけて進行をしましたね^^)
※セクションタイトル部分タグ画像
YouTubeのコメント収集する部分変更ご案内いたします。
YouTubeのコメントを収集すると、現在は以下のロジックに進みます。
1. YouTube全体のコメント数を取得する
2. 最大回数(500回)まで進行しながら、コメントスクロールダウン→全体のコメント数と一致する場合は停止
最初にインポートされたコメントの総数が大文字数だけを取得し、
以下で収集するコメント数は一般コメントのみカウントする問題がありました。
2つの方法でアクセス可能です。
1. すべての大コメントをインポートして数字でカウントする方法
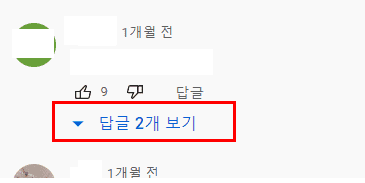
このときは、「返信を見る」ボタンを一つずつクリックすれば、大コメント情報収集が可能です。
これを行うと、1つずつクリックして結果を待つ待ち時間もかかり、大量のデータを収集します。
もっと時間がかかりますね。
2. コメントをスクロールし、既存のコメント数と差がない場合は停止します。
スクロールを下げながら、コメント数を先にまとめた数とずっと比較をして
スクロールしてもコメント数が増えないと完了した判断。このプロセスを止めることです。
2つの方法の長所と短所がありますが、2番目の方法はよりきれいに見える、
この方法でガイドをお届けします。
該当講義資料投稿(セクション5、YouTubeコメントを収集する2)にコード資料をアップロードします。
講義を進めると、受講生の方も役に立ちますが、
講師の私もとてもたくさん学ぶことになります。
主にオフラインや、オンラインでもリアルタイム講義を中心にしているのに
オンライン映像講義はどのように伝わるのか気になりますね。
より良い講義を準備し、自分自身を振り返るためにイベントを進めます。
講義評価/受講後期を残してください。
残してくださった方へ
気になる部分の説明や回答、フィードバック、面談などを解決できるように
1:1 オンライン相談券(30分)をお届けします。
受講評を作成された方は、私のメール(datago0ba0@gmail.com)でお申し付けください。
以降、両方とも進行可能な時間を決めて進めます。 (進行はZoomを利用して行います)
※イベント終了しました
YouTubeのクロールプロセスを追加しています。
これまで他のことが多すぎてアップデートをほとんどできませんでした。
リクエストがたくさん入った部分から順次作業してアップロードを進めます。
Youtubeをお待ちしている方はㅠあまりお待たせして申し訳ありません。
さらにお問い合わせのある部分は教えてください。ありがとうございます。
Instagramのクロールプロセスが追加されました。
その後もタイプ別にまとめて実習サイトを追加する予定です。
興味がある、または苦労している部分がある場合は、メールで教えてください datago0ba0@gmail.com
講義テーマの選定に参考いたします。ありがとうございます。
追加するレッスンは、可能であれば、既存の未使用の方法/関数を必ず使用する必要があります
サイトを活用する予定です。