채널톡 아이콘

[퇴근후딴짓] 빅데이터 분석기사 실기 (작업형1,2,3)

비전공자, 입문자가 빅데이터 분석기사 실기를 빠르게 취득할 수 있도록 안내해드려요! 이론은 가볍게, 실전은 확실하게 복잡한 배경지식 없이도, 기출문제를 중심으로 시험에 꼭 나오는 포인트만 집중 학습합니다.

(4.9) 수강평 932개

수강생 6,075명

난이도 입문

수강기한 12개월

새소식

97 개

  • 수강생 여러분을 위한 빅분기 오징어게임 2차 추가 쿠폰이 발행되었습니다.
    커리큘럼중 13회차 [빅분기 학습 모임] 링크를 클릭하시면 확인하실 수 있습니다.

    ※ 챌린지 특성상 시작 이후에는 추가 참여가 어려우니, 참여를 원하시는 분은 미리 신청해 주세요!


    image.png

    화이팅입니다. 응원합니다!

    0
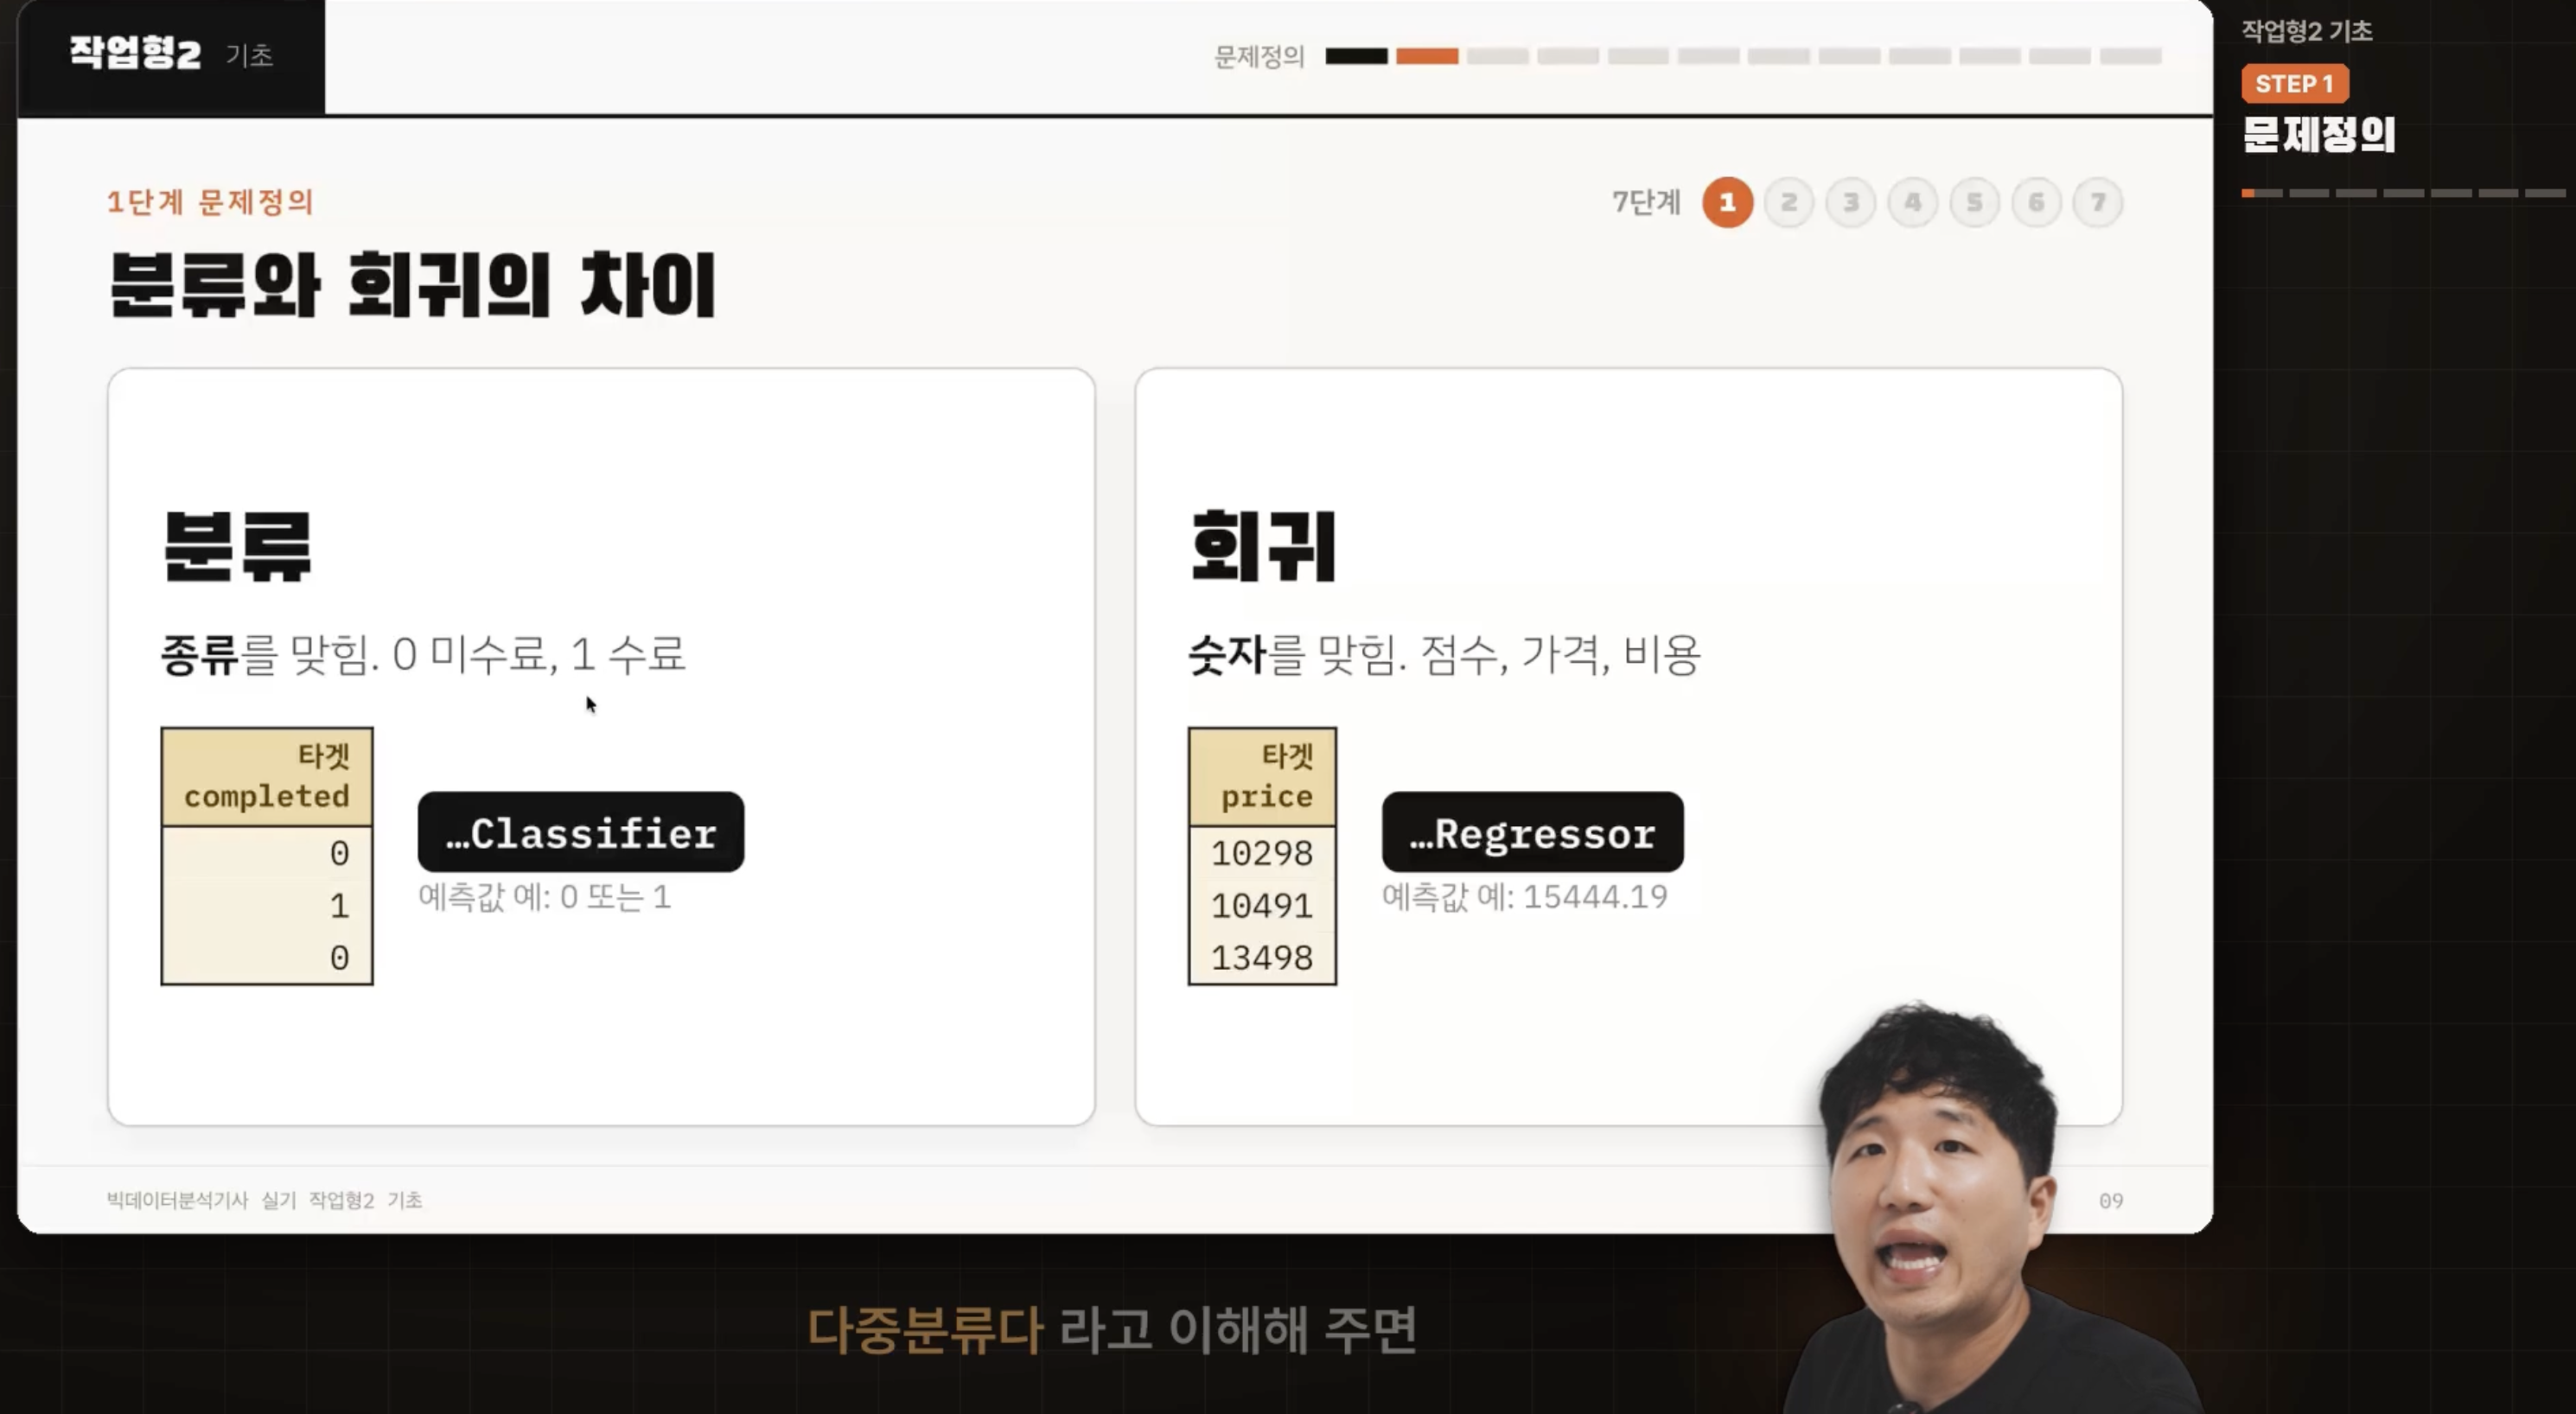
  • 작업형2 머신러닝 기초(작업형2 기초) 영상을 업데이트했습니다.
    기존에는 쉽게 이해할 수 있도록 코드 없이 장난감 블록에 비유해 설명했는데요,

    다소 가볍게 느껴질 수 있어 실제 시험 환경을 더 빨리 마주할 수 있도록 머신러닝 프로세스 중심으로 새로 구성했습니다.


    장난감 블록 영상은 최하단에 뒀다 추후 삭제 하도록 하겠습니다. (전체 강의 시간을 줄이기 위해...)

    가벼운 기초라 이미 작업형2를 공부하신 분들은 시청하지 않으셔도 됩니다.


    image.png
    0
  • 2~12회 기출로 보는 트렌드 영상 추가했습니다.

    가볍게 살펴보시죠 화이팅입니다.
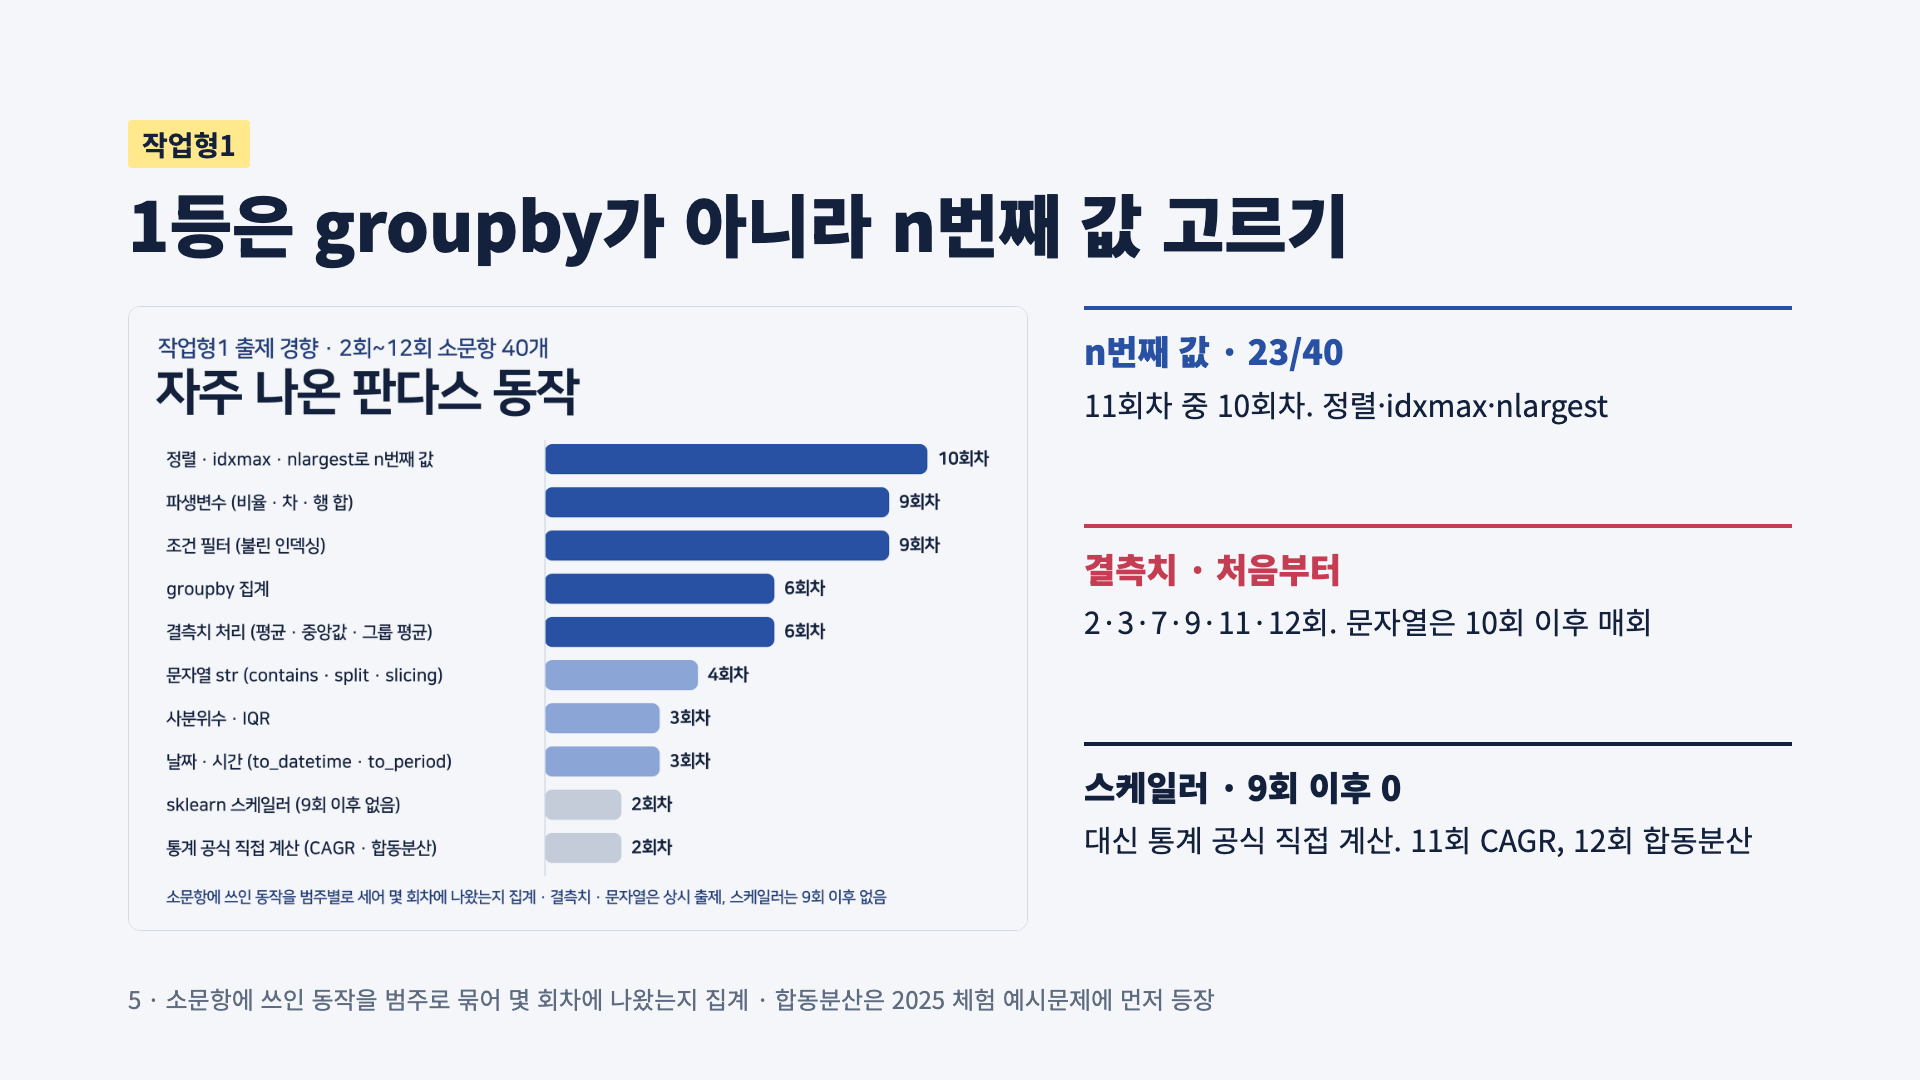
    image.png

    0
  • 안녕하세요.

    13회 준비 챌린지가 10월 초에 오픈될 예정입니다.

    다만 할인쿠폰은 챌린지 오픈 이후에 발행할 수 있어, 추후 별도로 발행할 예정입니다.

    챌린지 오픈 알림을 받으시더라도
    추후 이 곳 "새소식" 안내드릴 할인 쿠폰을 확인하신 뒤 참여부탁드립니다.

    감사합니다. 😊

    79a1c3c8-819d-4eee-bea1-7bc9ac7205b2.jpeg.webp
    0
  • 안녕하세요, 수강생 여러분!

    제12회 빅데이터분석기사 실기 기출유형 복원을 마쳤습니다. 🎉

    13회 시험을 준비하시는 분들 모두 응원합니다.

    합격까지 함께 달려요! 💪

    0
  • 안녕하세요.

    제13회 필기시험 접수가 내일(8/7 금) 18:00에 마감될 예정입니다.

    혹시 필기 합격 유효기간(2년)이 경과하여 필기시험을 다시 응시하셔야 하는 경우, 기간 내에 접수해 주시기 바랍니다.

    ▶ 접수 기간: 08.03(월) 10:00 ~ 08.07(금) 18:00

    감사합니다.

    0
  • 작업형2
    0점 처리와 관련해 문의 주신 분들이 많아,
    내용을 영상으로 정리해 봤습니다.

    https://youtu.be/nBu2GW84Yns


    결론: (마이너스 예측 값 처리에 대해서는 알 수 없으니) 발표를 기다려 보시죠!!

    0
  • 퇴근후딴짓님의 프로필 이미지

    ・

    수정됨

    열심히는 했는데 뭔가 불안한 당신을 위한 마지막 점검

    [공통]

    • help(), dir(), __all__로 모든 걸 해결할 수는 없어요.
      막상 시험장에서 처음 쓰면 생각보다 어색하니, 미리 시험 환경에서 테스트 해보세요

    • 자리 키보드·마우스·컴퓨터가 이상하면 테스트 시간 직후, 시험 시작 전에 자리 변경을 요청하세요. 중간에 바꾸려 하면 멘탈이 흔들립니다. 문제는 초반에 바로 해결하고 가는 게 좋아요.

    • 여러번 제출 가능한데 한번 제출하고나면 "제출"라고 나타납니다. "제출"로 뜨다보면 다시 제출 한다고 했다가 깜박할 수도 있으니 주의해 주세요. 마지막 제출본으로 체점합니다.


    [작업형1]

    • 상단 데이터 탭 → '기본보기' 클릭 후 Ctrl + F로 찾아서라도 확인하세요. "눈으로라도 풀어보겠다"는 마음으로 접근하면 됩니다.

    • 정답만 맞으면 됩니다. 과정 코드가 어떻든 상관없어요. 깔끔한 코드보다 정확한 답이 우선입니다.

    • groupby는 확실히 숙지하고 가세요. 피벗까지는 아니어도 그룹별 집계는 눈으로 풀기 어렵습니다. 이건 코드로 처리해야 해요.

    • 결과는 반올림·소수점 자리수·정수 변환 지시를 꼭 확인하세요. round()를 빠뜨리거나 자리수를 틀려서 정답을 코앞에서 놓치는 경우가 많습니다.


    • 정렬 문제는 오름차순/내림차순, 동점 처리를 잘 보세요. sort_values()의 ascending 옵션, reset_index 여부까지 챙기면 좋습니다.

    • 조건 필터링 시 &, |와 괄호를 정확히. df[(조건1) & (조건2)]에서 괄호 빼먹으면 에러납니다.
      조건을 cond 변수에 넣는다면 괄호 필요 없음

    • 날짜 데이터는 pd.to_datetime()으로 변환 후 .dt.year, .dt.month, .dt.dayofweek 등을 쓸 수 있게 해두세요. 요일·월별 집계 문제가 종종 나옵니다.

    • 자주 쓰는 함수는 손에 익혀두기: value_counts(), nlargest() / nsmallest(), quantile()(IQR 이상치 문제), fillna(), drop_duplicates(), astype().

    • 이상치·결측치 문제는 문제에서 준 기준(IQR, 표준편차, 특정 조건)을 그대로 따르세요. 본인이 아는 방식으로 임의 적용 금지.

    [작업형2]

    • 모델을 1개만 쓸 거라면 lightgbm으로 전체 학습하고 끝내면 됩니다.

    • 2~3개 이상 쓸 거라면 검증 후 비교하세요. 평가 지표가 헷갈리면 본인이 확실히 아는 지표로라도 비교하면 됩니다.

      • rf, lgb, xgb 위주로 보세요. 이 외 모델이 더 좋은 성능을 내는 경우는 아주 드뭅니다.

      • 비교가 끝났다면 전체 데이터로 다시 학습하는 것도 추천해요. 데이터마다 달라 성능 향상을 장담할 순 없지만, 11회처럼 불균형이 심각하다면 저는 전체로 학습하겠습니다.

    • 불균형 데이터라고 파라미터·하이퍼파라미터를 만진다고 성능이 무조건 오르진 않아요. 오히려 기본값일 때 가장 좋은 성능이 나오기도 합니다. 불안하면 기본 + 전체 학습

    • 스케일링에 너무 힘 빼지 마세요. rf, lgb, xgb는 모두 트리 계열 모델이라 스케일링에 따른 성능 변화가 미미합니다.

    • train/test 컬럼을 똑같이 맞추세요. 인코딩·전처리는 train과 test에 동일하게 적용해야 합니다. 원-핫 인코딩 후 컬럼 개수가 달라지는 실수가 있어요. 아직 기출에서 나온 적은 없지만 예시 문제에 있으니, train과 test를 합쳐서 처리하는 방법도 할 줄 알아야 합니다.

    • 예측 대상(target)을 명확히 하세요. 확률을 요구하는지(predict_proba), 클래스를 요구하는지(predict) 문제를 정확히 읽으세요. roc_auc면 확률, f1·accuracy면 보통 클래스입니다.

    • 제출 형식을 문제 그대로 맞추세요. 파일명, 컬럼명, 인덱스 포함 여부(index=False)까지. 행의 수 틀리면 0점 입니다.


    • 시간이 부족하면 성능향상 욕심내지 말고 일단 lightgbm으로 끝까지 돌려서 제출 파일부터 완성하세요. 완성이 우선, 최적화는 그다음입니다.

    [작업형3]

    • 작업형3은 "분석하시오" 같은 서술형·자유 분석 문제가 아닙니다. 문제에서 요구하는 분석만 정확히 시행하면 됩니다. 임의로 분석을 추가하거나 확장할 필요 없어요. 묻는 값만 구해서 출력하세요. 등분산인지 아닌지 문제에서 묻지도 않은 분석 수행 X

    • C() 사용은 분석 종류에 따라 다릅니다. 여기서 헷갈리는 분이 정말 많아요.

      • 분산분석(ANOVA): 독립변수(범주형)에 모두 C()를 사용합니다.

        • 예: ols('y ~ C(집단)', data=df), 이원배치라면 ols('y ~ C(A) + C(B) + C(A):C(B)', data=df)

        • 집단 간 차이를 보는 분석이라 독립변수를 범주형으로 처리해야 하기 때문입니다.

      • 회귀 / 로지스틱 회귀: C()를 함부로 쓰지 마세요.

        • 연속형(숫자) 변수는 그대로 넣습니다.

        • "이 변수는 숫자처럼 보이지만 범주형으로 처리하라"는 명시적 언급이 문제에 있을 때만 C()를 씁니다.

        • 임의 판단 금지!


    • summary() 읽는 법을 반드시 익혀두세요. 회귀·로지스틱 회귀에서 계수(coef), p-value, R-squared, 오즈비 등을 표에서 바로 찾아 답할 수 있어야 합니다. 포기하지 말고 이것만이라도 보고 가세요.

    • 가설검정은 유의수준(보통 0.05)과 p-value 비교가 핵심입니다. p < 0.05면 귀무가설 기각. 어떤 게 귀무/대립가설인지 문제에서 확인하세요.

    • 검정 종류를 정확히 고르세요 (단)일표본/대응(쌍체)표본/독립표본 t검정, 카이제곱(독립성·적합성), 상관분석, ANOVA 등을 보고 판단합니다.


    • 소수점 자리수, 반올림 지시는 작업형3에서도 똑같이 챙기세요. print() 출력도 잊지 말고요.


      작업형마다 어려운 문제가 1~2개씩 나올 수 있어요. 그 문제만 붙잡고 시간 다 쓰지 마세요. 어려운 문제는 잠시 두고, 풀 수 있는 다른 문제부터 확실히 검증하면서 점수를 챙기세요. 만점이 목표가 아닙니다. 70점, 합격이 목표예요!

      여기까지 준비하신 것만으로도 충분히 합격권입니다. 화이팅!! 시험 잘 보고 오세요! 💪
      여러분의 합격을 응원합니다. - 퇴근후딴짓-

    0

월 ₩24,200

5개월 할부 시

₩121,000

평생교육이용권 지원 강의