


넷플릭스 크롤링
807
작성한 질문수 7
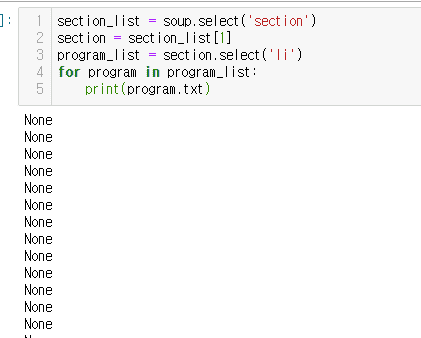
넷플릭스 크롤링 시스템 만들 때 섹션별로 영화 제목 따내는 거는 아무 오류 없었는데 섹션리스트 중에서 첫번째 섹션에서 프li태그 이용해서 프로그램 이미지랑 제목 html로 따낼 때
section_list = soup.select('section')
section = section_list[1]
program_list = section.select('li')
for program in program_list:
print(program.txt)
이렇게 했더니 결과가 None으로 여러개가 계속 나와요 뭐가 문제일까요??
답변 2
1
너무 늦은 시간인데 빠른 답변 감사합니다!! 고3인데 학교에서 한 활동 중 웹 크롤링으로 한 활동이 있었는데 기억이 잘 안나서 공부를 어떻게 다시해야될지 찾고있었는데 이 강의를 발견하고 나서 너무 든든하고 이해도 잘하고 있습니다!! 끝까지 완강하고 후기 더 남기겠습니다. 질문 생기면 또 할게요!!
0
안녕하세요.
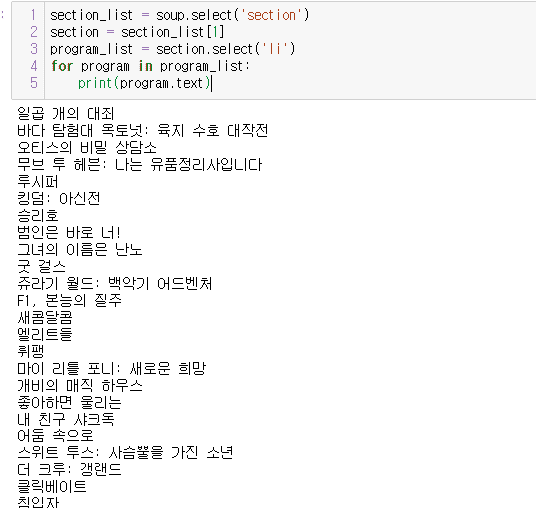
마지막 print 명령어에서
program.txt 로 되어있는 부분을
program.text
으로 변경하시면 될 것 같네요.
[기존]
[변경후 : txt → text ]
[클라우드 설정 중 앞 내용 문의 사항]
0
14
0
nvm버전이 변경되었습니다.
0
15
0
선생님 강의자료를 받을수 없어요! 메일보냈어요.
0
19
2
response api를 사용하는것과 codex, cluade code 에이전트를 사용하는것과의 차이
0
16
1
16강 구글 colab 에서 코드 실행이 안돼요.
0
32
1
object 컬럼이 여러 개인 경우 인코딩 전처리 방법
0
17
2
데이터 전처리 순서 관련
0
16
2
작업형2 모의문제 데이터 불러오기
0
23
2
강의 연장 부탁드립니다!
0
21
2
베개머리투자법 섹션 5를 듣고 질문드립니다.
0
23
2
[질문] 파이썬 버전 질문
0
24
1
강의자료, 코드 요청드립니다
0
36
1
모의고사 파일오류
0
60
3
미국 써머 타임 적용에 대해서 질문입니다.
0
28
1
테마분류 세부화 관련 질의
0
35
2
비만도까지 구하는 프로그램을 만들었습디나
0
38
1
수업자료 관련 문의
0
54
3
음성
0
42
2
모의고사 다운
0
42
1
클로드 API 기간설정에 대해서
1
43
1
2회 기출유형(작업형1) Warning
0
60
2
크롤링 페이지 접속 에러
0
563
1
넷플릭스 크롤링 데이터 엑셀파일저장
0
675
1
유튜브 크롤링 방법
0
421
1