inflearn logo

Thực chiến về kế hoạch thực thi và chỉ mục MySQL cùng trưởng nhóm DBA đang làm nghề — phòng khám truy vấn chậm dành cho lập trình viên backend

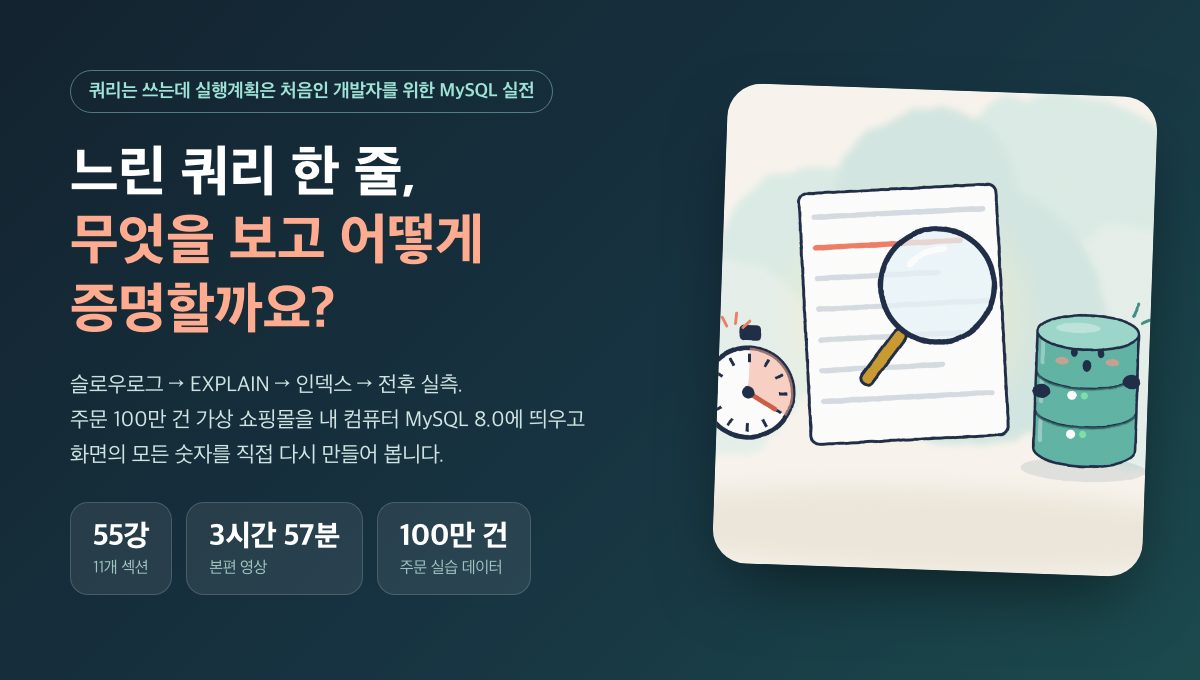
Khi nhận được một câu truy vấn chậm, bạn sẽ xem gì, sửa gì và chứng minh hiệu quả ra sao? Đây là khóa học thực hành gồm 55 bài, giúp bạn tự dựng một cửa hàng trực tuyến giả lập với 1 triệu đơn hàng trên máy tính của mình, rồi trực tiếp thực hành EXPLAIN, EXPLAIN ANALYZE và thiết kế chỉ mục.

1 học viên đang tham gia khóa học này

Độ khó Cơ bản

Thời gian Không giới hạn

SQL
SQL
MySQL
MySQL
Docker
Docker
DBMS/RDBMS
DBMS/RDBMS
SQLD
SQLD
SQL
SQL
MySQL
MySQL
Docker
Docker
DBMS/RDBMS
DBMS/RDBMS
SQLD
SQLD

Bạn sẽ nhận được điều này sau khi học.

  • Tự đọc type·key·rows·filtered·Extra của EXPLAIN và actual time·rows·loops của EXPLAIN ANALYZE.

  • Chọn các truy vấn cần tối ưu trước từ nhật ký truy vấn chậm và digest của performance_schema.

  • Xác định thứ tự chỉ mục ghép, khả năng bao phủ, sắp xếp và nhóm dựa trên số liệu đo thực tế trước và sau.

  • Giải thích thứ tự join, hash join và các phép biến đổi truy vấn con (semijoin, bảng dẫn xuất, truy vấn con tương quan) thông qua kế hoạch thực thi.

  • Kiểm tra tính tương đương của kết quả và chi phí ghi của truy vấn đã chỉnh sửa, đồng thời tìm hiểu cách hoàn tác an toàn bằng chỉ mục vô hình.


Khóa học này 񟿿

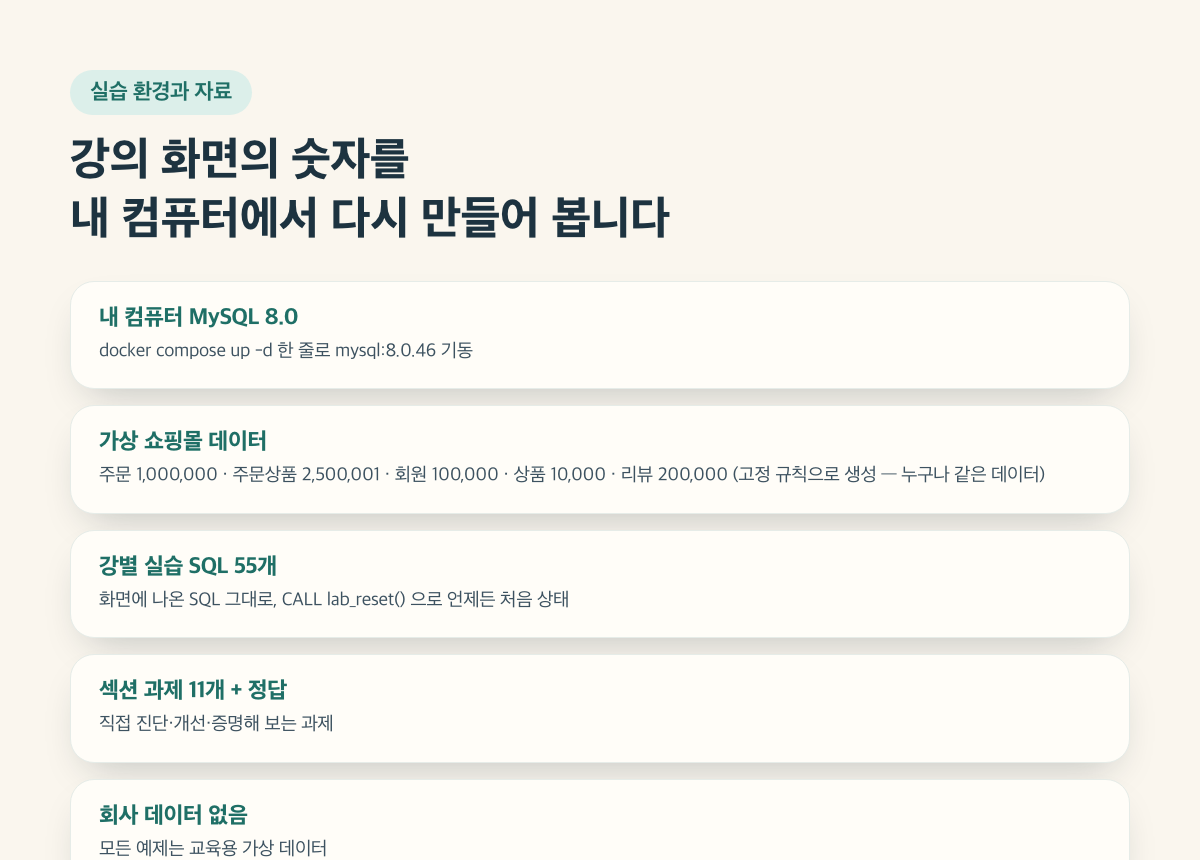
Khi nhận được một dòng truy vấn chậm, bạn sẽ xem xét điều gì, sửa gì và chứng minh bằng cách nào? Đây là khóa học thực hành gồm 55 bài, giúp bạn tự chạy EXPLAIN, EXPLAIN ANALYZE và thiết kế chỉ mục trên MySQL 8.0 cài trên máy tính của mình, với dữ liệu giả lập của một cửa hàng trực tuyến có 1 triệu đơn hàng.

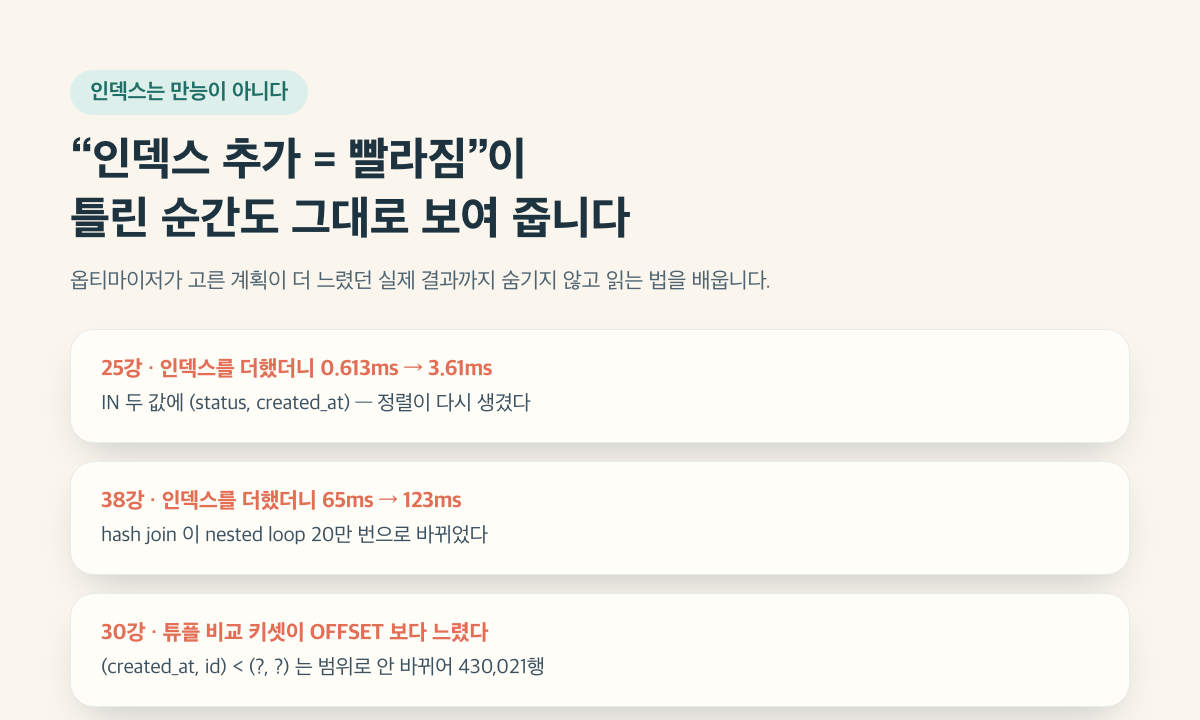
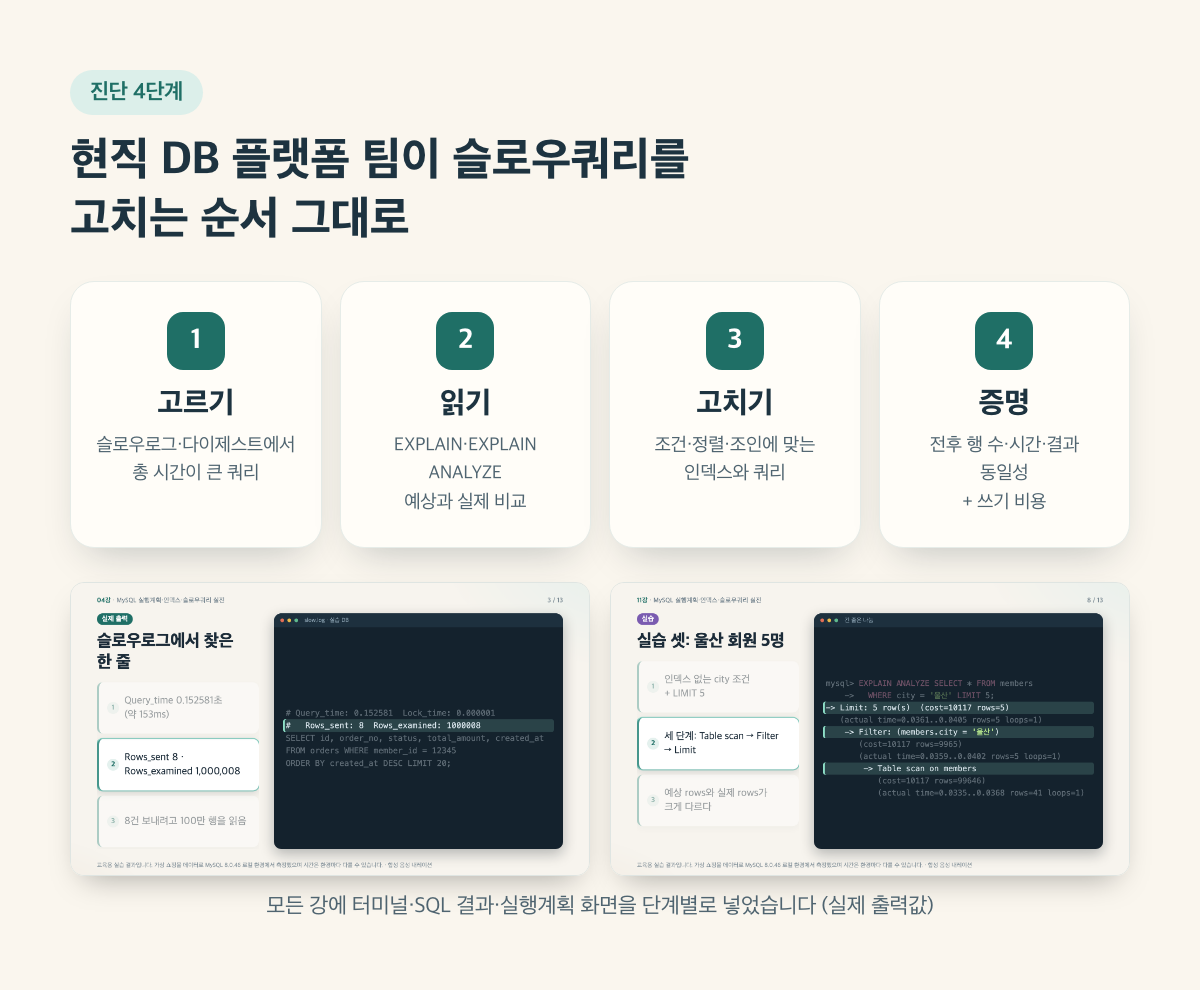
Thay vì chỉ tổng hợp khái niệm, bài giảng đi theo trình tự “triệu chứng (một dòng trong slow log) → chẩn đoán → khắc phục → chứng minh”, với các tình huống thường gặp trong quá trình vận hành của đội ngũ nền tảng DB được tái dựng bằng dữ liệu giả lập. Bài giảng cũng phân tích nguyên vẹn kết quả thực tế cho thấy việc thêm chỉ mục đôi khi lại khiến hệ thống chậm hơn.


Bạn sẽ học được những điều này.

  • Tự đọc các mục type·key·rows·filtered·Extra của EXPLAIN và actual time·rows·loops của EXPLAIN ANALYZE.

  • Trước tiên, chọn các truy vấn cần tối ưu từ slow log và các digest trong performance_schema.

  • Xác định thứ tự cột trong chỉ mục tổng hợp, chỉ mục bao phủ, sắp xếp và nhóm dựa trên số liệu đo thực tế trước và sau.

  • Giải thích thứ tự join, hash join và các phép chuyển đổi truy vấn con (semijoin, bảng dẫn xuất, truy vấn con tương quan) thông qua kế hoạch thực thi.

  • Tìm hiểu cách xác nhận kết quả của truy vấn đã chỉnh sửa có tương đương và chi phí ghi ra sao, cũng như cách hoàn tác an toàn bằng chỉ mục vô hình.

Phù hợp với những người sau đây

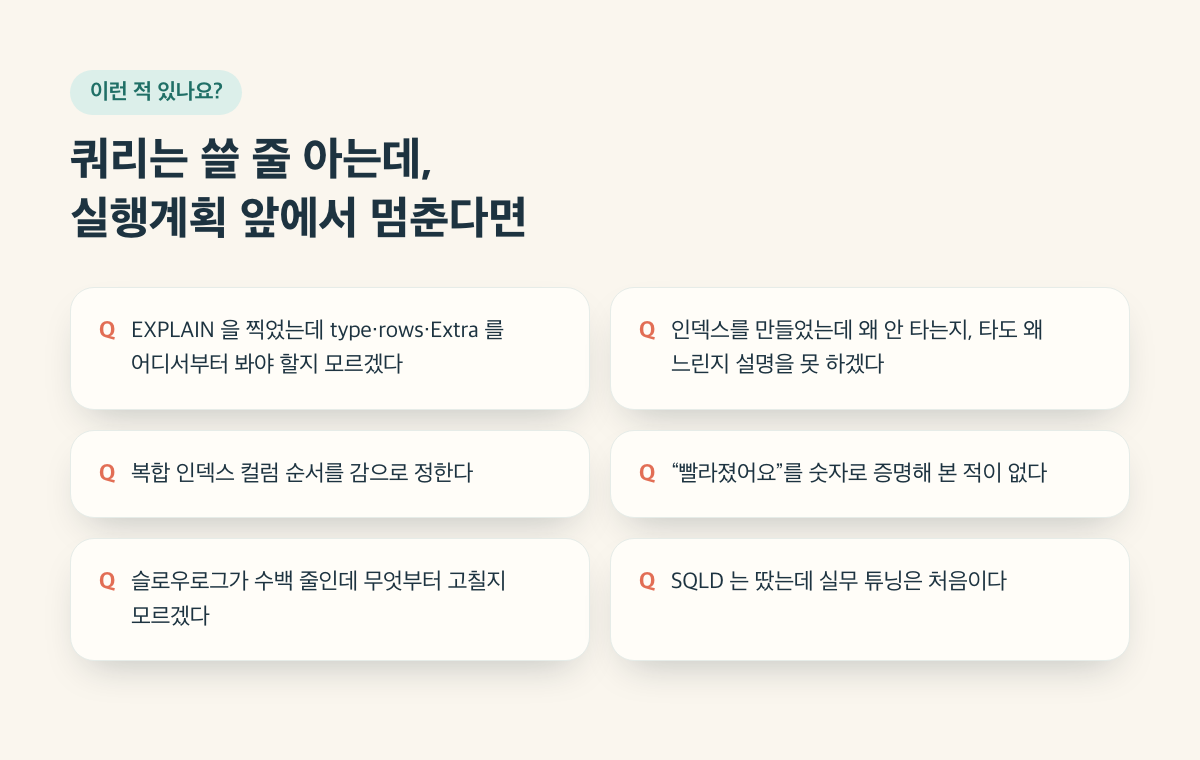
  • Lập trình viên backend biết viết truy vấn nhưng chưa từng đọc kế hoạch thực thi

  • Lập trình viên junior lần đầu được giao xử lý các truy vấn chậm

  • Dành cho những ai đang chuẩn bị thi SQLD hoặc đã thi xong và muốn bắt đầu tối ưu truy vấn trong công việc thực tế.

Kiến thức tiên quyết

  • Có thể đọc và viết SELECT·WHERE·JOIN·GROUP BY.

  • Cài đặt Docker Desktop và các lệnh cơ bản trong terminal

Những nội dung không được đề cập

  • Khóa, deadlock, mức độ cô lập (chủ đề của bài giảng riêng)

  • Tinh chỉnh tham số máy chủ · Phân vùng · Sharding

  • Vận hành Aurora và đám mây


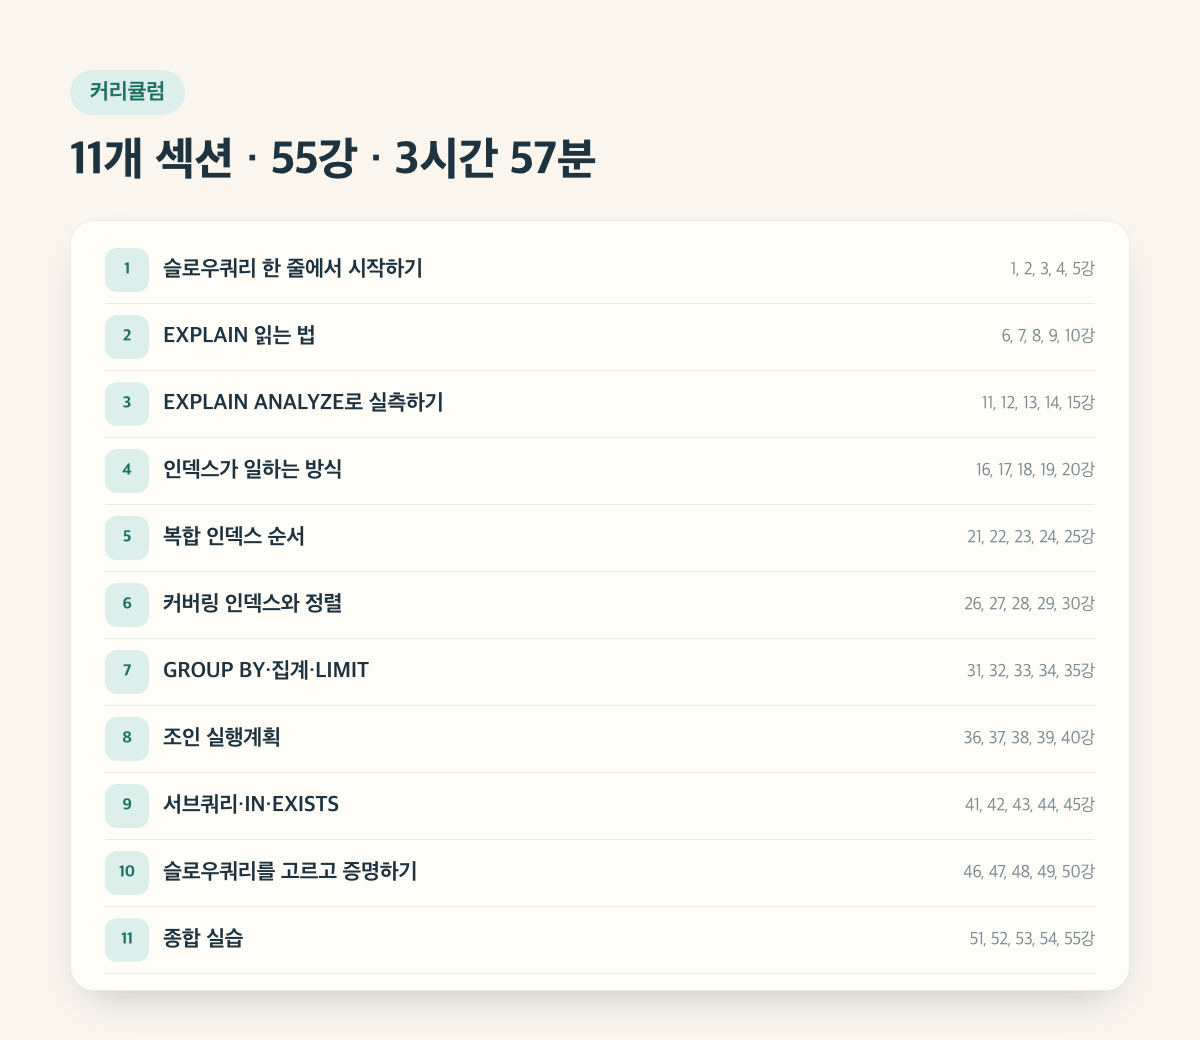
Lộ trình học (3 giờ 57 phút)

Phần 1. Bắt đầu từ một dòng truy vấn chậm

  • Bài 01: Lộ trình khóa học và môi trường thực hành (4:53) · Xem trước

  • Bài 02: Khám phá dữ liệu cửa hàng trực tuyến giả lập (4:19)

  • Bài 03 Bật slow log và đọc bản ghi đầu tiên (4:14)

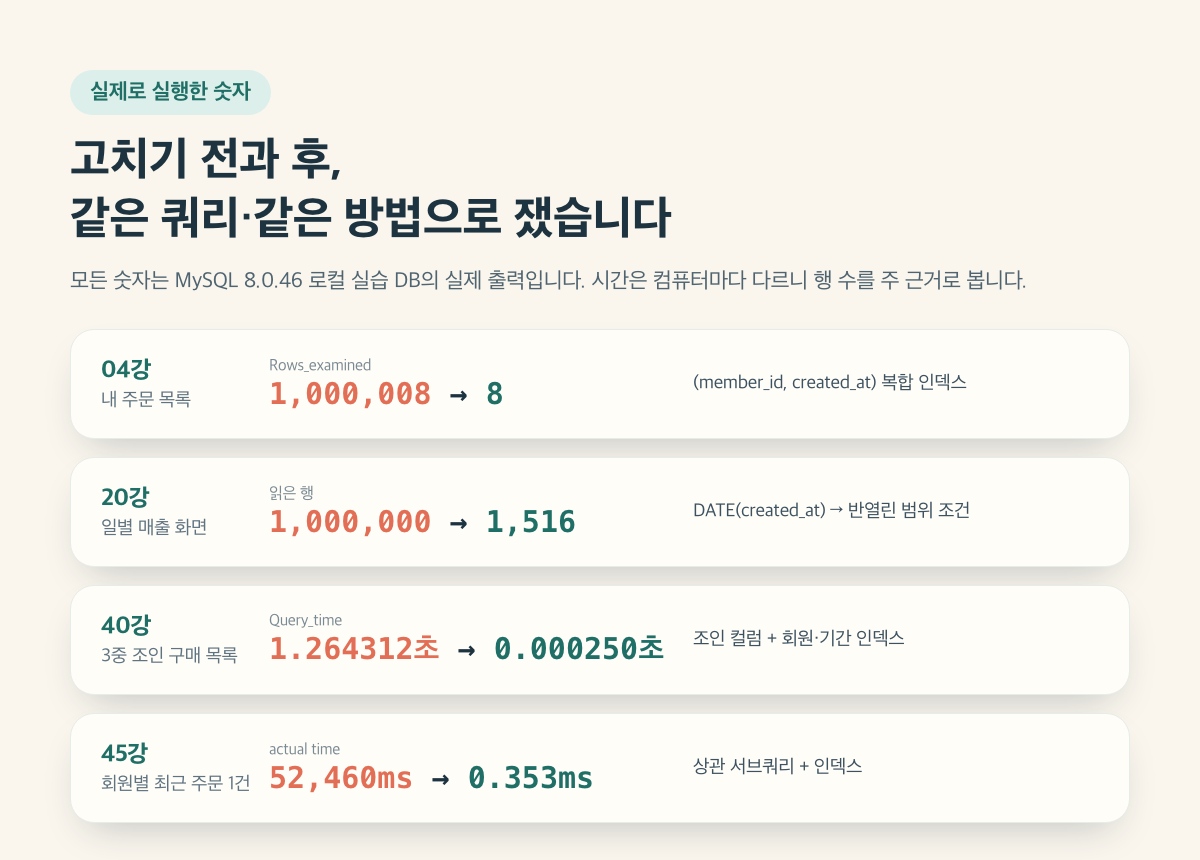
  • Bài 04 Danh sách đơn hàng chậm từ hôm qua (4:38) · Xem trước

  • Bài 05 Quy trình chẩn đoán gồm 4 bước (3:55)

Phần 2. Cách đọc EXPLAIN

  • Bài 06: Bản đồ nhiệt của EXPLAIN (4:01)

  • Bài 07: Thang type (4:07)

  • Bài 08 rows và filtered (4:27)

  • Bài 09 Đọc Extra (4:29)

  • Bài 10. Thứ tự đọc bằng FORMAT=TREE (4:21)

Phần 3. Đo thực tế bằng EXPLAIN ANALYZE

  • Bài 11 EXPLAIN ANALYZE: dự kiến và thực tế (4:46)

  • Bài 12 Nhân actual time với loops (4:14)

  • Bài 13 Khi số liệu thống kê bị sai lệch: Histogram (3:57)

  • Bài 14: Đếm số hàng đã đọc bằng bộ đếm Handler (3:41)

  • Bài 15 Dự kiến 984 hàng, thực tế 51,021 hàng (4:05)

Phần 4. Cách chỉ mục hoạt động

  • Bài 16 Khóa chính clustered (3:46)

  • Bài 17 Chỉ mục phụ và chi phí truy xuất dữ liệu (3:54)

  • Bài 18: Điều kiện không thể sử dụng chỉ mục (4:01)

  • Bài 19 Độ chọn lọc: cùng một chỉ mục, độ chọn lọc khác nhau (3:47)

  • Bài 20 Chỉ một DATE() cũng gây quét toàn bộ (4:11) · Xem trước

Phần 5. Thứ tự chỉ mục ghép

  • Bài 21: Điều kiện bằng trước, điều kiện phạm vi sau (3:54)

  • Bài 22 Đọc các cột được sử dụng trong key_len (4:01)

  • Bài 23 Khi không có cột dẫn đầu: skip scan (4:24)

  • Bài 24: 4 thí nghiệm về thứ tự (4:23)

  • Bài 25: Trường hợp thêm chỉ mục nhưng lại chậm hơn (5:05)

Phần 6. Chỉ mục bao phủ và sắp xếp

  • Bài 26 Ý nghĩa của Using index (4:19)

  • Bài 27: Loại bỏ bước đọc lại bằng chỉ mục bao phủ (4:22)

  • Bài 28: ORDER BY và filesort (4:12)

  • Bài 29: Khi thứ tự sắp xếp bị trộn lẫn (4:04)

  • Bài 30: Trường hợp OFFSET địa ngục và phân trang theo keyset (4:53)

Phần 7. GROUP BY·tổng hợp·LIMIT

  • Bài 31: Vì sao xuất hiện Using temporary (4:05)

  • Bài 32: Nhóm bằng chỉ mục (3:46)

  • Bài 33 Chi phí của COUNT(*) (4:20)

  • Bài 34: Khi LIMIT kết thúc sớm (4:05)

  • Bài 35: Tổng hợp dữ liệu trên dashboard chậm quá (4:49)

Mục 8. Kế hoạch thực thi phép JOIN

  • Bài 36: Bảng dẫn và vòng lặp lồng nhau (4:37)

  • Bài 37 Có hay không có chỉ mục ở cột dùng để JOIN (4:23)

  • Bài 38: Điều kiện xuất hiện hash join (4:58)

  • Bài 39. Thứ tự join và STRAIGHT_JOIN (4:40)

  • Bài 40. Trường hợp: JOIN ba bảng 1.26 giây (4:55)

Phần 9. Truy vấn con · IN · EXISTS

  • Bài 41: Subquery IN và semijoin (4:42)

  • Bài 42 So sánh IN, EXISTS và JOIN (4:26)

  • Bài 43 Bảng dẫn xuất: hợp nhất và cụ thể hóa (4:31)

  • Bài 44 Truy vấn con tương quan và vòng lặp (4:35)

  • Bài 45: Đơn hàng gần nhất của từng thành viên (4:53)

Phần 10. Chọn và chứng minh truy vấn chậm

  • Bài 46 Chọn truy vấn cấp cao (4:22)

  • Bài 47: Tổng thời gian so với thời gian mỗi lần (4:10)

  • Bài 48: Xác minh kết quả giống hệt nhau (4:06)

  • Bài 49: Chi phí khi thêm chỉ mục (3:55)

  • Bài 50: Chỉ mục vô hình và gợi ý (4:16)

Mục 11. Thực hành tổng hợp

  • Bài 51: Chẩn đoán slow log khi lần đầu nhìn thấy (4:01)

  • Bài 52 Trường hợp A: Màn hình tìm kiếm thành viên (4:02)

  • Bài 53. Tình huống B: Tác vụ đối soát (4:27)

  • Bài 54: Trường hợp C: Danh sách đơn hàng dành cho quản trị viên (4:18)

  • Bài 55: Danh sách kiểm tra đánh giá và nội dung học tiếp theo (3:57)


Giới thiệu giảng viên

Tôi là Joo Kyung-ho, đã có hơn 20 năm kinh nghiệm trong lĩnh vực cơ sở dữ liệu và CNTT. Với vai trò DBA và quản lý nhóm DB Platform, tôi phụ trách nền tảng cơ sở dữ liệu và chuyên về MySQL, PostgreSQL, Oracle, MongoDB, tối ưu hóa SQL, AWS, Terraform và Python.

Tôi đã chẩn đoán các truy vấn chậm hằng ngày trong nhóm nền tảng cơ sở dữ liệu và hướng dẫn nhóm phát triển cách tối ưu hóa. Trong khóa học này, tôi đã xây dựng lại quy trình chẩn đoán đó để các nhà phát triển có thể tự làm theo, chỉ với dữ liệu của một cửa hàng trực tuyến ảo dùng cho mục đích đào tạo và kết quả thực thi thực tế. Chúng tôi không sử dụng dữ liệu vận hành của công ty.

Câu hỏi thường gặp

Q. Tôi mới sử dụng MySQL thì có thể tham gia khóa học không?
A. Chỉ cần bạn có thể đọc SELECT·JOIN·GROUP BY. Phần kế hoạch thực thi sẽ được giải thích từ đầu.

Q. Chuẩn bị môi trường thực hành như thế nào?
A. Cài đặt Docker Desktop rồi chạy docker compose up -d trong thư mục lab của tệp ZIP bài thực hành. MySQL 8.0 và dữ liệu cửa hàng trực tuyến mô phỏng sẽ được tạo trong vòng 1~3 phút.

Q. Các con số trên màn hình bài giảng khác với kết quả của tôi.
A. Thời gian (ms·giây) sẽ khác nhau tùy máy tính. Hãy so sánh số hàng (rows, Rows_examined, Handler_read_*), hình dạng kế hoạch thực thi và mối tương quan trước sau. Giá trị ước tính của thống kê optimizer cũng có thể chênh lệch đôi chút.

Q. Có thể áp dụng nguyên như vậy cho Aurora MySQL và RDS không?
A. Nguyên tắc đọc kế hoạch thực thi và thiết kế chỉ mục là như nhau. Các bài thực hành trong khóa học được đo trên MySQL 8.0.46 cài đặt cục bộ.

Q. Có chạy được trên Windows không?
A. Nếu Docker Desktop hoạt động, bạn có thể chạy bằng cùng lệnh. Khóa học được kiểm chứng trên macOS, còn Windows thì chưa được kiểm chứng trực tiếp.

Q. Khóa/deadlock cũng được đề cập chứ?
A. Khóa học này tập trung vào kế hoạch thực thi, chỉ mục và truy vấn chậm. Khóa/deadlock là chủ đề của một khóa học riêng.

Q. Giọng thuyết minh có phải là giọng người không?
A. Đây là giọng tổng hợp bằng AI. Các câu lệnh SQL, kết quả thực thi và kế hoạch thực thi trên màn hình là đầu ra được chạy thực tế trên cơ sở dữ liệu thực hành.

Lời thuyết minh trong video là giọng nói tổng hợp bằng AI. Kết quả SQL và kế hoạch thực thi trên màn hình là đầu ra được thực thi thực tế trên DB thực hành.

Khuyến nghị cho
những người này

Khóa học này dành cho ai?

  • Lập trình viên backend biết viết truy vấn nhưng chưa từng đọc kế hoạch thực thi.

  • Lập trình viên junior lần đầu đảm nhận việc xử lý các truy vấn chậm.

  • Dành cho những người đang ôn thi SQLD hoặc muốn bắt đầu tối ưu hóa trong thực tế sau khi lấy chứng chỉ.

Cần biết trước khi bắt đầu?

  • Có thể đọc và viết SELECT·WHERE·JOIN·GROUP BY.

  • Cài đặt Docker Desktop và các lệnh cơ bản trong terminal

Xin chào
Đây là dorian05202988

Xác minh sự nghiệp

Tôi là một chuyên gia dữ liệu với hơn 20 năm kinh nghiệm trong lĩnh vực cơ sở dữ liệu và CNTT. Trong vai trò DBA và quản lý nhóm Nền tảng Cơ sở dữ liệu, tôi phụ trách các nền tảng cơ sở dữ liệu, với chuyên môn về MySQL, PostgreSQL, Oracle, MongoDB, tinh chỉnh SQL, AWS, Terraform và Python. Dựa trên kinh nghiệm trong các lĩnh vực trò chơi, tài chính và dịch vụ CNTT, tôi trình bày về cơ sở dữ liệu và kiến trúc đám mây. Tôi đã xuất bản 『Học các mẫu SQL tinh chỉnh thực tế Oracle』 và 『Sổ tay ứng dụng dự án thực tế Oracle Pro*C』, đồng thời thuyết trình về serverless, lựa chọn cơ sở dữ liệu và chiến lược đa cơ sở dữ liệu tại AWS Summit 2018·2019 và sự kiện 데이터야 놀자 2020. Gần đây, tôi tập trung vào phân tích và khuyến nghị tinh chỉnh truy vấn chậm bằng Bedrock LLM, tự động hóa việc tính toán thông số DB, cũng như quy trình tra cứu thông qua máy chủ DB Meta MCP và bot Slack. Tôi giải thích về tự động hóa cơ sở dữ liệu dành cho nhà phát triển và việc ứng dụng AI vào công việc dành cho người không chuyên về phát triển thông qua các bài thực hành phù hợp với đối tượng và mục tiêu của từng khóa học. Thay vì áp dụng nguyên xi các đề xuất của AI, tôi truyền đạt các tiêu chí đánh giá như kiểm tra tính tương đương của kết quả, kế hoạch thực thi và điều kiện quan sát; nếu thiếu căn cứ thì tạm thời chưa áp dụng. Dữ liệu vận hành của công ty và thông tin xác thực không được đưa vào tài liệu giảng dạy.

Thêm

Chương trình giảng dạy

Tất cả

55 bài giảng ∙ (3giờ 56phút)

Tài liệu khóa học:

Tài liệu bài giảng
Ngày đăng: 
Cập nhật lần cuối: 

Đánh giá

Chưa có đủ đánh giá.
Hãy trở thành tác giả của một đánh giá giúp mọi người!

Khóa học khác của dorian05202988

Hãy khám phá các khóa học khác của giảng viên!

Khóa học tương tự

Khám phá các khóa học khác trong cùng lĩnh vực!

Ưu đãi có thời hạn

79.200 ₫

20%

2.036.879 ₫