inflearn logo

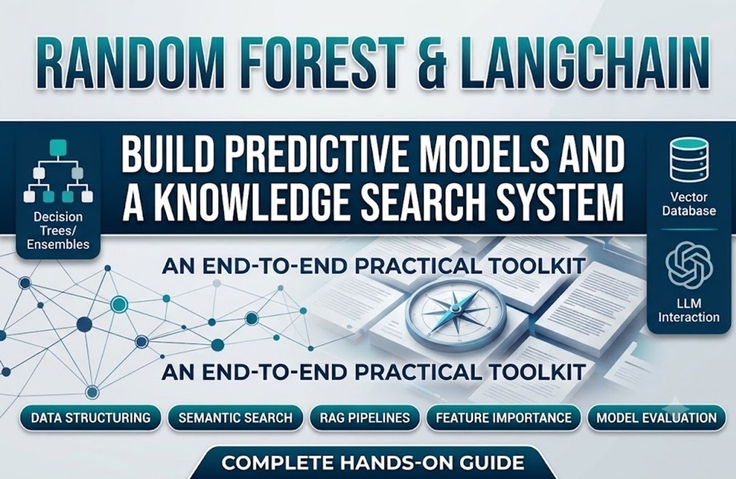
Từ Random Forest đến hệ thống tìm kiếm tri thức LangChain: Phân tích dữ liệu và ứng dụng thực tiễn LLM

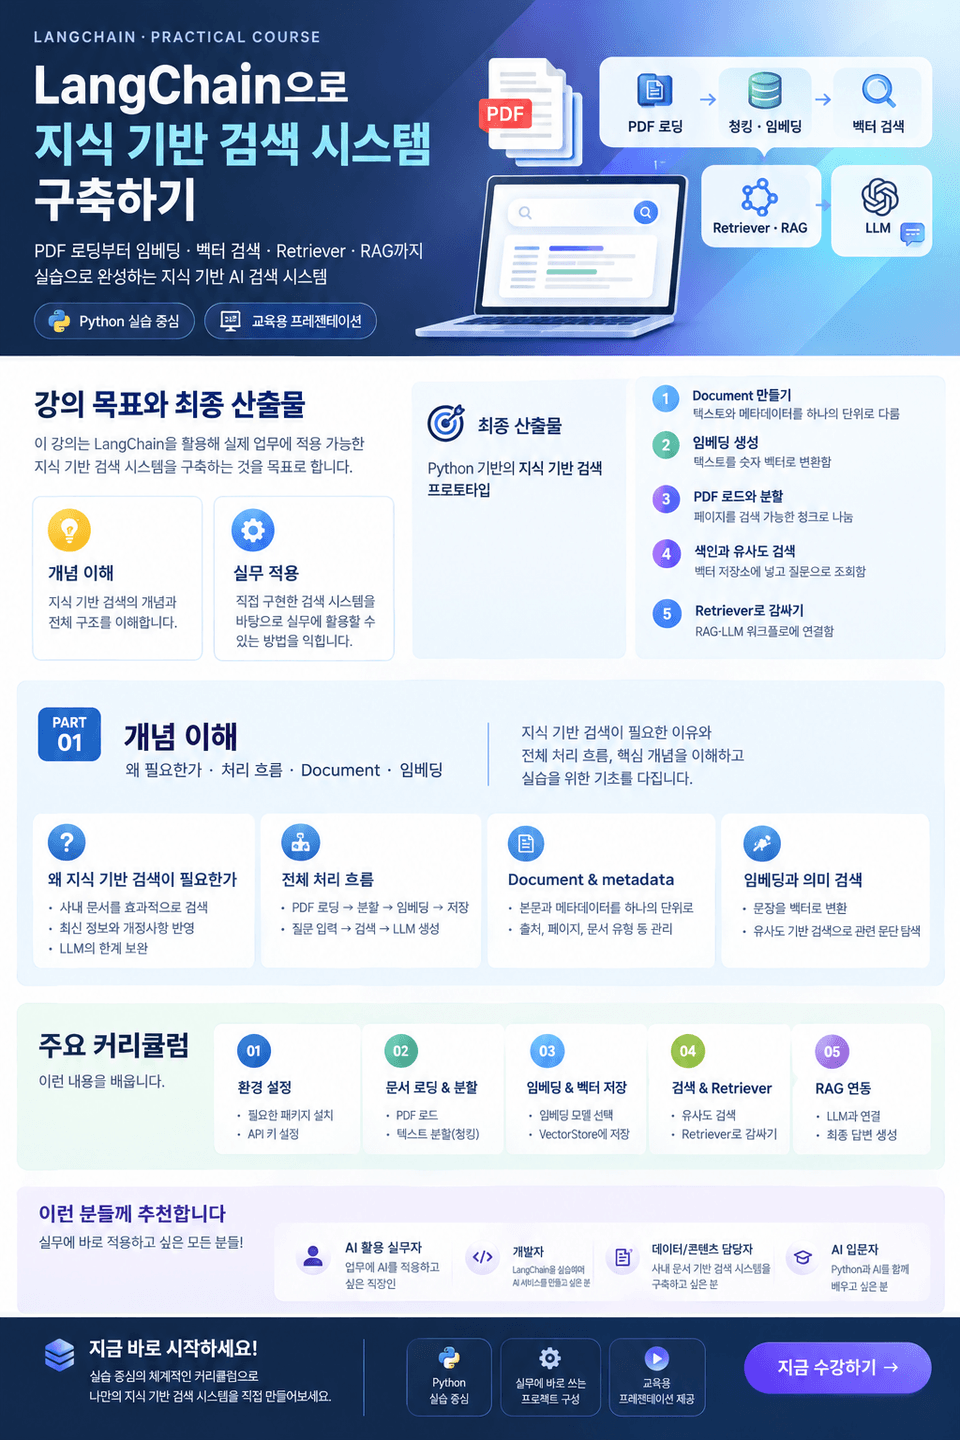
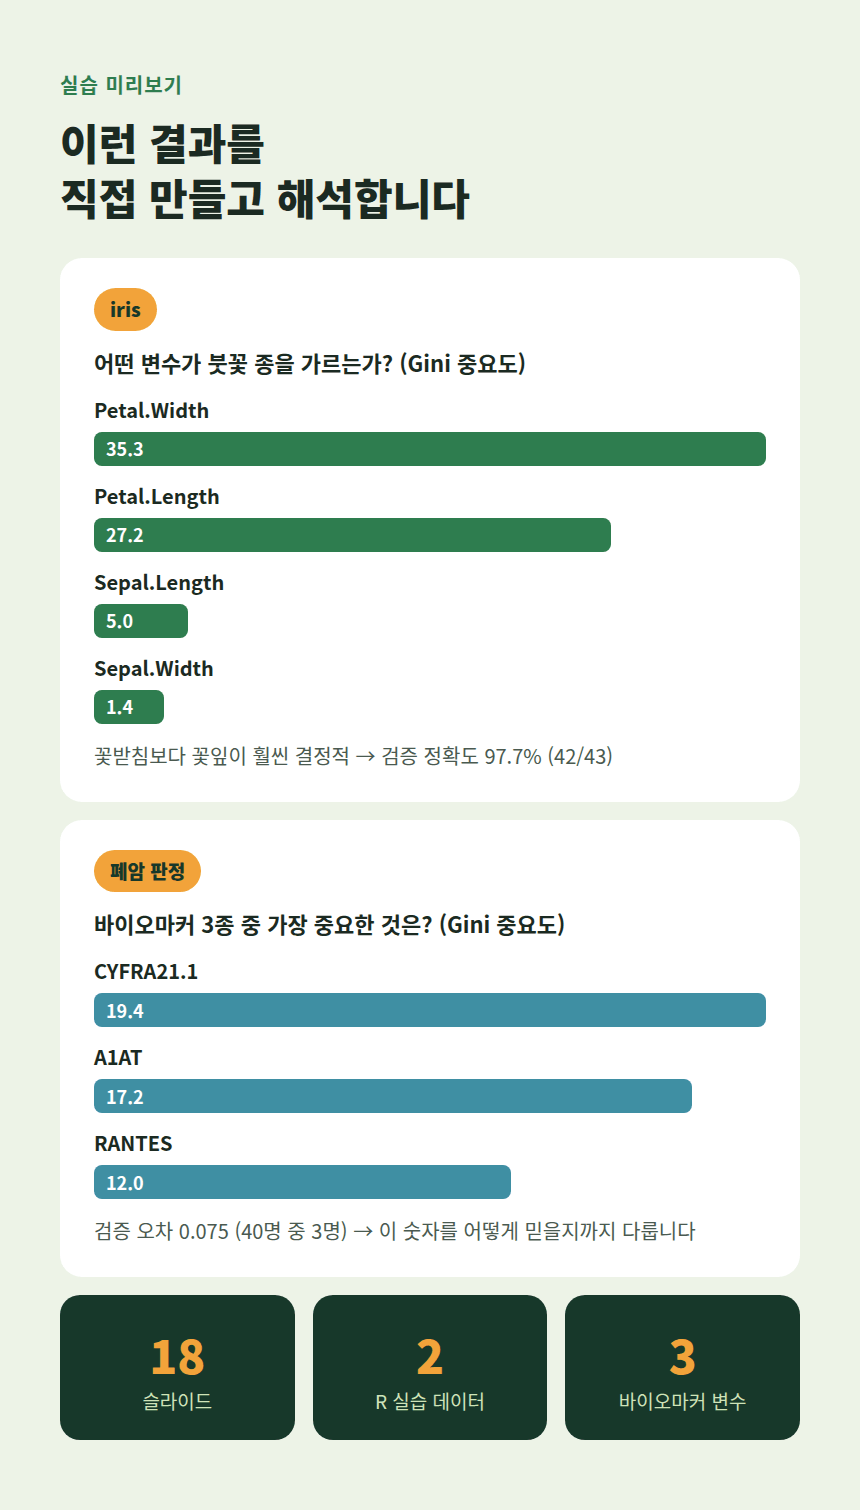
Phần I Thực hành bằng mã nguồn quy trình tải PDF dưới dạng Document theo từng trang, chia nhỏ, vector hóa bằng embedding và lập chỉ mục trong kho lưu trữ vector. Tìm hiểu cấu trúc chuyển câu hỏi thành vector để tìm kiếm độ tương đồng (bao gồm điểm số, vector và MMR), sau đó bọc lại thành Retriever (Runnable) để kết nối với RAG. Tổng hợp các tiêu chí áp dụng thực tế thông qua việc kiểm tra chất lượng tìm kiếm, bảo mật và quản trị (bao gồm prompt injection), cũng như các lỗi thường gặp. Phần II Triển khai bằng R thuật toán Random Forest, vốn khắc phục những hạn chế của cây quyết định, đồng thời học cách diễn giải chính xác kết quả mô hình. Sử dụng dữ liệu hoa iris và dữ liệu biomarker thực tế để rèn luyện khả năng đọc và giải thích các chỉ số cốt lõi như lỗi OOB, độ quan trọng của biến và ma trận nhầm lẫn. Hoàn thiện quy trình làm việc có thể áp dụng ngay vào thực tế, bao gồm tinh chỉnh siêu tham số, kiểm định chéo và phân tích đường cong ROC.

1 học viên đang tham gia khóa học này

Độ khó Cơ bản

Thời gian 3 tháng

Python
Python
R
R
vector-database
vector-database
AI
AI
figma variable
figma variable
Python
Python
R
R
vector-database
vector-database
AI
AI
figma variable
figma variable

Bạn sẽ nhận được điều này sau khi học.

  • Đánh giá độ tin cậy của mô hình và xác định các biến chính bằng cách diễn giải sai số OOB và chỉ số tầm quan trọng của biến

  • Tối ưu hóa mô hình thông qua việc tinh chỉnh các siêu tham số ntree và mtry, đồng thời so sánh hiệu suất dựa trên đường cong ROC

  • Xử lý đơn vị dữ liệu: Cách sử dụng đối tượng Document để cấu trúc văn bản và siêu dữ liệu (nguồn, trang, v.v.)

  • Chia tài liệu dài thành các đoạn có kích thước phù hợp, rồi chuyển đổi câu thành vector số thông qua các mô hình embedding như OpenAI

  • Tìm kiếm vector và Retriever: Từ việc lập chỉ mục kho lưu trữ vector (Vector Store) đến tìm kiếm độ tương đồng/MMR thông qua Retriever

  • Kiến trúc đầu cuối (End-to-End) hoàn chỉnh kết nối với quy trình LLM (RAG)

  • Một nguyên mẫu tìm kiếm có thể xác định chính xác đoạn văn gần nhất với câu hỏi trong các tài liệu PDF thực tế như quy định của công ty hoặc sổ tay, thay vì chỉ dựa vào bộ nhớ của LLM.

  • Quản lý hiện tượng ảo giác (Hallucination) và bảo toàn nguồn: Duy trì không chỉ nội dung nguyên văn của đoạn văn được tìm kiếm mà còn cả siêu dữ liệu như tên tệp nguồn, số trang, vị trí ký tự (start_index).

Phần I

  • LangChain, cách tận dụng kết quả tìm kiếm quan trọng hơn việc kết nối: tải PDF · embedding · tìm kiếm vector · RAG

  • Học hệ thống tìm kiếm dựa trên tri thức với LangChain: từ nguyên lý, thực hành Python đến diễn giải kết quả tìm kiếm

  • Hệ thống tìm kiếm AI tìm kiếm bằng chứng trong tài liệu (từ PDF đến Retriever·RAG)

  • Hoàn thiện hệ thống tìm kiếm LangChain: Tài liệu · chia đoạn · embedding · tìm kiếm vector · Retriever · RAG

Phần II

  • Random Forest, cách đọc kết quả quan trọng hơn việc chạy mô hình: Hoàn thiện phân loại, độ quan trọng của biến và tinh chỉnh bằng R

  • Học Random Forest bằng R: từ nguyên lý đến thực hành chẩn đoán ung thư phổi và diễn giải kết quả

  • Đọc câu chuyện đằng sau những con số với Random Forest (từ iris đến biomarker)

  • Hoàn thiện Random Forest: nguyên lý · thực hành R · OOB · độ quan trọng của biến · tinh chỉnh

Khuyến nghị cho
những người này

Khóa học này dành cho ai?

  • Người mới bắt đầu phân tích dữ liệu đã chạy mã học máy nhưng không hiểu ý nghĩa của kết quả đầu ra

  • Nhà nghiên cứu thống kê sinh học muốn nâng cao khả năng xây dựng và diễn giải mô hình phân loại bằng R

  • Người học khoa học dữ liệu muốn học một cách có hệ thống về lý thuyết và phương pháp ứng dụng thực tiễn của Random Forest.

  • Liên kết vô số tài liệu quy định hoặc hướng dẫn sử dụng PDF đang được lưu trữ trong nội bộ công ty với LLM.

  • Tôi muốn tìm hiểu luồng hoạt động của toàn bộ kiến trúc, từ cấu trúc đối tượng Document, việc chia nhỏ văn bản (RecursiveCharacterTextSplitter), nguyên lý embedding (Embedding), lập chỉ mục trong kho lưu trữ vector (Vector Store), cho đến Retriever và RAG, thay vì chỉ đơn thuần gọi API.

Cần biết trước khi bắt đầu?

  • Kinh nghiệm về cú pháp lập trình R cơ bản và thao tác với data frame

  • Hiểu các khái niệm cơ bản của thuật toán Cây quyết định (Decision Tree)

  • Kiến thức cơ bản về bài toán phân loại và ma trận nhầm lẫn (Confusion Matrix)

  • Các phương pháp thao tác cơ bản để xử lý dữ liệu như chuỗi văn bản (String), danh sách (List), từ điển (Dictionary) etc.

  • Kinh nghiệm di chuyển thư mục (cd) và thực thi các lệnh cơ bản trong môi trường Command Prompt (CMD), PowerShell hoặc Terminal

  • Kinh nghiệm tạo môi trường ảo và thử cài đặt các thư viện cần thiết bằng pip, công cụ quản lý gói.

Xin chào
Đây là aha30005480

Xác minh sự nghiệp

Giảng viên chuyên môn về phân tích dữ liệu · AI

  • Đã giảng dạy nhiều khóa đào tạo về phân tích dữ liệu và thống kê cho các doanh nghiệp và cơ quan công.

  • Giảng viên toàn thời gian khóa học Big Data·AI tại Học viện Đào tạo Chuyên môn Nghề nghiệp

  • Chuyên gia thực tiễn và đào tạo trong lĩnh vực phân tích dữ liệu, thống kê và điều tra xã hội

  • Giảng dạy thực hành phân tích dữ liệu và thống kê dựa trên SPSS, R, Python

  • Tổ chức các khóa học chuẩn bị cho chứng chỉ Phân tích viên điều tra xã hội và Kỹ thuật viên phân tích dữ liệu lớn

  • Sách đã xuất bản: Bộ sách Khoa học dữ liệu Step1~4, Xây dựng dữ liệu lớn phục vụ phân tích AI (dữ liệu tiếng Hàn có cấu trúc và phi cấu trúc), Chứng chỉ Phân tích điều tra xã hội cấp 2 – phần thi viết & thực hành (dạng trả lời tự luận), Công cụ phân tích dữ liệu R Fundamental

Thêm
Ngày đăng: 
Cập nhật lần cuối: 

Đánh giá

Chưa có đủ đánh giá.
Hãy trở thành tác giả của một đánh giá giúp mọi người!

Khóa học khác của aha30005480

Hãy khám phá các khóa học khác của giảng viên!

Khóa học tương tự

Khám phá các khóa học khác trong cùng lĩnh vực!

Ưu đãi có thời hạn

58.559 ₫

50%

117.118 ₫