


넷플릭스 크롤링
833
작성한 질문수 7
넷플릭스 크롤링 시스템 만들 때 섹션별로 영화 제목 따내는 거는 아무 오류 없었는데 섹션리스트 중에서 첫번째 섹션에서 프li태그 이용해서 프로그램 이미지랑 제목 html로 따낼 때
section_list = soup.select('section')
section = section_list[1]
program_list = section.select('li')
for program in program_list:
print(program.txt)
이렇게 했더니 결과가 None으로 여러개가 계속 나와요 뭐가 문제일까요??
답변 2
1
너무 늦은 시간인데 빠른 답변 감사합니다!! 고3인데 학교에서 한 활동 중 웹 크롤링으로 한 활동이 있었는데 기억이 잘 안나서 공부를 어떻게 다시해야될지 찾고있었는데 이 강의를 발견하고 나서 너무 든든하고 이해도 잘하고 있습니다!! 끝까지 완강하고 후기 더 남기겠습니다. 질문 생기면 또 할게요!!
0
안녕하세요.
마지막 print 명령어에서
program.txt 로 되어있는 부분을
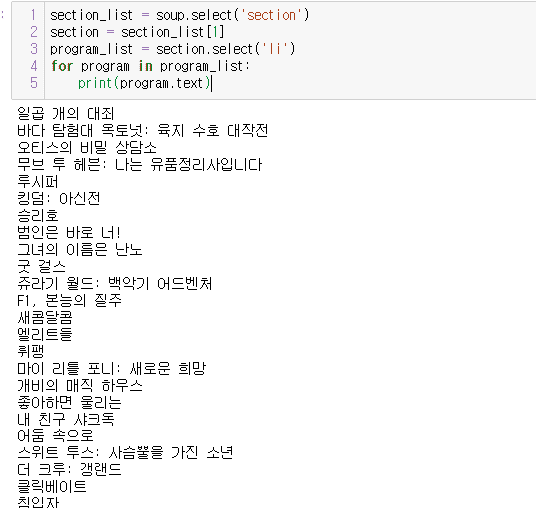
program.text
으로 변경하시면 될 것 같네요.
[기존]
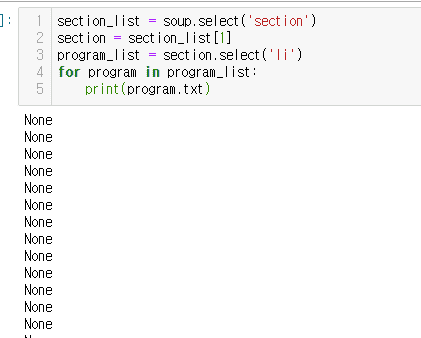
[변경후 : txt → text ]
12회 작1 2-1
0
10
1
일주일 전 학습방향
0
15
2
roc 코드 질문입니다
0
14
2
섹션12 강의
0
14
1
모의문제3 질문
0
15
2
116. [작업형3] 9. 로지스틱 회귀 문제 질문 있습니다
0
11
2
레이블인코딩 transform 질문
0
19
2
3회 작업형2
0
13
2
문제2
0
13
2
작업형 2 결측치파트
0
19
2
모델 학습 추가 코드
0
20
1
10회 작업형3 1-2
0
21
1
분리
0
22
2
unique
0
20
2
기출7회 작업형 2 회귀 모델
0
17
2
test 데이터 결측치 관련 질의
0
16
2
전체질문) 시험대비 관련 질문
0
28
2
간단한 질문 있습니다
0
26
2
로지스틱 회귀분석, 분산분석 범주형 변수 관련 외 질문
0
27
2
수업노트에서 프로그램을 따라할 경우 일부 단어만 입력해도 전문이 뜨는데요
0
19
1
[캐글] 작업형3 예상 문제 - 잔차이탈도
0
30
2
크롤링 페이지 접속 에러
0
592
1
넷플릭스 크롤링 데이터 엑셀파일저장
0
696
1
유튜브 크롤링 방법
0
444
1