


넷플릭스 크롤링
803
작성한 질문수 7
넷플릭스 크롤링 시스템 만들 때 섹션별로 영화 제목 따내는 거는 아무 오류 없었는데 섹션리스트 중에서 첫번째 섹션에서 프li태그 이용해서 프로그램 이미지랑 제목 html로 따낼 때
section_list = soup.select('section')
section = section_list[1]
program_list = section.select('li')
for program in program_list:
print(program.txt)
이렇게 했더니 결과가 None으로 여러개가 계속 나와요 뭐가 문제일까요??
답변 2
1
너무 늦은 시간인데 빠른 답변 감사합니다!! 고3인데 학교에서 한 활동 중 웹 크롤링으로 한 활동이 있었는데 기억이 잘 안나서 공부를 어떻게 다시해야될지 찾고있었는데 이 강의를 발견하고 나서 너무 든든하고 이해도 잘하고 있습니다!! 끝까지 완강하고 후기 더 남기겠습니다. 질문 생기면 또 할게요!!
0
안녕하세요.
마지막 print 명령어에서
program.txt 로 되어있는 부분을
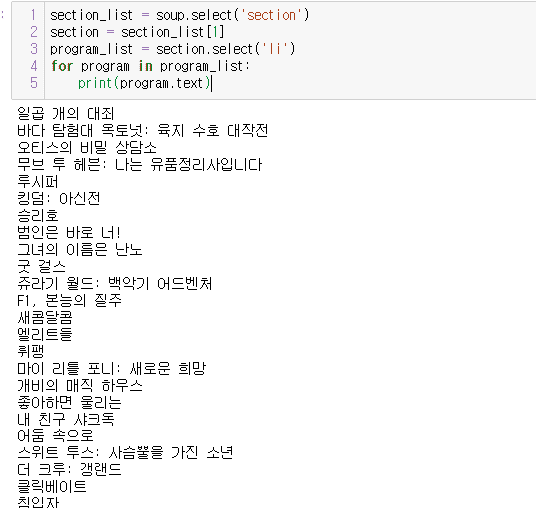
program.text
으로 변경하시면 될 것 같네요.
[기존]
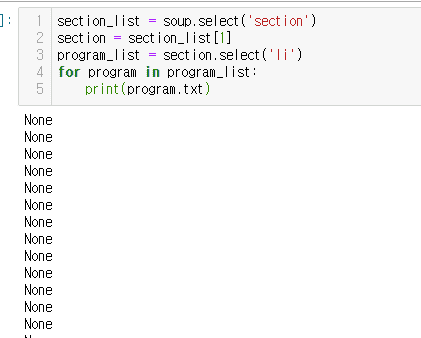
[변경후 : txt → text ]
강의일시정지 요청합니다
0
22
1
화면 아래쪽에 노트가 어디 있나요
0
18
2
기출문제 재탕
0
22
1
뻬먹은 코드
0
18
0
기출문제 재탕
0
16
0
모의고사1회 2번문제 뭔지 모르겠네요 강의올려주시면안될까요?
0
15
0
creatomate API 인증 문제인거 같은데
0
15
2
강의 연장 가능할까요 ㅠㅠ
0
33
1
수강 연장 문의드립니다.
0
29
1
TTS 결과 오류
0
22
2
노드 주제생성 노드는 어떻게 연결해야하는지 모르겠습니다 ;;
0
19
2
제가 한 노드 연결이 맞는걸까요?
0
33
2
예제 파일 다운로드는 어디서 하나요?
1
32
2
응시권 신청했는데 아직 안들어오고있습니다.
0
43
1
4강 카드뉴스 자동화 자료가 안보입니다!!
0
52
2
영상을 이어 붙이는 방법을 알고 싶어요.
0
37
1
수강기간 연장 가능 여부 문의드립니다.
0
63
1
4강 카드뉴스 자동화 자료
4
81
1
라이브 강의 영상 녹화본이 있을까요?
0
79
1
.env
0
64
4
인증이 늦었습니다ㅜㅜ 확인부탁드립니다
0
76
1
크롤링 페이지 접속 에러
0
559
1
넷플릭스 크롤링 데이터 엑셀파일저장
0
673
1
유튜브 크롤링 방법
0
417
1