


캡쳐본 올려봅니다.
17
작성한 질문수 5
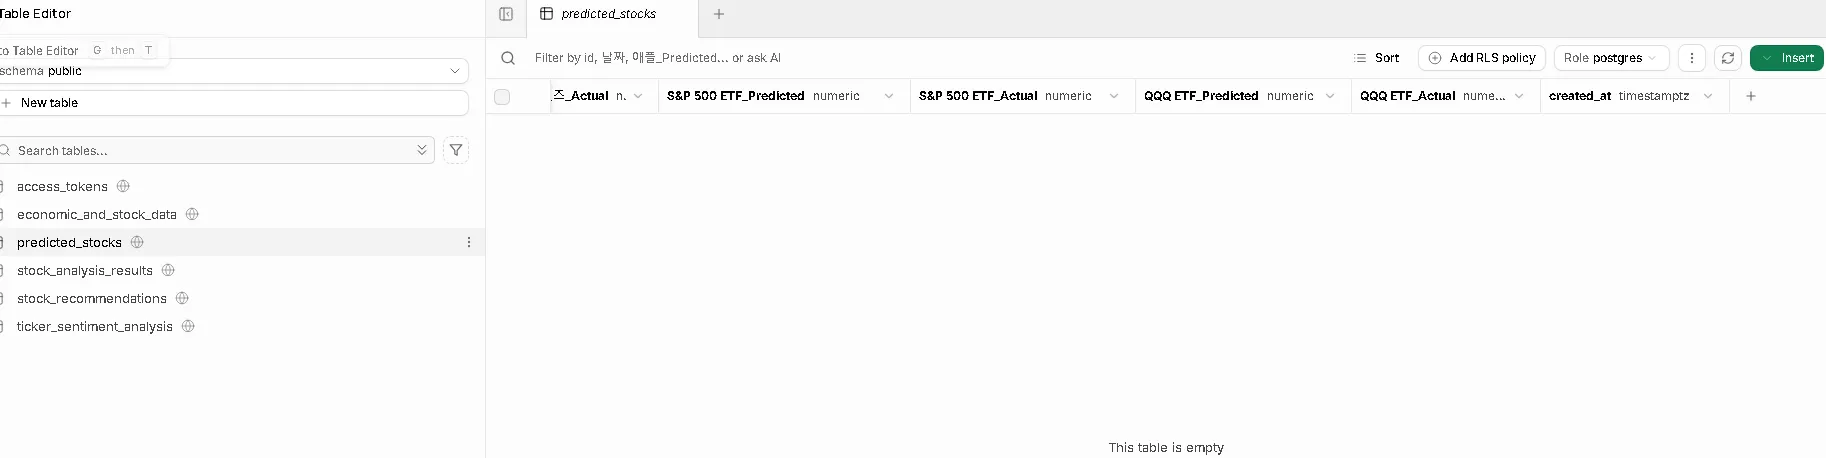
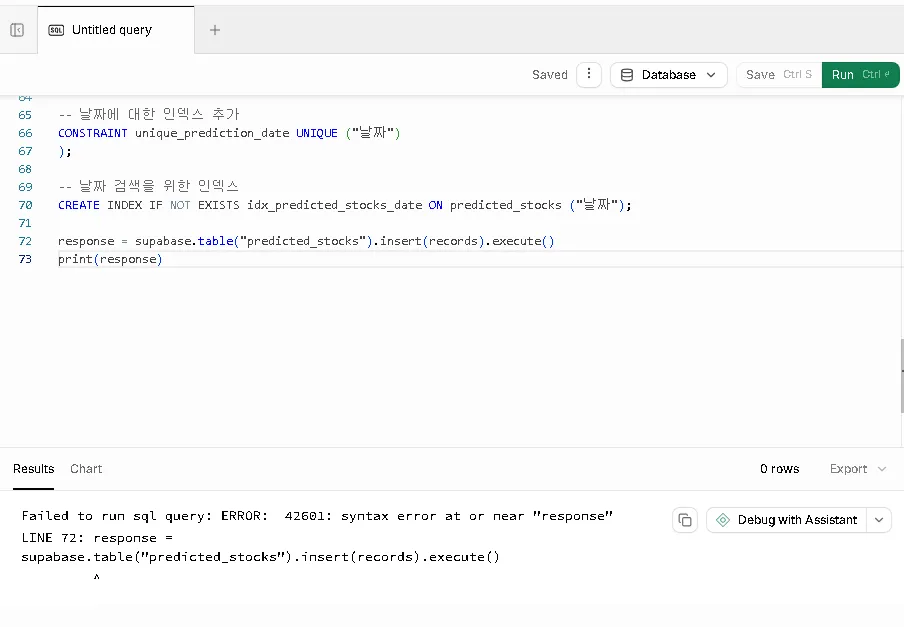
위에 첫번째 이미지는 선생님이 입력하라고 한 코드 없이 그냥 코드 복붙 했을 때 테이블 생성 상태를 캡쳐한것입니다.
RLS disable로 해도 안 되는거 같아요
경제 지표랑 지수 supabase에 올리는 과정에서 뭔가 삐걱 된걸 cursor ai 를 통해서 해결이 되었거든요. 거기서부터 문제가 생긴건지..
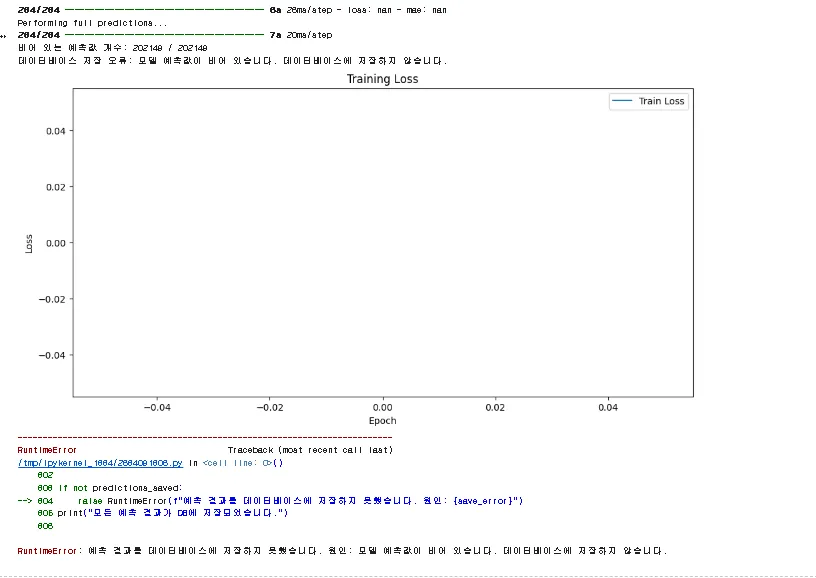
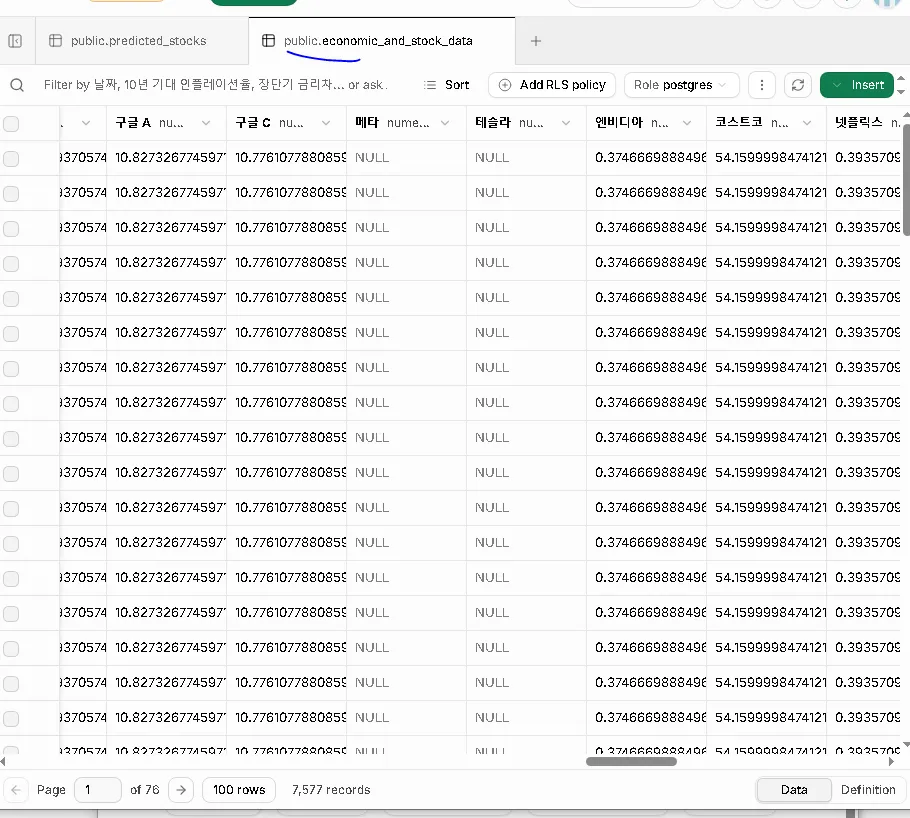
economic_and_stock_data에서 NULL 값 때문에 ai가 처리를 못하는 건지.. 뭐가 문제일까요
답변 1
0
안녕하세요, 인프런 AI 인턴입니다.
jkl님, 첨부해 주신 내용을 보면 NULL 문제보다는 SQL 편집기에서 Python 코드를 실행한 것과 predicted_stocks 테이블의 컬럼 구조와 Python의 records 구조가 일치하지 않을 가능성이 더 커 보입니다.
1. SQL 편집기에서는 Python 코드를 실행할 수 없습니다
두 번째 이미지의 오류 원인은 다음 코드입니다.
response = supabase.table("predicted_stocks").insert(records).execute()
print(response)
이 코드는 SQL이 아니라 Python 코드이므로 Supabase의 SQL Editor에 입력하면 안 됩니다.
SQL Editor에서는 다음과 같이 SQL만 실행해야 합니다.
select *
from public.predicted_stocks
limit 10;
Python 코드는 Jupyter Notebook, Python 파일, Cursor의 Python 실행 환경 등에서 실행해야 합니다.
response = supabase.table("predicted_stocks").insert(records).execute()
print(response)
참고 이미지:
2. predicted_stocks 테이블이 비어 있는 것은 테이블 생성 실패와 다릅니다
첫 번째 이미지의 This table is empty는 테이블 자체는 생성되었지만 아직 데이터가 한 건도 삽입되지 않았다는 의미입니다.
즉, 현재 상황은 다음과 같을 수 있습니다.
predicted_stocks테이블 생성은 성공함
- 모델 학습도 어느 정도 진행됨
- 예측 결과를 테이블에 삽입하는 단계에서 실패함
- 저장된 데이터가 없어서 마지막 검증 단계에서
RuntimeError발생
참고 이미지:
3. 테이블 컬럼명과 records의 키를 확인해야 합니다
이미지상 predicted_stocks 테이블에는 S&P 500 ETF, QQQ ETF 관련 컬럼이 보이는 반면, Python 코드에서는 "날짜" 컬럼과 한국어 컬럼명을 사용하는 것으로 보입니다.
따라서 실제 테이블 컬럼명과 records의 키가 정확히 일치하는지 확인해 주세요.
먼저 SQL Editor에서 컬럼 목록을 확인합니다.
select
    column_name,
    data_type,
    is_nullable
from information_schema.columns
where table_schema = 'public'
  and table_name = 'predicted_stocks'
order by ordinal_position;
Python에서는 삽입 직전에 다음을 출력해 보세요.
print(records[:2])
print(records[0].keys() if records else "records가 비어 있습니다.")
예를 들어 테이블에 다음 컬럼이 실제로 존재한다면:
날짜
sp500_predicted
sp500_actual
qqq_predicted
qqq_actual
created_at
records도 다음과 같은 형태여야 합니다.
records = [
    {
        "날짜": "2024-01-01",
        "sp500_predicted": 480.12,
        "sp500_actual": 478.50,
        "qqq_predicted": 410.20,
        "qqq_actual": 408.10
    }
]
컬럼명이 sp500_predicted인데 Python에서 predicted_sp500으로 보내거나, "날짜" 대신 "date"를 보내면 삽입이 실패할 수 있습니다.
4. Supabase 삽입 오류를 반드시 출력해 보세요
현재 코드만으로는 정확한 Supabase 오류 내용이 확인되지 않을 수 있으므로 다음과 같이 예외를 출력해 보세요.
try:
    print("records 개수:", len(records))
    print("첫 번째 데이터:", records[0] if records else None)

    response = (
        supabase
        .table("predicted_stocks")
        .insert(records)
        .execute()
    )

    print("삽입 결과:", response.data)

except Exception as e:
    print("삽입 오류:", repr(e))
특히 다음과 같은 오류가 나오는지 확인해야 합니다.
column does not exist
null value in column violates not-null constraint
invalid input syntax
duplicate key value violates unique constraint
new row violates row-level security policy
permission denied
5. RLS를 꺼도 해결되지 않는 경우
RLS를 비활성화했는데도 실패한다면 RLS 외의 문제일 가능성이 큽니다.
대표적으로 다음을 확인해 주세요.
records가 빈 리스트인지
- Python 키와 DB 컬럼명이 일치하는지
- 숫자 컬럼에 문자열이나
NaN이 들어가는지
- 날짜 형식이 올바른지
NOT NULL컬럼에None이 들어가는지
- 고유 제약 조건 때문에 중복 삽입되는지
- 테이블명이 정확히
predicted_stocks인지
- Supabase URL과 키가 올바른지
records가 빈 리스트라면 삽입할 데이터가 없으므로 먼저 확인해야 합니다.
if not records:
    raise ValueError("삽입할 예측 결과가 없습니다.")
6. NULL 값이 원인일 가능성
economic_and_stock_data에 NULL이 있다고 해서 자동으로 predicted_stocks 삽입이 실패하는 것은 아닙니다.
다만 학습 전처리 과정에서 NULL을 처리하지 않고 모델에 전달하면 다음과 같은 문제가 발생할 수 있습니다.
NaN관련 오류
- 모델 입력값 개수 불일치
- 학습 결과가
NaN
- 예측 결과가 비어 있음
- 예측 결과에 Python의
nan이 포함되어 JSON 변환 실패
먼저 NULL 개수를 컬럼별로 확인해 보세요.
select
    count(*) as total_rows,
    count(*) filter (where "날짜" is null) as null_date_count
from public.economic_and_stock_data;
특정 숫자 컬럼의 NULL을 확인하려면 다음처럼 실행할 수 있습니다.
select
    count(*) as total_rows,
    count(*) filter (where "테슬라" is null) as tesla_null_count,
    count(*) filter (where "엔비디아" is null) as nvidia_null_count
from public.economic_and_stock_data;
Python의 pandas에서는 다음과 같이 확인할 수 있습니다.
print(df.isna().sum())
print(df.isnull().sum().sum())
결측치를 처리한 뒤 모델에 전달해야 한다면 예를 들어 다음과 같이 처리할 수 있습니다.
df = df.replace([float("inf"), float("-inf")], None)
df = df.dropna()
단, dropna()는 결측치가 있는 행을 모두 제거하므로 데이터가 지나치게 줄어들 수 있습니다.
7. 예측 결과에 NaN이 포함되었는지도 확인해 주세요
Supabase에 삽입하기 전에 다음을 확인하는 것이 좋습니다.
import pandas as pd

result_df = pd.DataFrame(records)

print(result_df.shape)
print(result_df.isna().sum())
print(result_df.head())
records에 nan이 들어 있다면 DB에 넣기 전에 None으로 변환할 수 있습니다.
records = result_df.astype(object).where(
    pd.notna(result_df),
    None
).to_dict(orient="records")
다만 해당 컬럼이 NOT NULL로 설정되어 있으면 None으로 바꾼 뒤에도 삽입되지 않으므로, 그 경우에는 결측치를 제거하거나 적절한 값으로 대체해야 합니다.
현재 단계에서는 다음 순서로 확인하는 것이 가장 좋습니다.
- SQL Editor에서 Python 코드를 제거하기
predicted_stocks의 실제 컬럼 목록 확인하기
records의 개수와 키 출력하기
records의 값에NaN,None, 잘못된 날짜가 있는지 확인하기
try-except로 Supabase의 실제 오류 메시지 출력하기
- 그 오류 메시지에 따라 컬럼명, 제약 조건, RLS를 수정하기
특히 NULL 여부보다 먼저 print(repr(e))로 표시되는 실제 삽입 오류 메시지와 records[0]의 내용을 확인하면 원인을 훨씬 빠르게 찾을 수 있습니다.
조회 메서드에서 @Transactional(readOnly=true) 질문
1
43
1
enable_latch가 F/F이 아니라 래치인 이유가 궁금합니다.
1
51
2
3강 인덱스 구조 강의 자료 문의
1
62
1
초보자 공부 방법
1
39
1