


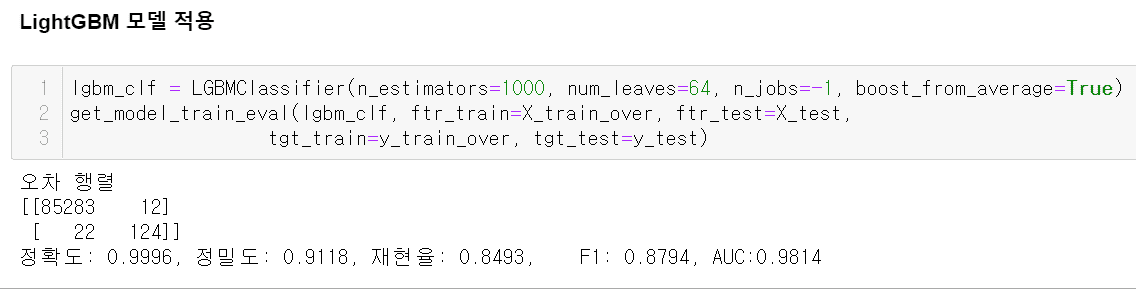
마지막 SMOTE 이후 LGBMClassifier 학습하고 평가할 때
326
작성한 질문수 104
선생님~
SMOTE 방식으로 오버샘플링을 한 이후로는서
학습데이터의 레이블 데이터 값 분포가 균일 해져서
boost_from_average=True로 하고 한번 해봤는데요~
(강의에서는 False로 그냥 진행되었었음)
재현율은 똑같고.. 정밀도는 조금 낮아졌지만,
ROC_AUC는 좀더 높아졌네요..
오버샘플링(혹은 언더샘플링)을 해서
학습데이터의 레이블데이터의 값분포를 균일하게 맞춰주게 되면
boost_from_average=True 로 하는 걸 더 권장하시나요~?
아니면 False로 하는 걸 더 권장하시나요..?
답변 1
시계열 분석 문의
0
42
1
LLM 시대에서 머신러닝 개념 이해 필요성 문의
0
70
1
후속 강의
0
70
1
강의 문의드립니다.
0
109
2
모델 서빙과 관련된 강좌가 출시되는지 질문드립니다.
0
113
2
안녕하세요 열심히 수강중인 학생입니다
0
161
2
정수 인덱싱
0
151
2
넘파이 오류
0
213
2
11강 numpy의 axis 축 질문 드립니다.
0
167
2
Kaggle 에서 Santander customer satisfaction data 를 다운로드 되지가 않습니다.
0
154
2
Feature importances 를 보여주는 barplot 이 그래프로 안보여져요.
0
152
2
타이타닉 csv 파일이 주피터 화면에 보이지 않습니다.
0
155
2
타이타닉 csv 파일이 주피터 화면에 보이지 않습니다.
0
137
2
5강 강의 오류가 있어요.
0
127
1
실무에서 LTV 관련 모델 선택 질문입니다!
0
129
2
14강 강의 듣는중에 궁금한게 있어서 질문합니다~
0
129
3
파이썬 다운그레이 후 사이킷런 재설치
0
196
2
좋은 강의 감사합니다.
0
128
2
scoring 함수 음수값
0
126
2
6번 강의에 사이킷런, 파이썬, 아나콘다 각각 버전 일치 안 시키고 진행해도 강의 따라가 지나요?
0
158
2
분류 평가 정확도 예측
0
150
2
안녕하세요. 강의 들으면서 업무에 적용하고 싶은 수강생입니다.
0
150
1
카카오톡 채널 있나요
0
154
1
혹시 강의에서 사용하시는 ppt 받을 수 있는건가요
0
239
2