[Việc riêng sau giờ tan làm] Kỳ thi thực hành chứng chỉ phân tích dữ liệu lớn (Dạng bài 1, 2, 3)
Chúng tôi hướng dẫn người không chuyên và người mới bắt đầu nhanh chóng đạt chứng chỉ thực hành Kỹ thuật viên Phân tích Dữ liệu Lớn! Phần lý thuyết được trình bày nhẹ nhàng, phần thực hành được học chắc chắn. Không cần kiến thức nền tảng phức tạp, bạn chỉ cần tập trung học những điểm chắc chắn xuất hiện trong kỳ thi, với trọng tâm là các đề thi trước đây.
6,075 học viên
Độ khó Nhập môn
Thời gian 12 tháng


Tin tức
97 bài viết
Phiếu giảm giá bổ sung đợt 2 cho “Trò chơi con mực Big Data” dành cho các học viên đã được phát hành.
Bạn có thể kiểm tra bằng cách nhấp vào liên kết [Nhóm học tập Big Data] trong buổi 13 của chương trình học.※ Do đặc thù của thử thách, sau khi bắt đầu sẽ khó tham gia thêm, vì vậy những ai muốn tham gia vui lòng đăng ký trước!
Cố lên nhé. Tôi ủng hộ bạn!
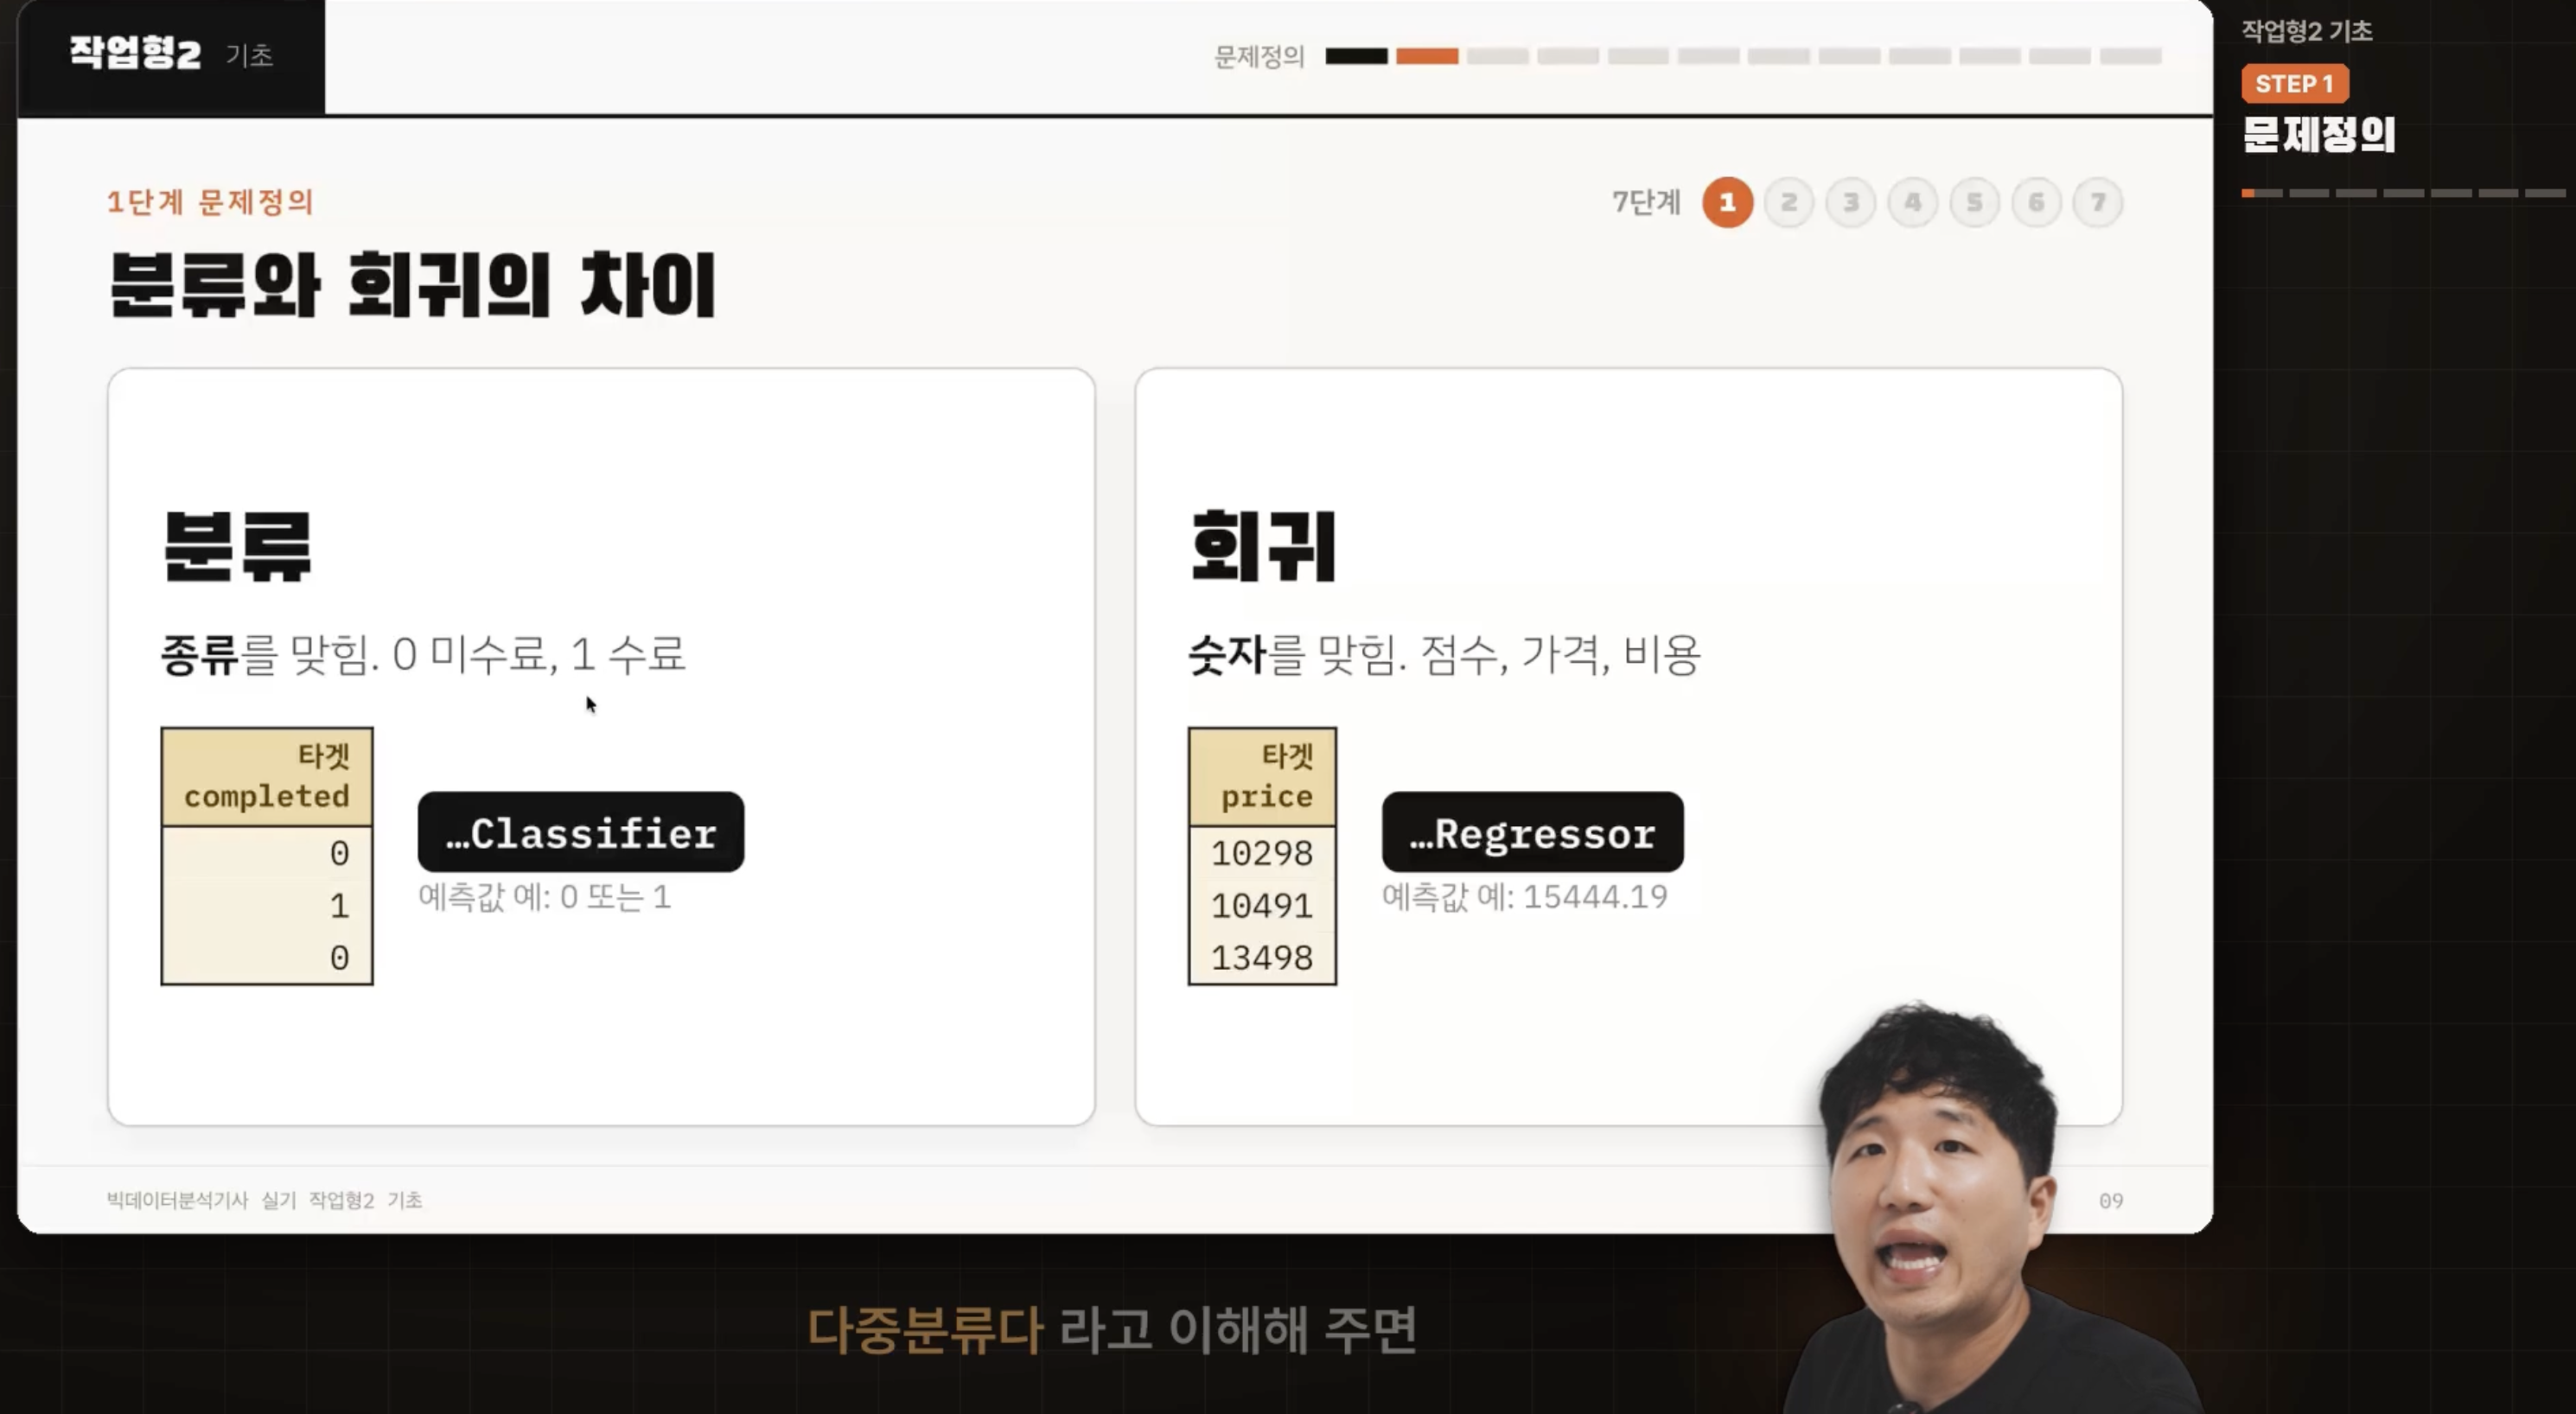
Đã cập nhật video Nền tảng học máy dạng bài 2 (nền tảng dạng bài 2).
Trước đây, để dễ hiểu, chúng tôi đã giải thích bằng cách ví von với các khối đồ chơi mà không sử dụng mã, nhưng…Có thể sẽ cảm thấy hơi đơn giản, vì vậy nội dung đã được biên soạn lại theo hướng tập trung vào quy trình học máy để bạn có thể sớm làm quen với môi trường thi thực tế.
Tôi đã đặt video về các khối đồ chơi ở cuối cùng và sẽ xóa sau. (Để rút ngắn tổng thời lượng bài giảng...)
Đây là phần cơ bản nhẹ nhàng, nên những ai đã học phần thực hành 2 thì không cần xem.
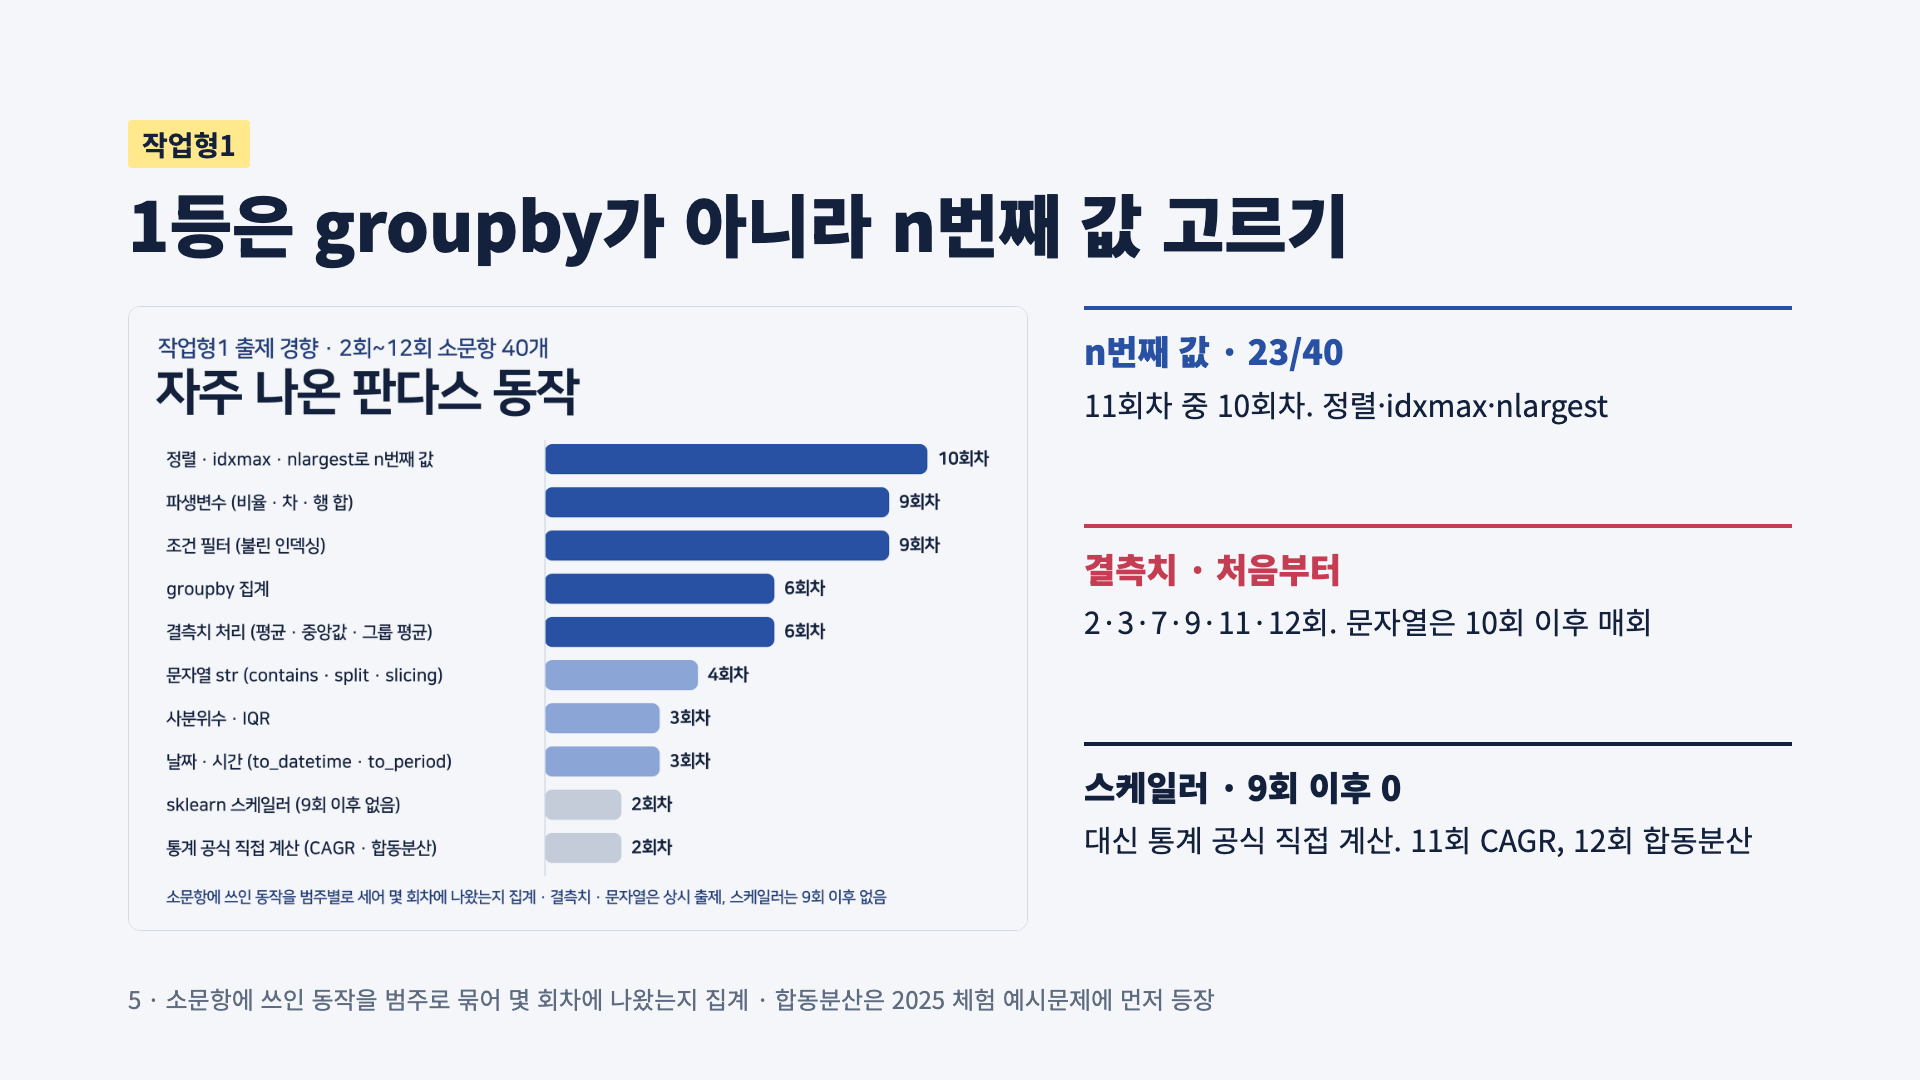
Đã thêm video xu hướng được tổng hợp từ các đề thi trước đây từ lần 2 đến lần 12.
Hãy cùng xem qua một cách nhẹ nhàng nhé. Cố lên!
Xin chào.
Thử thách Chuẩn bị lần thứ 13 dự kiến sẽ mở vào đầu tháng 10.
Tuy nhiên, vì phiếu giảm giá chỉ có thể được phát hành sau khi thử thách mở đăng ký, nên chúng tôi sẽ phát hành riêng vào thời gian sau.
Dù đã nhận được thông báo mở thử thách
, vui lòng kiểm tra phiếu giảm giá được thông báo sau này tại mục "Tin tức mới" ở đây rồi hãy tham gia.Xin cảm ơn. 😊
Xin chào các học viên!
Đã hoàn tất việc khôi phục các dạng câu hỏi có trong đề thi thực hành Kỳ thi lần thứ 12 Chứng chỉ Phân tích Dữ liệu lớn. 🎉
Chúc tất cả những bạn đang chuẩn bị cho kỳ thi lần thứ 13 đều đạt kết quả tốt.
Hãy cùng nhau nỗ lực hết mình cho đến khi đỗ nhé! 💪
Xin chào.
Hạn đăng ký kỳ thi viết lần thứ 13 dự kiến sẽ kết thúc vào 18:00 ngày mai (thứ Sáu, 8/7).
Trong trường hợp thời hạn hiệu lực của kỳ thi viết (2 năm) đã hết và bạn phải thi lại, vui lòng đăng ký trong thời hạn quy định.
▶ Thời gian đăng ký: 10:00 ngày 03.08 (Thứ Hai) ~ 18:00 ngày 07.08 (Thứ Sáu)
Cảm ơn bạn.
Có rất nhiều bạn đã thắc mắc về việc xử lý
0 điểm cho bài thi thực hành loại 2, nên tôi đã
tổng hợp nội dung lại thành một video.Kết luận: (Vì không thể biết chắc về việc xử lý các giá trị dự đoán âm nên) hãy cùng chờ đợi kết quả công bố nhé!!
Kiểm tra cuối cùng dành cho bạn, người đã nỗ lực hết mình nhưng vẫn cảm thấy bất an
[Chung]
help(),dir(),__all__không thể giải quyết được mọi thứ đâu.
Khi thực sự sử dụng lần đầu tại phòng thi sẽ cảm thấy bỡ ngỡ hơn bạn nghĩ, vì vậy hãy thử kiểm tra trước trong môi trường thi nhé.Nếu bàn phím, chuột hoặc máy tính tại chỗ ngồi có vấn đề, hãy yêu cầu đổi chỗ ngay sau thời gian kiểm tra và trước khi bắt đầu bài thi. Nếu cố thay đổi giữa chừng, tâm lý của bạn sẽ bị dao động. Tốt nhất là nên giải quyết triệt để các vấn đề ngay từ đầu.
Bạn có thể nộp bài nhiều lần, nhưng sau khi nộp một lần, hệ thống sẽ hiển thị chữ "Đã nộp". Khi trạng thái hiển thị là "Đã nộp", bạn có thể định nộp lại nhưng rồi lại quên mất, vì vậy hãy lưu ý nhé. Hệ thống sẽ chấm điểm dựa trên bản nộp cuối cùng.
[Loại thực hành 1]
Nhấp vào tab Dữ liệu ở phía trên → 'Chế độ xem cơ bản', sau đó hãy kiểm tra bằng cách sử dụng
Ctrl + Fđể tìm kiếm. Bạn có thể tiếp cận với tâm thế "ít nhất mình sẽ giải quyết nó bằng mắt".Chỉ cần đáp án đúng là được. Mã nguồn quá trình như thế nào không quan trọng. Đáp án chính xác được ưu tiên hơn mã nguồn gọn gàng.
Hãy chắc chắn nắm vững
groupbytrước khi đi thi. Ngay cả khi không dùng đến pivot table, việc tổng hợp dữ liệu theo nhóm cũng rất khó để giải quyết bằng mắt thường. Điều này nhất định phải được xử lý bằng mã code.Hãy nhớ kiểm tra kỹ các chỉ dẫn về làm tròn, số chữ số thập phân và chuyển đổi số nguyên trong kết quả. Có rất nhiều trường hợp bỏ lỡ đáp án đúng ngay trước mắt do quên
round()hoặc nhầm số chữ số thập phân.Đối với các bài toán sắp xếp, hãy chú ý kỹ đến thứ tự tăng dần/giảm dần và cách xử lý khi có cùng giá trị. Sẽ rất tốt nếu bạn lưu ý cả tùy chọn
ascendingcủasort_values()và việc có sử dụngreset_indexhay không.Khi lọc điều kiện, hãy sử dụng chính xác
&,|và dấu ngoặc đơn. Trongdf[(điều kiện 1) & (điều kiện 2)], nếu thiếu dấu ngoặc đơn sẽ xảy ra lỗi.
Nếu đưa điều kiện vào biến cond thì không cần dấu ngoặc đơn.Dữ liệu ngày tháng nên được chuyển đổi bằng
pd.to_datetime()để có thể sử dụng các thuộc tính như.dt.year,.dt.month,.dt.dayofweek, v.v. Các bài toán thống kê theo thứ hoặc theo tháng thường xuyên xuất hiện.Làm quen với các hàm thường dùng:
value_counts(),nlargest()/nsmallest(),quantile()(vấn đề ngoại lệ IQR),fillna(),drop_duplicates(),astype().Đối với vấn đề giá trị ngoại lệ và giá trị thiếu, hãy tuân thủ đúng tiêu chuẩn mà đề bài đưa ra (IQR, độ lệch chuẩn, điều kiện cụ thể). Tuyệt đối không tự ý áp dụng theo cách riêng của bản thân.
[Dạng bài tập thực hành 2]
Nếu bạn chỉ định sử dụng một mô hình duy nhất, chỉ cần huấn luyện toàn bộ bằng lightgbm là xong.
Nếu bạn định sử dụng từ 2~3 mô hình trở lên, hãy kiểm tra rồi so sánh chúng. Nếu cảm thấy lúng túng về chỉ số đánh giá, bạn có thể so sánh bằng những chỉ số mà bản thân biết chắc chắn.
Hãy tập trung vào rf, lgb, xgb. Rất hiếm khi các mô hình khác ngoài những loại này cho hiệu suất tốt hơn.
Sau khi so sánh xong, tôi cũng khuyên bạn nên huấn luyện lại với toàn bộ dữ liệu. Tùy vào từng loại dữ liệu mà hiệu quả sẽ khác nhau nên không thể đảm bảo chắc chắn việc cải thiện hiệu suất, nhưng nếu dữ liệu mất cân bằng nghiêm trọng như kỳ thứ 11, tôi sẽ chọn huấn luyện với toàn bộ dữ liệu.
Đối với dữ liệu mất cân bằng, việc điều chỉnh tham số hay siêu tham số không nhất thiết sẽ làm tăng hiệu suất. Ngược lại, đôi khi hiệu suất tốt nhất lại đạt được ở các giá trị mặc định. Nếu bạn cảm thấy không yên tâm, hãy sử dụng thiết lập mặc định + huấn luyện trên toàn bộ dữ liệu.
Đừng quá tốn sức vào việc điều chỉnh tỷ lệ (scaling). Vì rf, lgb, xgb đều là các mô hình thuộc hệ cây nên sự thay đổi hiệu suất theo việc scaling là rất nhỏ.
Hãy đảm bảo các cột của tập train/test khớp nhau. Việc mã hóa và tiền xử lý phải được áp dụng đồng nhất cho cả train và test. Có những lỗi thường gặp như số lượng cột bị thay đổi sau khi thực hiện One-hot Encoding. Mặc dù điều này chưa từng xuất hiện trong các đề thi trước đây nhưng nó có trong các câu hỏi ví dụ, vì vậy bạn cũng cần biết cách xử lý bằng cách gộp tập train và test lại với nhau.
Hãy xác định rõ đối tượng dự đoán (target). Hãy đọc kỹ đề bài xem yêu cầu xác suất (
predict_proba) hay yêu cầu lớp (predict). Nếu là roc_auc thì thường là xác suất, còn f1·accuracy thì thường là lớp.Hãy tuân thủ đúng định dạng nộp bài như đề bài yêu cầu. Từ tên tệp, tên cột cho đến việc có bao gồm chỉ mục hay không (
index=False). Nếu sai số lượng hàng, bạn sẽ nhận 0 điểm.Nếu thiếu thời gian, đừng quá tham vọng cải thiện hiệu suất mà hãy dùng lightgbm chạy cho xong để hoàn thành file nộp bài trước. Hoàn thành là ưu tiên hàng đầu, tối ưu hóa tính sau.
[Phần thi thực hành 3]
Bài thi thực hành loại 3 không phải là dạng câu hỏi tự luận hay phân tích tự do kiểu "hãy phân tích đi". Bạn chỉ cần thực hiện chính xác các phân tích mà đề bài yêu cầu. Không cần thiết phải tự ý thêm thắt hay mở rộng phân tích. Chỉ tìm và xuất ra đúng giá trị được hỏi. Đừng thực hiện những phân tích mà đề bài không hỏi, ví dụ như kiểm tra xem phương sai có đồng nhất hay không.
Việc sử dụng C() tùy thuộc vào loại phân tích. Có rất nhiều người bị nhầm lẫn ở phần này.
Phân tích biến lượng (ANOVA): Sử dụng
C()cho tất cả các biến độc lập (biến phân loại).Ví dụ:
ols('y ~ C(집단)', data=df), nếu là ANOVA hai chiều thìols('y ~ C(A) + C(B) + C(A):C(B)', data=df)Bởi vì đây là phân tích xem xét sự khác biệt giữa các nhóm, nên biến độc lập phải được xử lý dưới dạng biến phân loại.
Hồi quy / Hồi quy Logistic: Đừng tùy tiện sử dụng
C().Các biến liên tục (số) thì để nguyên như vậy.
Chỉ khi trong đề bài có đề cập rõ ràng rằng "biến này trông giống như số nhưng hãy xử lý nó như một biến phân loại" thì mới sử dụng
C().Không được tự ý phán đoán!
Hãy nhất định học cách đọc summary(). Trong hồi quy và hồi quy logistic, bạn phải có khả năng tìm và trả lời ngay các giá trị như hệ số (coef), p-value, R-squared, tỉ số chênh (odds ratio) từ bảng kết quả. Đừng bỏ cuộc, ít nhất hãy xem kỹ phần này trước khi đi thi.
Kiểm định giả thuyết có mấu chốt là so sánh giá trị p-value với mức ý nghĩa (thường là 0.05). Nếu p < 0.05 thì bác bỏ giả thuyết không (H0). Hãy xác định rõ trong đề bài đâu là giả thuyết không và đâu là giả thuyết đối.
Hãy chọn chính xác loại kiểm định (kiểm định t một mẫu/mẫu cặp/mẫu độc lập, Chi-square (tính độc lập/độ phù hợp), phân tích tương quan, ANOVA, v.v.) dựa trên đề bài để đưa ra quyết định.
Hãy chú ý kỹ đến số chữ số thập phân và hướng dẫn làm tròn tương tự như trong Bài thi thực hành 3. Đừng quên xuất kết quả bằng lệnh
print()nữa nhé.
Mỗi dạng bài thực hành có thể xuất hiện 1-2 câu hỏi khó. Đừng chỉ tập trung vào mỗi câu đó mà lãng phí hết thời gian. Hãy tạm gác những câu khó sang một bên, tập trung kiểm tra kỹ và ghi điểm ở những câu khác mà bạn có thể làm được. Mục tiêu không phải là điểm tuyệt đối. Mục tiêu là 70 điểm, là vượt qua kỳ thi!Chỉ với những gì bạn đã chuẩn bị cho đến nay là đã đủ để nằm trong nhóm đỗ rồi. Cố lên!! Chúc bạn làm bài thi thật tốt! 💪
Tôi luôn ủng hộ việc thi đỗ của các bạn. - Toigeunhu-ttanjit -