

섹션2. DNN 이진분류 part2에서 pos, neg에 대해 질문드립니다.
안녕하세요?
강의를 듣다가 궁금한 것이 생겨서 여쭤봅니다.
섹션2. DNN 이진분류 part2강의에서
정상, 비정상 데이터를 아래 사진과 같이 나타내셨는데

비율적인 면에서 neg보다 pos가 먼저와야 하는게 아닌가 싶어서 질문드립니다.
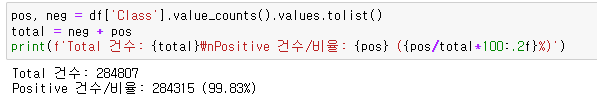
모델 훈련 결과에서 큰 차이는 없었지만
혹시 위와 같이 neg, pos로 지정하신 이유가 있는지 궁금합니다.
감사합니다.
回答 1
0
positive 는 우리가 찾고자 하는 label 을 말 합니다. 암에 걸린 환자, 부도날 고객, 포르노 영상, 불법침입자 등이 예가 되겠습니다. 따라서 일반적으로 비정상 데이터를 검출하려고 모델을 만드는 것 이므로 positive로 지정합니다. 반면 별 관심 없는 정상 데이터는 negative 로 지정합니다.
좋은 질문 감사합니다.
수강기간 연장문의
0
2
1
작업형 2 질문
0
16
2
확통 강의 개강일
1
15
1
강의 연장 관련하여 문의드립니다.
0
19
1
섹션7 자료 다운로드
0
21
2
작업형 1 연습문제 Section12
0
20
2
수강기간 연장 문의
0
30
1
안녕하세요, 혹시 수강기간 연장이 가능할까요?
0
30
2
판다스 강의자료는 어디서 받을 수 있나요?
0
29
2
작업형2 모의고사3 자료 업데이트 요청
0
35
4
수강 연장가능여부 문의드립니다!
0
40
2
수강기간 연장 문의드립니다!
0
37
2
최빈값
0
39
2
수강 가이드라인
0
33
2
교재 문의
0
49
3
수강 연장 가능 여부 문의
0
57
2
오토인코더+ Knn, SVC 로 해석하는경우
0
133
3
VAE 모델 loss 계산하는 부분 오류
0
325
2
features 수가 작을 경우의 Dense 설정 문의
0
273
1
라이브러리 임포트 시 경고 메세지가 뜹니다.
0
621
1
오토인코더를 특성 추출기로 사용하는 방법에 대해 질문
0
300
1
실습: 001. Imbalanced Dataset Sampling 관련 질문
0
1249
2
깃헙의 자료와 강의의 실습 내용이 다릅니다.
0
313
1
SMOTE를 활용한 데이터 생성
0
594
1