

넷플릭스 크롤링
824
投稿した質問数 7
넷플릭스 크롤링 시스템 만들 때 섹션별로 영화 제목 따내는 거는 아무 오류 없었는데 섹션리스트 중에서 첫번째 섹션에서 프li태그 이용해서 프로그램 이미지랑 제목 html로 따낼 때
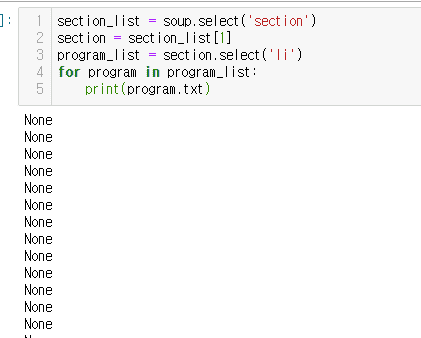
section_list = soup.select('section')
section = section_list[1]
program_list = section.select('li')
for program in program_list:
print(program.txt)
이렇게 했더니 결과가 None으로 여러개가 계속 나와요 뭐가 문제일까요??
回答 2
1
너무 늦은 시간인데 빠른 답변 감사합니다!! 고3인데 학교에서 한 활동 중 웹 크롤링으로 한 활동이 있었는데 기억이 잘 안나서 공부를 어떻게 다시해야될지 찾고있었는데 이 강의를 발견하고 나서 너무 든든하고 이해도 잘하고 있습니다!! 끝까지 완강하고 후기 더 남기겠습니다. 질문 생기면 또 할게요!!
0
안녕하세요.
마지막 print 명령어에서
program.txt 로 되어있는 부분을
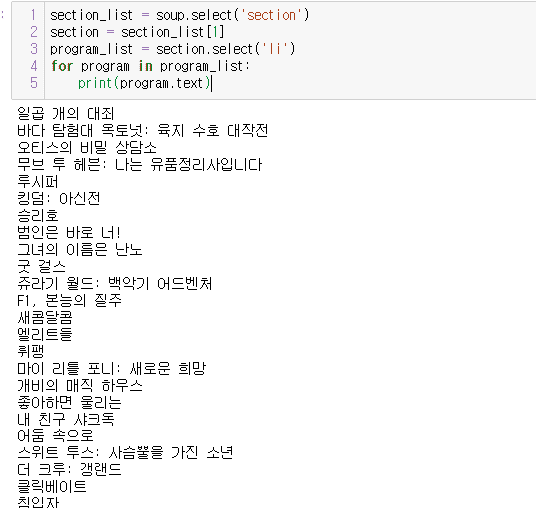
program.text
으로 변경하시면 될 것 같네요.
[기존]
[변경후 : txt → text ]
강사님 강의 더 주세요
0
5
0
작업형 2 제출하는 법
0
22
2
Section 5. 문자열 슬라이싱, 파생변수, 평균값 질문 드립니다.
0
15
1
예시문제 작업형2(ver. 2025)
0
20
2
수강 연장 문의드립니다.
0
24
2
강사님 강의 잘듣고있습니다! 오류관련 질문 드립니다!
0
21
0
예시문제 작업형2(ver. 2025)
0
28
2
작업형2 모의문제 3 질문
0
30
1
오랜만에 인사드립니다 강사님
0
22
1
강의신청 후
0
39
1
안녕하세요 강사님 문의사항이 있습니다
0
32
1
수강 연장 문의
0
67
4
수강기간 연장 관련 문의
0
52
2
작업형2모의문제3_updated2026.10
0
71
2
안녕하세요. 수강연장 신청드립니다
0
47
2
코랩 링크
0
45
2
사용자설정에 claude 설정들은 어떻게 하나요??
0
54
1
윈도우 환경에서는 진행이 어렵나요?
0
60
1
시계열 분석 문의
0
41
1
작업형2 모의문제2 updated 2026.10 질문
0
59
2
카이제곱 독립성검정 질문합니다.
0
48
2
크롤링 페이지 접속 에러
0
581
1
넷플릭스 크롤링 데이터 엑셀파일저장
0
689
1
유튜브 크롤링 방법
0
438
1