


1억까지 더하기, C 0.027초 파이썬 4.4초: 160배는 어디서 생길까
같은 일을 하는 코드 두 개가 있습니다.
long sum_to(long n) {
    long s = 0;
    for (long i = 1; i <= n; i++) {
        s += i;
    }
    return s;
}
def sum_to(n):
    s = 0
    i = 1
    while i <= n:
        s += i
        i += 1
    return s
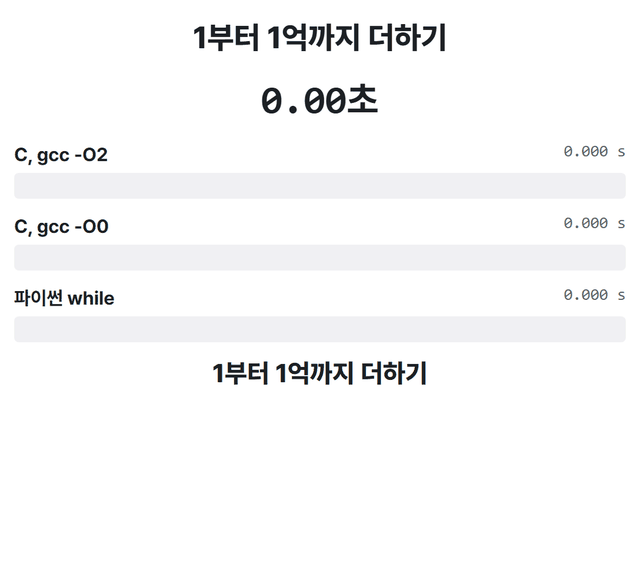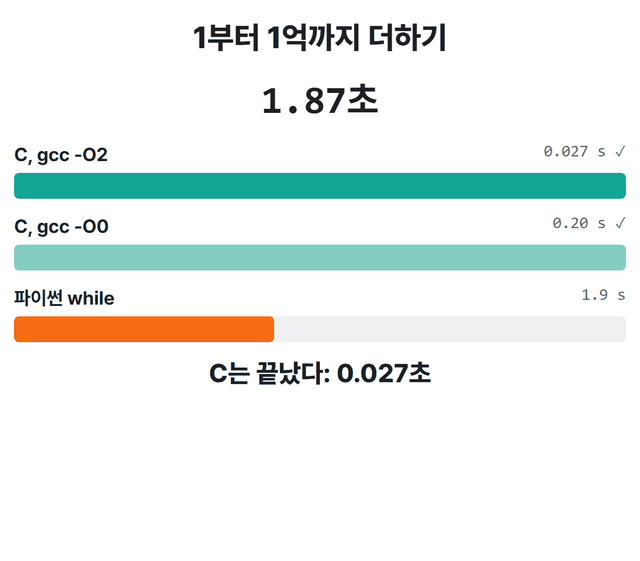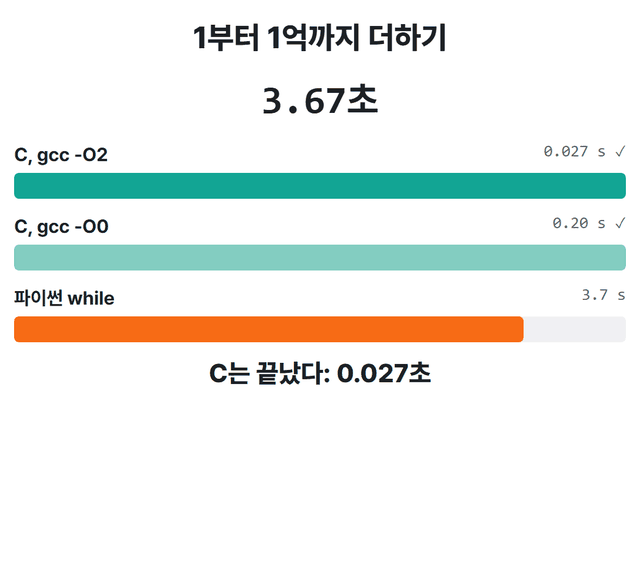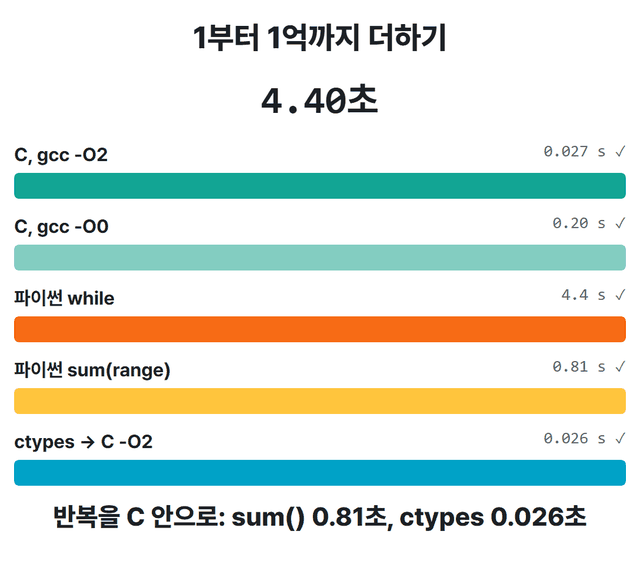
n = 1억으로 한 컴퓨터(인텔 12세대 Core i5)에서 재 보면 이렇습니다. 두세 번 재어 비슷하게 나온 값입니다.
C, gcc -O2: 0.027초 (수 하나에 0.27 ns)
C, gcc -O0: 0.20초 (수 하나에 2.0 ns)
파이썬 3.14
while: 4.4초 (수 하나에 44 ns)
약 160배입니다. "파이썬은 인터프리터라서 느리다"는 말은 많이 듣지만, 그게 컴퓨터 안에서 정확히 어떤 차이인지는 막연한 경우가 많습니다. 이 글에서는 gcc가 실제로 만든 기계어와 파이썬 3.14가 실제로 만든 바이트코드를 나란히 놓고, 그 160배가 어디서 오는지 따라가 봅니다.
1. C -O0: 한 바퀴에 명령어 6개
gcc -O0 -c sum.c 로 최적화 없이 컴파일하고 objdump -d -M intel sum.o 로 풀어 본 결과입니다(gcc 13.3, x86-64, 리눅스).
   0:  push   rbp
   1:  mov    rbp,rsp
   4:  mov    QWORD PTR [rbp-0x18],rdi      ; n을 메모리에
   8:  mov    QWORD PTR [rbp-0x10],0x0      ; s = 0
  10:  mov    QWORD PTR [rbp-0x8],0x1       ; i = 1
  18:  jmp    27
  1a:  mov    rax,QWORD PTR [rbp-0x8]       ; rax = i
  1e:  add    QWORD PTR [rbp-0x10],rax      ; s += i
  22:  add    QWORD PTR [rbp-0x8],0x1       ; i += 1
  27:  mov    rax,QWORD PTR [rbp-0x8]       ; rax = i
  2b:  cmp    rax,QWORD PTR [rbp-0x18]      ; i와 n 비교
  2f:  jle    1a                            ; i <= n 이면 1a로
  31:  mov    rax,QWORD PTR [rbp-0x10]      ; 돌려줄 값 s
  35:  pop    rbp
  36:  ret
읽는 법은 간단합니다. rax, rbp 같은 이름은 CPU 안의 작은 칸인 레지스터이고, [rbp-0x8]처럼 대괄호는 메모리 주소입니다. 이 함수는 i를 [rbp-0x8], s를 [rbp-0x10], n을 [rbp-0x18]에 두었습니다. cmp는 두 값을 비교해 결과를 플래그에 남기고, jle는 그 플래그를 보고 "작거나 같으면" 1a로 돌아갑니다. C의 for는 기계어에는 없습니다. 비교와 조건 점프가 있을 뿐입니다.
반복 한 바퀴는 1a부터 2f까지 명령어 6개이고, 그중 5개가 메모리를 읽거나 씁니다. 그래도 수 하나에 2 ns입니다.
2. C -O2: 명령어 4개로 수 두 개
같은 코드를 -O2로 컴파일하면 반복 부분이 이렇게 바뀝니다.
  28:  lea    rdx,[rdx+rax*2+0x1]   ; s += i + (i+1)
  2d:  add    rax,0x2               ; i += 2
  31:  cmp    rax,rcx               ; rcx = n + 1
  34:  jne    28
두 가지가 달라졌습니다. 첫째, i와 s가 메모리를 떠나 레지스터(rax, rdx)에만 삽니다. 둘째, 한 바퀴에 i와 i+1을 한꺼번에 더합니다. i + (i+1) = 2i + 1이고, 원래 주소 계산용인 lea 명령어 하나가 이 곱하기·더하기를 해 줍니다. 그래서 명령어 4개로 수 두 개, -O0보다 약 7배 빠릅니다.
여기까지가 "C는 빠르다"의 정체입니다. 덧셈 하나가 거의 기계어 명령어 2개입니다.
3. 파이썬: 기계어가 되지 않는다
파이썬 함수는 기계어로 바뀌지 않습니다. 대신 바이트코드라는, 파이썬 전용 가상 기계의 명령어가 됩니다. python -m dis 나 dis.dis(sum_to) 로 볼 수 있습니다(파이썬 3.14.2).
  9   L1:     LOAD_FAST_BORROW_LOAD_FAST_BORROW 32 (i, n)
              COMPARE_OP              58 (bool(<=))
              POP_JUMP_IF_FALSE       20 (to L2)
              NOT_TAKEN

 10           LOAD_FAST_BORROW_LOAD_FAST_BORROW 18 (s, i)
              BINARY_OP               13 (+=)
              STORE_FAST               1 (s)

 11           LOAD_FAST_BORROW         2 (i)
              LOAD_SMALL_INT           1
              BINARY_OP               13 (+=)
              STORE_FAST               2 (i)
              JUMP_BACKWARD           25 (to L1)
반복 한 바퀴가 목록상 12개입니다. 그런데 3.14에서는 POP_JUMP_IF_FALSE가 점프하지 않을 때 바로 뒤의 NOT_TAKEN을 건너뛰기 때문에, 실제로 실행되는 것은 한 바퀴 11개입니다(CPython 소스 Python/bytecodes.c에서 확인할 수 있습니다). n = 1억이면 바이트코드 약 11억 개를 실행하고, 4.4초를 나누면 하나에 약 4 ns입니다.
이 바이트코드를 실행하는 것은 CPU가 아니라 C로 짠 프로그램, CPython의 평가 루프(Python/ceval.c)입니다. 하는 일은 "다음 바이트코드를 꺼낸다 → 그 명령어를 처리하는 C 코드로 간다 → 처리한다 → 다시 꺼낸다"의 반복입니다. 그러니 바이트코드 하나마다 꺼내고 분기하는 기계어가 덧붙고, 그 C 코드 자체도 수십 개의 기계어 명령어입니다.
이 바이트코드는 레지스터 대신 값 스택에 값을 올렸다 내리는 스택 머신이라, s += i 하나가 "s와 i를 스택에 올리고 → 더하고 → s에 저장"의 세 단계가 됩니다.
4. 덧셈 한 번이 하는 일
C의 long은 8바이트이고 레지스터 하나에 쏙 들어갑니다. 파이썬의 int는 객체입니다. sys.getsizeof(1)은 28바이트입니다(참조 수 8 + 타입 정보 8 + 크기 8 + 30비트짜리 자리 하나 4). 파이썬의 정수는 크기 제한이 없어서 10¹⁰⁰도 담을 수 있는데, 그 대가가 이 구조입니다.
그래서 BINARY_OP (+=) 한 번은 대략 이런 일을 합니다.
두 값의 타입을 확인한다(정수인가? 실수인가? 직접 만든 클래스인가?)
정수 덧셈 함수를 찾아 부른다
결과를 담을 새 정수 객체를 만든다
참조 수를 늘리고 줄이고, 안 쓰는 객체를 정리한다
C에서는 add 한 줄이던 일입니다.
파이썬도 가만있지는 않습니다. 3.11부터는 같은 자리에서 정수끼리만 더해지면 BINARY_OP를 BINARY_OP_ADD_INT로 바꿔 끼우는 특수화를 합니다(dis.dis(sum_to, adaptive=True)로 보입니다). −5부터 256까지의 작은 정수는 미리 만들어 둔 객체를 같이 씁니다. 3.14에는 실험적인 JIT도 들어 있어서 PYTHON_JIT=1로 켜면 이 반복문은 3.1초가 됩니다. 그래도 객체를 다루는 일은 그대로라 C와의 거리는 여전히 큽니다.
5. 그럼 파이썬에서는 어떻게?
답은 "반복을 C 안으로 보낸다"입니다.
파이썬
while: 4.4초파이썬
for i in range: 3.0초sum(range(1, n+1)): 0.81초ctypes로 C 함수(-O2) 부르기: 0.026초
sum()은 바이트코드 없이 C로 짠 반복문이 돌고, ctypes는 파이썬에서 C 함수를 한 번 부르고 반복은 전부 C가 합니다. NumPy가 빠른 이유도 같습니다. 반복이 C 안에 있기 때문입니다.
직접 해 보기
위의 C 코드를 sum.c로, 파이썬 코드를 sum_py.py로 저장하고 리눅스나 윈도의 WSL에서 그대로 따라 할 수 있습니다.
gcc -O0 -c sum.c -o sum.O0.o && objdump -d -M intel sum.O0.o
gcc -O2 -c sum.c -o sum.O2.o && objdump -d -M intel sum.O2.o
python3 -c "import dis; from sum_py import sum_to; dis.dis(sum_to)"
파이썬 버전이 다르면 바이트코드 이름이 조금 다르게 나옵니다(3.12에는 LOAD_FAST_BORROW가 없고 LOAD_FAST입니다).
한 줄씩 실행해 보는 강의
이 글은 「디버거 교실의 어셈블리어: 기계어에서 C와 파이썬까지」라는 무료 강의의 요약입니다. 10교시 동안 바이트와 2의 보수, 레지스터와 플래그, 메모리와 주소 지정, 조건 점프, 스택과 call/ret, 호출 규약, 컴파일·링크, 최적화, 버퍼 넘침과 방어(카나리·NX·ASLR), 그리고 파이썬 바이트코드와 정수 객체까지 갑니다. 본문의 어셈블리는 모두 gcc가 실제로 만든 출력이고, 브라우저 속 작은 x86-64 흉내 CPU가 그 명령어를 한 줄씩 실행하며 레지스터와 스택을 보여 줍니다(실습대 21개).
강의 전체(1–3교시는 가입 없이, 4교시부터는 무료 회원): reflexkr-blue-grass.reflex.run/courses/assembly
이 질문으로 시작하는 1교시: reflexkr-blue-grass.reflex.run/courses/assembly/lesson-1
답변 0