

질문이 있습니다.
377
1 câu hỏi đã được viết
질문1.
8강. 작업유형2-모형학습 및 평가의
11번. 예측값저장에서
'id' : y_test.index를 하면서
11강, 13강에서의
11번. 파일저장에서는
'id' : X_test.index를 하는데
8강과 (11강,13강)의 차이는 왜 발생하는 것인가요?
질문2.
11강.연습문제1(분류)-모형학습 및 평가의
11번. 파일저장에서
result = result.iloc[:, 1]을 해서
1번째 열을 가지고 오는데,
13강 연습문제2(회귀)-모형학습 및 평가의
11번. 파일저장에서
result = result.iloc[:, 0]에서는
왜 0번째 열을 가지고 오는 것인가요?
Câu trả lời 1
0
안녕하세요.
답변을 수시로 파악하지 않아, 늦게 작성해드린 점 죄송합니다.
우선 질문을 2가지 주셨는데요,
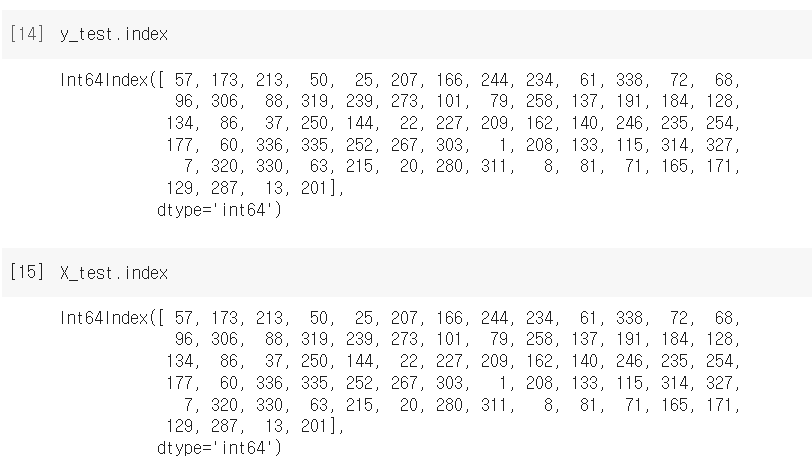
첫째, y_test.index, X_test.index 왜 다르게 하는건지?
샘플 데이터의 경우 분석 과정에서 종속변수 y와 독립변수 x를 분리하다 보니,
실제 y_test.index, X_test.index의 값이 같습니다.
따라서 어떤 것을 사용해도 무관합니다.
실제 시험에서는 "test 데이터의 실제 index 번호와 동일하게 제출파일을 만드는 것"이
중요하다고 할 수 있습니다.
둘째, result = result.iloc[:, 1], result = result.iloc[:, 0] 왜 다른지?
분류 예측 문제에서 predict_proba로 각각의 확률을 표현하다 보니 한개의 열이 더 생성됩니다.
그러나 회귀모형에서는 예측된 값만 나오다 보니, 형태가 달라서 그런 것이구요.
실제로 예측한 값을 살펴보시면 다름을 알 수 있습니다.
이상입니다.
인프런 질의응답을 수시로 파악하고 있지는 않습니다. :)
실기 문제 구성?
0
32
0
실기 문제 구성?
0
33
0
DataSet 다운 받는 방법
0
56
1
구름IDE 서비스 종료 이후 학습환경
0
226
1
10강 연습문제
0
214
1
VotingClassifier Hard 사용
0
150
1
구름IDE 실행 도움 요청
0
207
1
질문입니다 RandomForestClassifier
0
221
1
질문!
0
386
1
데이터 더미화 에러발생 질문.
0
371
1
많은 컬럼과 많은 결측치를 가지는 데이터
0
253
1
Dataset은 어디서 받을 수 있나요?
0
437
1
mpg 데이터셋 위치
0
385
1
교육영상 4강. 작업유형1-문제(1)에 대한 코드는 어디서 받을 수 있나요?
0
422
1
단순평균(1집단)T-test 1번 풀이
0
531
2
강의자료 문의
1
600
1
구름IDE 실행불가문제 ㅠㅠ
0
874
2
제7강 작업유형2-데이터 전처리: LabelEncoder 문법
0
492
1
5강 작업유형1-문제 2 질문입니다
0
450
1
7강 코드 질문드립니다
0
466
1
14강 실전 문제 카테고리 항목문의
0
451
1
작업2유형 문의
0
522
1
데이터셋 분리와 관련하여 질문이 있습니다.
0
499
1
5강의 작업형1-2문제 오류
0
513
1